Data Engineering
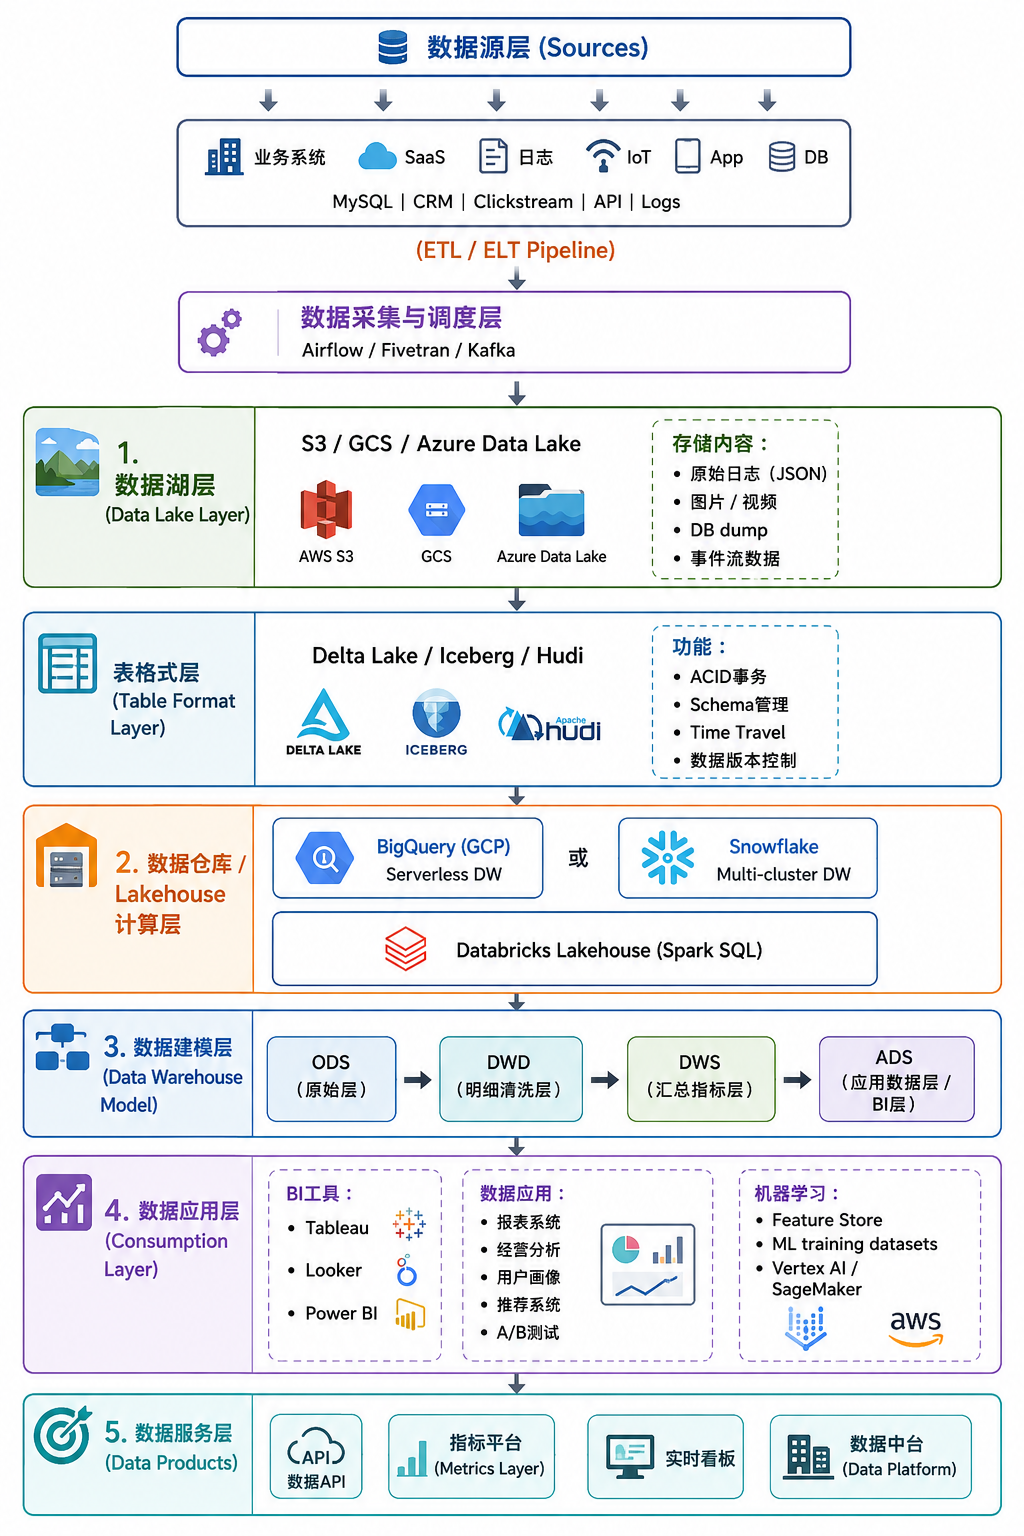
核心思想:数据工程把”原始数据”层层转化为可分析、可信赖、可服务的数据资产。Data Warehouse、Data Lake、Lakehouse 是三种不同的实现思路。
Data Warehouse
数据仓库是一种专门用于存储和分析历史数据的系统,主要目的是支持企业做报表、分析和决策,而不是处理日常业务操作。
DWH 三层结构(ODS / DWD / DWS)
- ODS(Operational Data Store)操作数据层:原始数据的”临时收集区”
- 特点:数据刚从业务系统进来;基本不清洗;结构和源系统几乎一致;可能有重复或脏数据
- 作用:作为”原始备份”,保证数据可追溯
- DWD(Data Warehouse Detail)明细数据层:清洗 + 规范化后的明细数据
- 做了:去重、修正错误数据、统一格式(时间 / 币种 / 字段命名)、建立统一数据模型
- 作用:提供干净的数据,支持后续分析
- DWS(Data Warehouse Service / Summary)汇总层:面向业务的聚合层
- 做了:按维度聚合(天 / 月 / 用户 / 商品)、计算指标(GMV、转化率)、面向 BI 报表
- 作用:直接给业务 / 管理层使用
ETL 怎么把数据送进仓库
三步流水线,每一步只做一件事:
- Extract(抽取):从各种系统拿数据——MySQL(订单)、CRM(用户)、日志系统(点击)
- Transform(转换):在中间层做加工——去重、数据清洗、类型转换、业务规则计算
- Load(加载):把数据写入数据仓库(ODS / DWD)
实际数据流:
业务系统
   ↓
ETL 工具(Airflow / Spark)
   ↓
ODS(原始层)
   ↓
DWD(清洗层)
   ↓
DWS(汇总层)
   ↓
BI 报表(Tableau / Looker)
BigQuery / Snowflake 扮演什么角色
都是现代云数据仓库(Data Warehouse)本体。你可以直接在里面建 ODS / DWD / DWS 表。
- 计算引擎:以前 ETL 在外部工具做,现在可以在 BigQuery / Snowflake 内部用 SQL 完成清洗、聚合、建模
- 分析查询:直接支持 BI 报表、SQL 查询、实时分析
这就是 ELT 模式——先 Load 到仓库,再在仓库内 Transform。
Data Lake
数据湖是一个用来存放所有原始数据(结构化 / 非结构化 / 半结构化)的大型存储系统,不要求提前整理或建模。
数据湖的特点
| 维度 | 数据湖 |
|---|---|
| 数据状态 | 原始数据(Raw Data) |
| 数据类型 | 任意(表格 / JSON / 日志 / 图片 / 视频) |
| 是否清洗 | 不要求 |
| Schema | 读取时再定义(Schema on Read) |
| 目的 | 存 + 未来可能分析 |
经典问题:Data Swamp(数据沼泽)
如果没有治理——数据乱放、没结构、找不到数据、不知道谁在用——数据湖就会变成”垃圾堆”。
常见实现
数据湖本身不是一个软件,而是一个”架构概念”。常见组合:
- 存储层:Amazon S3(最典型)、Google Cloud Storage、Azure Data Lake Storage
- 计算引擎:Apache Spark、Trino / Presto、Hive
Lakehouse
Lakehouse = 数据湖的存储 + 数据仓库的能力。
Lakehouse 的核心目标是在一个系统里同时做:
- BI 分析(像数据仓库)
- AI / ML 训练(像数据湖)
- 实时数据处理
Delta Lake 和 Apache Iceberg 是两种”让数据湖变成可靠数据库”的开源格式标准,分别由 Databricks 和 Apache 主导。
Delta Lake
让”数据湖变得像数据库一样可靠”——解决数据湖的原生问题(没有事务、数据容易乱、没有版本控制等)。
- ACID 事务(像数据库):写入不丢数据、并发安全、不会写坏表
-
Time Travel(时间回溯):支持查询历史版本
SELECT * FROM table VERSION AS OF 10; - Schema 管理:自动检测结构变化、防止脏数据写入
- Upsert 支持:支持 UPDATE / DELETE(数据湖原来做不到)
Apache Iceberg
更通用、更开放的数据湖表格式:
- 高性能查询优化:Partition pruning(减少扫描)、Metadata 优化
- Schema Evolution(更强):可以随意加 / 改字段,不破坏历史数据
- 更好的大规模支持:PB 级数据、多引擎兼容(Spark / Flink / Trino)
Delta Lake / Iceberg 不是”存储”,而是让数据湖变成数据库的”规则层”。