Agent Dev
初识智能体与发展
-
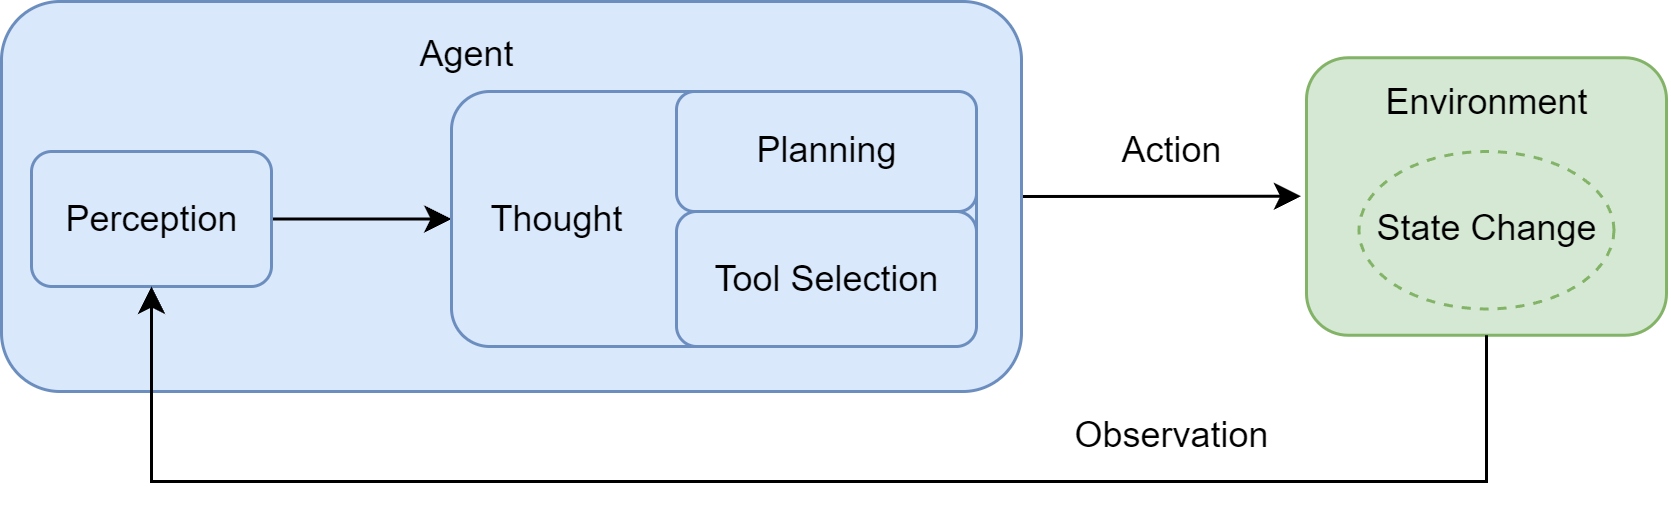
在人工智能领域,智能体被定义为任何能够通过传感器(Sensors)感知其所处环境(Environment),并自主地通过执行器(Actuators)采取行动(Action)以达成特定目标的实体。
-
智能体设计中一个核心权衡:追求速度的反应性(Reactivity)与追求最优解的规划性(Deliberation)之间的平衡
-
PEAS 模型: 性能度量(Performance)、环境(Environment)、执行器(Actuators)和传感器(Sensors)
-
Agent loop
大语言模型基础
- RNN是为了打破固定窗口的限制(N-gram),核心是为了给网络增加“记忆能力”。由于RNN的长期依赖问题(Long term dependency problem),出现了LSTM。
Transformer
import torch
import torch.nn as nn
import math

# --- 占位符模块,将在后续小节中实现 ---
class PositionalEncoding(nn.Module):
    """位置编码模块"""
    def forward(self, x):
        pass

class MultiHeadAttention(nn.Module):
    """多头注意力机制模块"""
    def forward(self, query, key, value, mask):
        pass

class PositionWiseFeedForward(nn.Module):
    """位置前馈网络模块"""
    def forward(self, x):
        pass

# --- 编码器核心层 ---
class EncoderLayer(nn.Module):
    def __init__(self, d_model, num_heads, d_ff, dropout):
        super(EncoderLayer, self).__init__()
        self.self_attn = MultiHeadAttention()       # 待实现
        self.feed_forward = PositionWiseFeedForward()  # 待实现
        self.norm1 = nn.LayerNorm(d_model)
        self.norm2 = nn.LayerNorm(d_model)
        self.dropout = nn.Dropout(dropout)

    def forward(self, x, mask):
        # 残差连接与层归一化将在 3.1.2.4 节中详细解释
        # 1. 多头自注意力
        attn_output = self.self_attn(x, x, x, mask)
        x = self.norm1(x + self.dropout(attn_output))
        # 2. 前馈网络
        ff_output = self.feed_forward(x)
        x = self.norm2(x + self.dropout(ff_output))
        return x

# --- 解码器核心层 ---
class DecoderLayer(nn.Module):
    def __init__(self, d_model, num_heads, d_ff, dropout):
        super(DecoderLayer, self).__init__()
        self.self_attn = MultiHeadAttention()       # 待实现
        self.cross_attn = MultiHeadAttention()      # 待实现
        self.feed_forward = PositionWiseFeedForward()  # 待实现
        self.norm1 = nn.LayerNorm(d_model)
        self.norm2 = nn.LayerNorm(d_model)
        self.norm3 = nn.LayerNorm(d_model)
        self.dropout = nn.Dropout(dropout)

    def forward(self, x, encoder_output, src_mask, tgt_mask):
        # 1. 掩码多头自注意力 (对自己)
        attn_output = self.self_attn(x, x, x, tgt_mask)
        x = self.norm1(x + self.dropout(attn_output))
        # 2. 交叉注意力 (对编码器输出)
        cross_attn_output = self.cross_attn(x, encoder_output, encoder_output, src_mask)
        x = self.norm2(x + self.dropout(cross_attn_output))
        # 3. 前馈网络
        ff_output = self.feed_forward(x)
        x = self.norm3(x + self.dropout(ff_output))
        return x
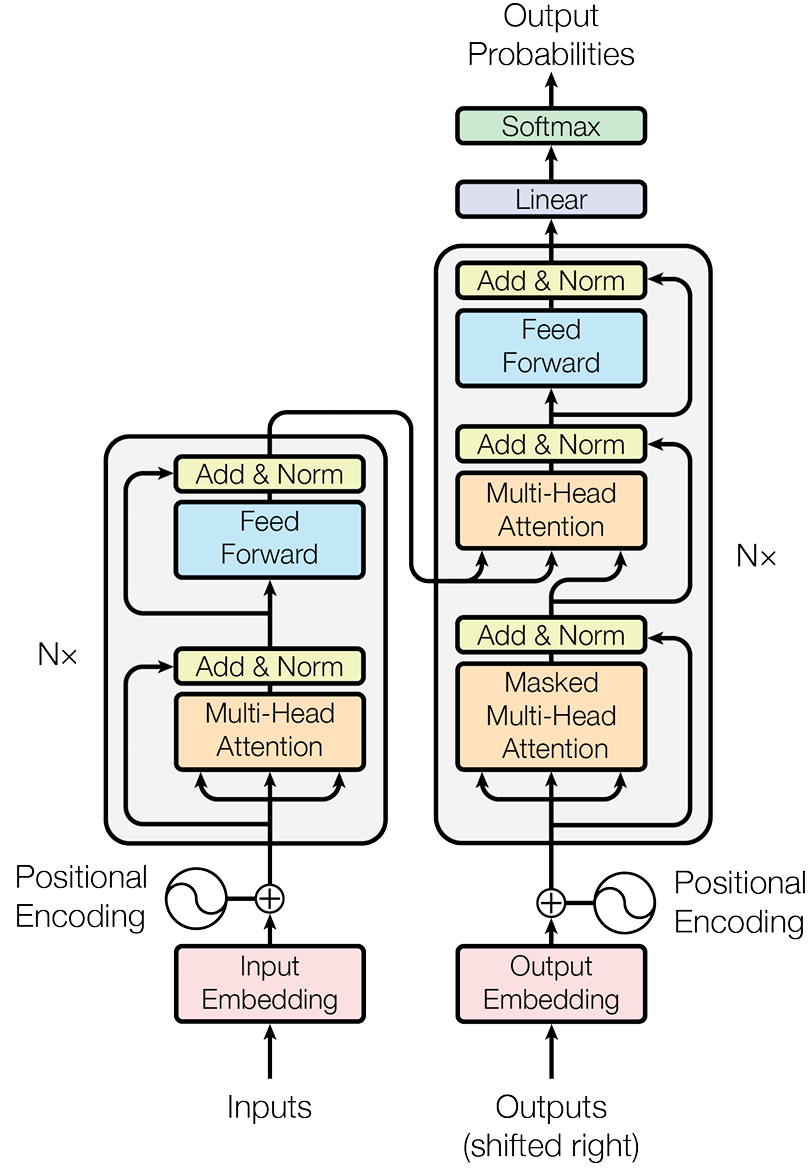
- 宏观上是一个encoder-decoder架构。编码器 (Encoder) :任务是“理解”输入的整个句子。它会读取所有输入词元,最终为每个词元生成一个富含上下文信息的向量表示。解码器 (Decoder) :任务是“生成”目标句子。它会参考自己已经生成的前文,并“咨询”编码器的理解结果,来生成下一个词。
Decoder-Only 架构
现在巨大参数的大模型都基于这个架构
- 掩码自注意力 (Masked Self-Attention)
在自注意力机制计算出注意力分数矩阵(即每个词对其他所有词的关注度得分)之后,但在进行 Softmax 归一化之前,模型会应用一个“掩码”。这个掩码会将所有位于当前位置之后(即目前尚未观测到)的词元对应的分数,替换为一个非常大的负数。当这个带有负无穷分数的矩阵经过 Softmax 函数时,这些位置的概率就会变为 0。这样一来,模型在计算任何一个位置的输出时,都从数学上被阻止了去关注它后面的信息。这种机制保证了模型在预测下一个词时,能且仅能依赖它已经见过的、位于当前位置之前的所有信息,从而确保了预测的公平性和逻辑的连贯性。
Prompt Engineer
- 在文本生成中,当同时设置 Top-p、Top-k 和温度系数时,这些参数会按照分层过滤的方式协同工作,其优先级顺序为:温度调整→Top-k→Top-p。温度调整整体分布的陡峭程度,Top-k 会先保留概率最高的 k 个候选,然后 Top-p 会从 Top-k 的结果中选取累积概率≥p 的最小集合作为最终的候选集。不过,通常 Top-k 和 Top-p 二选一即可,若同时设置,实际候选集为两者的交集。 需要注意的是,如果将温度设置为 0,则 Top-k 和 Top-p 将变得无关紧要,因为最有可能的 Token 将成为下一个预测的 Token;如果将 Top-k 设置为 1,温度和 Top-p 也将变得无关紧要,因为只有一个 Token 通过 Top-k 标准,它将是下一个预测的 Token。
文本分词
在将自然语言文本喂给大语言模型之前,必须先将其转换成模型能够处理的数字格式。这个将文本序列转换为数字序列的过程,就叫做分词 (Tokenization) 。分词器 (Tokenizer) 的作用,就是定义一套规则,将原始文本切分成一个个最小的单元,我们称之为词元 (Token) 。
字节对编码 (Byte-Pair Encoding, BPE) 是最主流的子词分词算法之一,GPT系列模型就采用了这种算法。其核心思想非常简洁,可以理解为一个“贪心”的合并过程:
- 初始化:将词表初始化为所有在语料库中出现过的基本字符。
- 迭代合并:在语料库上,统计所有相邻词元对的出现频率,找到频率最高的一对,将它们合并成一个新的词元,并加入词表。
- 重复:重复第 2 步,直到词表大小达到预设的阈值。
案例演示: 假设我们的迷你语料库是 {“hug”: 1, “pug”: 1, “pun”: 1, “bun”: 1},并且我们想构建一个大小为 10 的词表。BPE 的训练过程可以用下表1来表示:
表1 BPE 算法合并过程示例
| 步骤 | 最高频词元对 | 频率 | 合并为 | 新增词元 | 当前词表大小 |
|---|---|---|---|---|---|
| 初始化 | - | - | - | {h, u, g, p, n, b} | 6 |
| 合并 1 | u, g | 2 | ug | ug | 7 |
| 合并 2 | u, n | 2 | un | un | 8 |
| 合并 3 | p, ug | 1 | pug | pug | 9 |
| 合并 4 | p, un | 1 | pun | pun | 10 |
训练结束后,词表大小达到 10,我们就得到了新的分词规则。现在,对于一个未见过的词 “bug”,分词器会先查找 “bug” 是否在词表中,发现不在;然后查找 “bu”,发现不在;最后查找 “b” 和 “ug”,发现都在,于是将其切分为 [‘b’, ‘ug’]。
分词器对开发者的意义
理解分词算法的细节并非目的,但作为智能体的开发者,理解分词器的实际影响十分重要,这直接关系到智能体的性能、成本和稳定性:
- 上下文窗口限制:模型的上下文窗口(如 8K, 128K)是以 Token 数量计算的,而不是字符数或单词数。同样一段话,在不同语言(如中英文)或不同分词器下,Token 数量可能相差巨大。精确管理输入长度、避免超出上下文限制是构建长时记忆智能体的基础。
- API 成本:大多数模型 API 都是按 Token 数量计费的。了解你的文本会被如何分词,是预估和控制智能体运行成本的关键一步。
- 模型表现的异常:有时模型的奇怪表现根源在于分词。例如,模型可能很擅长计算 2 + 2,但对于 2+2(没有空格)就可能出错,因为后者可能被分词器视为一个独立的、不常见的词元。同样,一个词因为首字母大小写不同,也可能被切分成完全不同的 Token 序列,从而影响模型的理解。在设计提示词和解析模型输出时,考虑到这些“陷阱”有助于提升智能体的鲁棒性。
智能体经典范式构建
-
ReAct:我们构建了一个能与外部世界交互的 ReAct 智能体。通过“思考-行动-观察”的动态循环,它成功地利用搜索引擎回答了自身知识库无法覆盖的实时性问题。其核心优势在于环境适应性和动态纠错能力,使其成为处理探索性、需要外部工具输入的任务的首选。
-
Plan-and-Solve:我们实现了一个先规划后执行的 Plan-and-Solve 智能体,并利用它解决了需要多步推理的数学应用题。它将复杂的任务分解为清晰的步骤,然后逐一执行。其核心优势在于结构性和稳定性,特别适合处理逻辑路径确定、内部推理密集的任务。
-
Reflection (自我反思与迭代):我们构建了一个具备自我优化能力的 Reflection 智能体。通过引入“执行-反思-优化”的迭代循环,它成功地将一个效率较低的初始代码方案,优化为了一个算法上更优的高性能版本。其核心价值在于能显著提升解决方案的质量,适用于对结果的准确性和可靠性有极高要求的场景。
基于低代码平台的agent构建
Coze 以其零代码的友好体验和丰富的插件生态脱颖而出。通过”每日AI简报”案例,我们体验了如何通过拖拽式配置快速整合多源信息,并一键发布到多个主流平台。Coze 特别适合非技术背景用户和需要快速验证创意的场景,但其不支持 MCP 和无法导出标准化配置文件的局限性也值得注意。
Dify 作为开源的企业级平台,展现了全栈式开发能力。”超级智能体个人助手”案例涵盖了日常问答、文案优化、多模态生成、数据分析和 MCP 工具集成等多个模块,充分展示了 Dify 在复杂业务场景下的强大编排能力。其丰富的插件市场(8000+)、灵活的部署方式和企业级安全特性,使其成为专业开发者和企业团队的理想选择。然而,相对陡峭的学习曲线和在高并发场景下的性能挑战也需要权衡。
n8n 则以其独特的”连接”能力开辟了另一条路径。通过”智能邮件助手”案例,我们看到了如何将 AI 能力无缝嵌入到复杂的业务自动化流程中。n8n 的 AI Agent 节点将模型、记忆和工具高度整合,配合其数百个预置节点,能够实现高度定制化的自动化方案。其支持私有化部署的特性对注重数据安全的企业尤为重要。但内置存储的非持久性和版本控制的不成熟,在生产环境中需要额外的工程化处理。
通过三个平台的对比实践,我们可以得出以下选型建议:
- 快速原型验证、非技术用户: 优先选择 Coze
- 企业级应用、复杂业务逻辑: 优先选择 Dify
- 深度业务集成、自动化流程: 优先选择 n8n
框架开发实践
-
AutoGen:AutoGen 的核心思想是通过对话实现协作[1]。它将多智能体系统抽象为一个由多个“可对话”智能体组成的群聊。开发者可以定义不同角色(如 Coder, ProductManager, Tester),并设定它们之间的交互规则(例如,Coder 写完代码后由 Tester 自动接管)。任务的解决过程,就是这些智能体在群聊中通过自动化消息传递,不断对话、协作、迭代直至最终目标达成的过程。
-
AgentScope:AgentScope 是一个专为多智能体应用设计的、功能全面的开发平台[2]。它的核心特点是易用性和工程化。它提供了一套非常友好的编程接口,让开发者可以轻松定义智能体、构建通信网络,并管理整个应用的生命周期。其内置的消息传递机制和对分布式部署的支持,使其非常适合构建和运维复杂、大规模的多智能体系统。
-
CAMEL:CAMEL 提供了一种新颖的、名为角色扮演 (Role-Playing) 的协作方法[3]。其核心理念是,我们只需要为两个智能体(例如,AI研究员 和 Python程序员)设定好各自的角色和共同的任务目标,它们就能在“初始提示 (Inception Prompting)”的引导下,自主地进行多轮对话,相互启发、相互配合,共同完成任务。它极大地降低了设计多智能体对话流程的复杂度。
-
LangGraph:作为 LangChain 生态的扩展,LangGraph 另辟蹊径,将智能体的执行流程建模为图 (Graph)[4]。在传统的链式结构中,信息只能单向流动。而 LangGraph 将每一步操作(如调用LLM、执行工具)定义为图中的一个节点 (Node),并用边 (Edge) 来定义节点之间的跳转逻辑。这种设计天然支持循环 (Cycles),使得实现如 Reflection 这样的迭代、修正、自我反思的复杂工作流变得异常简单和直观。
构建agent框架
OOP继承
面向对象编程(OOP)中的继承(Inheritance),指的是:一个类可以“继承”另一个类的属性和方法,并在此基础上扩展或修改功能。
class Animal:
    def eat(self):
        print("动物在吃东西")
class Dog(Animal):  # Dog 继承 Animal
    def bark(self):
        print("狗在叫")
d = Dog()
d.eat()   # 继承来的方法
d.bark()  # 自己的方法
方法重写(Override)
子类可以“改写”父类的方法:
class Animal:
    def sound(self):
        print("动物发出声音")
class Cat(Animal):
    def sound(self):  # 重写
        print("猫在喵喵叫")
抽象基类(Abstract Base Class,ABC)
只定义规范,不允许直接创建对象的类
from abc import ABC, abstractmethod
class Animal(ABC):
    @abstractmethod
    def eat(self):
        pass
抽象基类常用于:
- 插件系统(plugin system)
- 框架设计(framework)
- API 统一接口
- 数据库驱动接口
- 支付系统接口(支付宝/微信/银行卡)
在代码运行前强制统一行为,避免大型系统中的接口混乱和隐性错误。
AST白名单
AST = Abstract Syntax Tree(抽象语法树)
把代码变成“结构树”,而不是字符串。
a = 1 + 2
**↓↓↓↓↓↓↓↓↓↓↓↓↓↓↓↓↓↓↓↓↓↓↓↓↓↓↓**
Assign
 ├── Name(a)
 └── BinOp(+)
     ├── Constant(1)
     └── Constant(2)
白名单 = “只允许某些 AST 节点类型通过”,也就是说:
- 允许:加减乘除、变量、函数调用
- 禁止:文件操作、系统命令、导入危险模块等
记忆与检索
向量检索(Vector Search / Vector Retrieval)
"苹果手机" → [0.12, -0.55, 0.98, ...]
"iPhone"   → [0.10, -0.50, 1.02, ...]
流程
-
文本变向量(Embedding)
用BERT / OpenAI Embedding / 向量模型
- 存入向量数据库
- FAISS
- Milvus
- Pinecone
- Weaviate
- 查询时也变向量
- 计算相似度
向量检索就是:把“文字理解问题”变成“空间距离问题”
RAG chunking调优
指的是在 RAG(Retrieval-Augmented Generation,检索增强生成)系统里,对“文档切块方式(chunking)”进行优化,让检索更准、回答更可靠。
主要调 4 个关键参数:
- chunk size(块大小)
例如:- 200 tokens (太碎)
- 500 tokens (常用)
- 1000+ tokens (偏大)
目标:刚好包含一个完整语义单元。
-
overlap(重叠)
比如:
Chunk1: 1-500
Chunk2: 400-900
作用是防止句子被切断以及保留上下文连续性。 -
Split strategy(切分策略)
常见方式有1.按固定长度,2.按段落/标题,3.按语义切分 -
metadata
给chunk加标签:标题,章节,来源,时间。RAG 流程中 chunking 的位置
文档 → chunking → embedding → 向量库 → 检索 → LLM生成答案
上下文工程
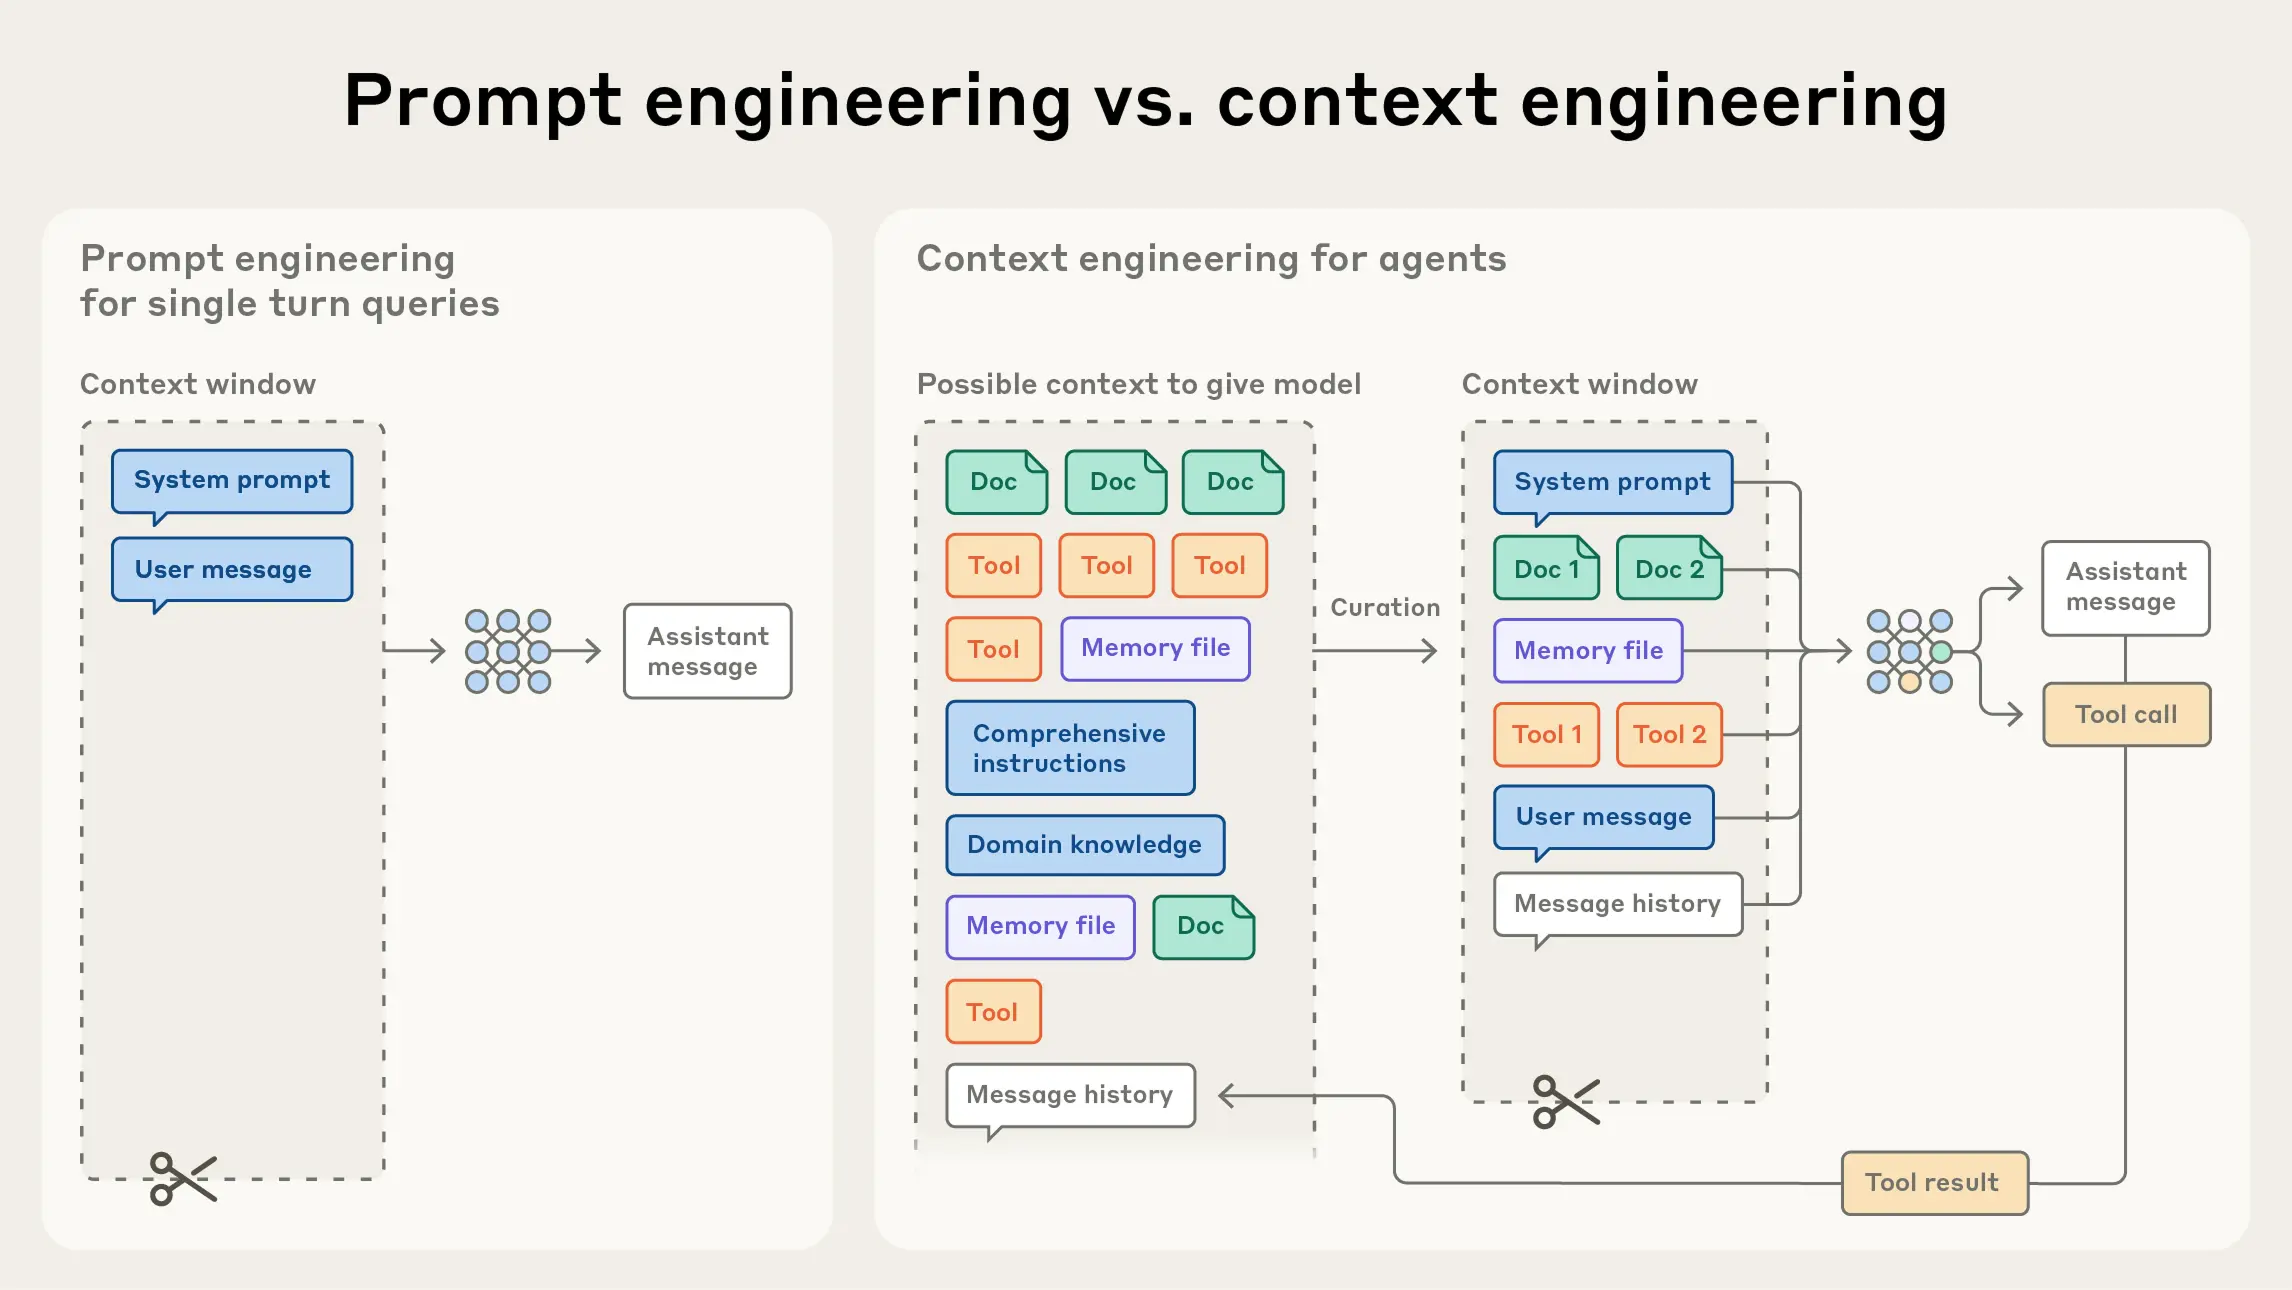
上下文工程是在推理阶段,如何策划与维护“最优的信息集合(tokens)”,其中不仅包含提示本身,还包含其他会进入上下文窗口的一切信息。
在“有限注意力预算”的约束下,优秀的上下文工程目标是:用尽可能少、但高信号密度的 tokens,最大化获得期望结果的概率。
落实到实践中,建议围绕以下组件开展工程化建设:
- 系统提示(System Prompt):语言清晰、直白,信息层级把握在“刚刚好”的高度。常见两极误区:
- 过度硬编码:在提示中写入复杂、脆弱的 if-else 逻辑,长期维护成本高、易碎。
- 过于空泛:只给出宏观目标与泛化指引,缺少对期望输出的具体信号或假定了错误的“共享上下文”。 建议将提示分区组织(
、工具指引、输出描述等),用 XML/Markdown 分隔。无论格式如何,追求的是**能完整勾勒期望行为的“最小必要信息集”**(“最小”并不等于“最短”)。先用最好的模型在最小提示上试跑,再依据失败模式增补清晰的指令与示例。
- 工具(Tools):工具定义了智能体与信息/行动空间的契约,必须促进效率:既要返回token 友好的信息,又要鼓励高效的智能体行为。工具应当:
- 职责单一、相互低重叠,接口语义清晰;
- 对错误鲁棒;
- 入参描述明确、无歧义,充分发挥模型擅长的表达与推理能力。 常见失败模式是“臃肿工具集”:功能边界模糊,导致“选哪个工具”这一决策本身就含混不清。如果人类工程师都说不准用哪个工具,别指望智能体做得更好。精心甄别一个“最小可行工具集(MVTS)”往往能显著提升长期交互中的稳定性与可维护性。
- 示例(Few-shot):始终推荐提供示例,但不建议把“所有边界条件”的罗列一股脑塞进提示。请精挑细选一组多样且典型的示例,直接画像“期望行为”。对 LLM 而言,好的示例胜过千言万语。
总的指导思想是:信息充分但紧致。如图所示,是进入运行时的动态检索。
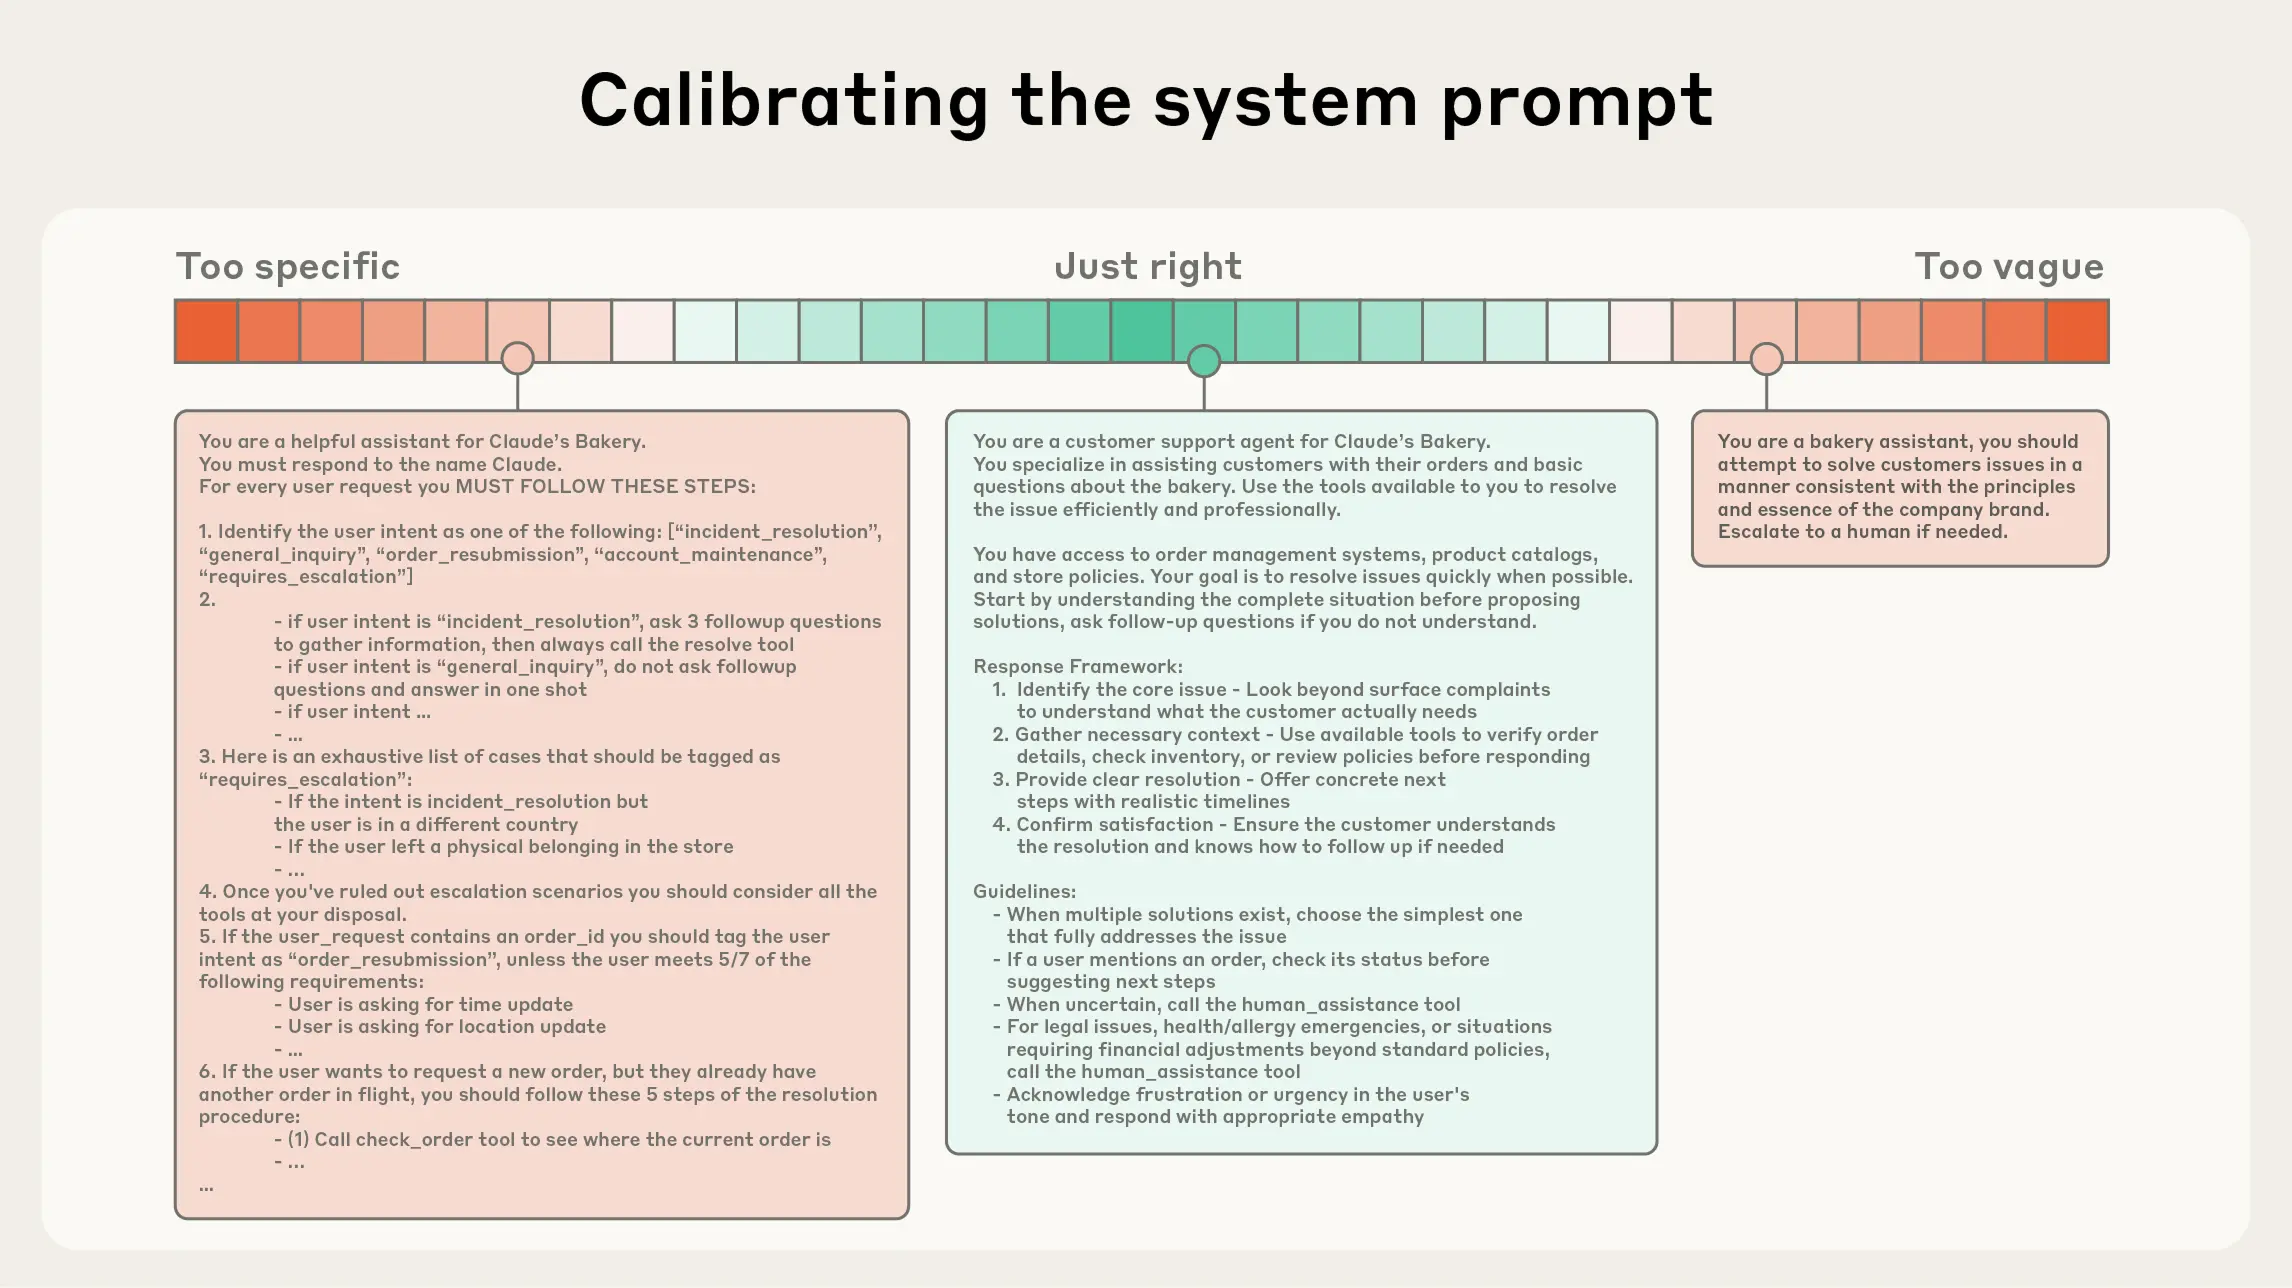
面向长时程任务的上下文工程
- 压缩整合(Compaction)
- 定义:当对话接近上下文上限时,对其进行高保真总结,并用该摘要重启一个新的上下文窗口,以维持长程连贯性。
- 实践:让模型压缩并保留架构性决策、未解决缺陷、实现细节,丢弃重复的工具输出与噪声;新窗口携带压缩摘要 + 最近少量高相关工件(如“最近访问的若干文件”)。
- 调参建议:先优化召回(确保不遗漏关键信息),再优化精确度(剔除冗余内容);一种安全的“轻触式”压缩是对“深历史中的工具调用与结果”进行清理。
- 结构化笔记(Structured note-taking)
- 定义:也称“智能体记忆”。智能体以固定频率将关键信息写入上下文外的持久化存储,在后续阶段按需拉回。
- 价值:以极低的上下文开销维持持久状态与依赖关系。例如维护 TODO 列表、项目 NOTES.md、关键结论/依赖/阻塞项的索引,跨数十次工具调用与多轮上下文重置仍能保持进度与一致性。
- 说明:在非编码场景中同样有效(如长期策略性任务、游戏/仿真中的目标管理与统计计数)。结合第八章的 MemoryTool,可轻松实现文件式/向量式的外部记忆并在运行时检索。
- 子代理架构(Sub-agent architectures)
- 思想:由主代理负责高层规划与综合,多个专长子代理在“干净的上下文窗口”中各自深挖、调用工具并探索,最后仅回传凝练摘要(常见 1,000–2,000 tokens)。
- 好处:实现关注点分离。庞杂的搜索上下文留在子代理内部,主代理专注于整合与推理;适合需要并行探索的复杂研究/分析任务。
- 经验:公开的多智能体研究系统显示,该模式在复杂研究任务上相较单代理基线具有显著优势。
方法取舍可以遵循以下经验法则:
- 压缩整合:适合需要长对话连续性的任务,强调上下文的“接力”。
- 结构化笔记:适合有里程碑/阶段性成果的迭代式开发与研究。
- 子代理架构:适合复杂研究与分析,能从并行探索中获益。
即便模型能力持续提升,“在长交互中维持连贯性与聚焦”仍是构建强健智能体的核心挑战。谨慎而系统的上下文工程将长期保持其关键价值。
ContextBuilder
在构建 ContextBuilder 之前,我们首先需要明确其设计目标和核心价值。一个优秀的上下文管理系统应该解决以下几个关键问题:
- 统一入口:将”获取(Gather)- 选择(Select)- 结构化(Structure)- 压缩(Compress)”抽象为可复用流水线,减少在 Agent 实现中的重复模板代码。这种统一的接口设计让开发者无需在每个 Agent 中重复编写上下文管理逻辑。
- 稳定形态:输出固定骨架的上下文模板,便于调试、A/B 测试与评估。我们采用了分区组织的模板结构:
- [Role & Policies]:明确 Agent 的角色定位和行为准则
- [Task]:当前需要完成的具体任务
- [State]:Agent 的当前状态和上下文信息
- [Evidence]:从外部知识库检索的证据信息
- [Context]:历史对话和相关记忆
- [Output]:期望的输出格式和要求
- 预算守护:在 token 预算内尽量保留高价值信息,对超限上下文提供兜底压缩策略。这确保了即使在信息量巨大的场景下,系统也能稳定运行。
- 最小规则:不引入来源/优先级等分类维度,避免复杂度增长。实践表明,基于相关性和新近性的简单评分机制,在大多数场景下已经足够有效。
核心数据结构
ContextBuilder 的实现依赖两个核心数据结构,它们定义了系统的配置和信息单元。
(1)ContextPacket:候选信息包
from dataclasses import dataclass
from typing import Optional, Dict, Any
from datetime import datetime
@dataclass
class ContextPacket:
    """候选信息包
    Attributes:
        content: 信息内容
        timestamp: 时间戳
        token_count: Token 数量
        relevance_score: 相关性分数(0.0-1.0)
        metadata: 可选的元数据
    """
    content: str
    timestamp: datetime
    token_count: int
    relevance_score: float = 0.5
    metadata: Optional[Dict[str, Any]] = None
    def __post_init__(self):
        """初始化后处理"""
        if self.metadata is None:
            self.metadata = {}
        # 确保相关性分数在有效范围内
        self.relevance_score = max(0.0, min(1.0, self.relevance_score))
ContextPacket 是系统中信息的基本单元。每个候选信息都会被封装为一个 ContextPacket,包含内容、时间戳、token 数量和相关性分数等核心属性。这种统一的数据结构简化了后续的选择和排序逻辑。
(2)ContextConfig:配置管理
@dataclass
class ContextConfig:
    """上下文构建配置
    Attributes:
        max_tokens: 最大 token 数量
        reserve_ratio: 为系统指令预留的比例(0.0-1.0)
        min_relevance: 最低相关性阈值
        enable_compression: 是否启用压缩
        recency_weight: 新近性权重(0.0-1.0)
        relevance_weight: 相关性权重(0.0-1.0)
    """
    max_tokens: int = 3000
    reserve_ratio: float = 0.2
    min_relevance: float = 0.1
    enable_compression: bool = True
    recency_weight: float = 0.3
    relevance_weight: float = 0.7
    def __post_init__(self):
        """验证配置参数"""
        assert 0.0 <= self.reserve_ratio <= 1.0, "reserve_ratio 必须在 [0, 1] 范围内"
        assert 0.0 <= self.min_relevance <= 1.0, "min_relevance 必须在 [0, 1] 范围内"
        assert abs(self.recency_weight + self.relevance_weight - 1.0) < 1e-6, \
            "recency_weight + relevance_weight 必须等于 1.0"
ContextConfig 封装了所有可配置的参数,使得系统行为可以灵活调整。特别值得注意的是 reserve_ratio 参数,它确保系统指令等关键信息始终有足够的空间,不会被其他信息挤占。
GSSC流水线详情
ContextBuilder 的核心是 GSSC(Gather-Select-Structure-Compress)流水线,它将上下文构建过程分解为四个清晰的阶段。让我们深入了解每个阶段的实现细节。
(1)Gather:多源信息汇集
第一阶段是从多个来源汇集候选信息。这个阶段的关键在于容错性和灵活性。
def _gather(
    self,
    user_query: str,
    conversation_history: Optional[List[Message]] = None,
    system_instructions: Optional[str] = None,
    custom_packets: Optional[List[ContextPacket]] = None
) -> List[ContextPacket]:
    """汇集所有候选信息
    Args:
        user_query: 用户查询
        conversation_history: 对话历史
        system_instructions: 系统指令
        custom_packets: 自定义信息包
    Returns:
        List[ContextPacket]: 候选信息列表
    """
    packets = []
    # 1. 添加系统指令(最高优先级,不参与评分)
    if system_instructions:
        packets.append(ContextPacket(
            content=system_instructions,
            timestamp=datetime.now(),
            token_count=self._count_tokens(system_instructions),
            relevance_score=1.0,  # 系统指令始终保留
            metadata={"type": "system_instruction", "priority": "high"}
        ))
    # 2. 从记忆系统检索相关记忆
    if self.memory_tool:
        try:
            memory_results = self.memory_tool.run({
                "action": "search",
                "query": user_query,
                "limit": 10,
                "min_importance": 0.3
            })
            # 解析记忆结果并转换为 ContextPacket
            memory_packets = self._parse_memory_results(memory_results, user_query)
            packets.extend(memory_packets)
        except Exception as e:
            print(f"[WARNING] 记忆检索失败: {e}")
    # 3. 从 RAG 系统检索相关知识
    if self.rag_tool:
        try:
            rag_results = self.rag_tool.run({
                "action": "search",
                "query": user_query,
                "limit": 5,
                "min_score": 0.3
            })
            # 解析 RAG 结果并转换为 ContextPacket
            rag_packets = self._parse_rag_results(rag_results, user_query)
            packets.extend(rag_packets)
        except Exception as e:
            print(f"[WARNING] RAG 检索失败: {e}")
    # 4. 添加对话历史(仅保留最近的 N 条)
    if conversation_history:
        recent_history = conversation_history[-5:]  # 默认保留最近 5 条
        for msg in recent_history:
            packets.append(ContextPacket(
                content=f"{msg.role}: {msg.content}",
                timestamp=msg.timestamp if hasattr(msg, 'timestamp') else datetime.now(),
                token_count=self._count_tokens(msg.content),
                relevance_score=0.6,  # 历史消息的基础相关性
                metadata={"type": "conversation_history", "role": msg.role}
            ))
    # 5. 添加自定义信息包
    if custom_packets:
        packets.extend(custom_packets)
    print(f"[ContextBuilder] 汇集了 {len(packets)} 个候选信息包")
    return packets
这个实现展示了几个重要的设计考虑:
- 容错机制:每个外部数据源的调用都被 try-except 包裹,确保单个源的失败不会影响整体流程
- 优先级处理:系统指令被标记为高优先级,确保始终被保留
- 历史限制:对话历史只保留最近的几条,避免上下文窗口被历史信息占据
(2)Select:智能信息选择
第二阶段是根据相关性和新近性对候选信息进行评分和选择。这是整个流水线的核心,直接决定了最终上下文的质量。
def _select(
    self,
    packets: List[ContextPacket],
    user_query: str,
    available_tokens: int
) -> List[ContextPacket]:
    """选择最相关的信息包
    Args:
        packets: 候选信息包列表
        user_query: 用户查询(用于计算相关性)
        available_tokens: 可用的 token 数量
    Returns:
        List[ContextPacket]: 选中的信息包列表
    """
    # 1. 分离系统指令和其他信息
    system_packets = [p for p in packets if p.metadata.get("type") == "system_instruction"]
    other_packets = [p for p in packets if p.metadata.get("type") != "system_instruction"]
    # 2. 计算系统指令占用的 token
    system_tokens = sum(p.token_count for p in system_packets)
    remaining_tokens = available_tokens - system_tokens
    if remaining_tokens <= 0:
        print("[WARNING] 系统指令已占满所有 token 预算")
        return system_packets
    # 3. 为其他信息计算综合分数
    scored_packets = []
    for packet in other_packets:
        # 计算相关性分数(如果尚未计算)
        if packet.relevance_score == 0.5:  # 默认值,需要重新计算
            relevance = self._calculate_relevance(packet.content, user_query)
            packet.relevance_score = relevance
        # 计算新近性分数
        recency = self._calculate_recency(packet.timestamp)
        # 综合分数 = 相关性权重 × 相关性 + 新近性权重 × 新近性
        combined_score = (
            self.config.relevance_weight * packet.relevance_score +
            self.config.recency_weight * recency
        )
        # 过滤低于最小相关性阈值的信息
        if packet.relevance_score >= self.config.min_relevance:
            scored_packets.append((combined_score, packet))
    # 4. 按分数降序排序
    scored_packets.sort(key=lambda x: x[0], reverse=True)
    # 5. 贪心选择:按分数从高到低填充,直到达到 token 上限
    selected = system_packets.copy()
    current_tokens = system_tokens
    for score, packet in scored_packets:
        if current_tokens + packet.token_count <= available_tokens:
            selected.append(packet)
            current_tokens += packet.token_count
        else:
            # Token 预算已满,停止选择
            break
    print(f"[ContextBuilder] 选择了 {len(selected)} 个信息包,共 {current_tokens} tokens")
    return selected
def _calculate_relevance(self, content: str, query: str) -> float:
    """计算内容与查询的相关性
    使用简单的关键词重叠算法。在生产环境中,可以替换为向量相似度计算。
    Args:
        content: 内容文本
        query: 查询文本
    Returns:
        float: 相关性分数(0.0-1.0)
    """
    # 分词(简单实现,可以使用更复杂的分词器)
    content_words = set(content.lower().split())
    query_words = set(query.lower().split())
    if not query_words:
        return 0.0
    # Jaccard 相似度
    intersection = content_words & query_words
    union = content_words | query_words
    return len(intersection) / len(union) if union else 0.0
def _calculate_recency(self, timestamp: datetime) -> float:
    """计算时间近因性分数
    使用指数衰减模型,24小时内保持高分,之后逐渐衰减。
    Args:
        timestamp: 信息的时间戳
    Returns:
        float: 新近性分数(0.0-1.0)
    """
    import math
    age_hours = (datetime.now() - timestamp).total_seconds() / 3600
    # 指数衰减:24小时内保持高分,之后逐渐衰减
    decay_factor = 0.1  # 衰减系数
    recency_score = math.exp(-decay_factor * age_hours / 24)
    return max(0.1, min(1.0, recency_score))  # 限制在 [0.1, 1.0] 范围内
选择阶段的核心算法体现了几个重要的工程考量:
- 评分机制:采用相关性和新近性的加权组合,权重可配置
- 贪心算法:按分数从高到低填充,确保在有限预算内选择最有价值的信息
- 过滤机制:通过 min_relevance 参数过滤低质量信息
(3)Structure:结构化输出
第三阶段是将选中的信息组织成结构化的上下文模板。
def _structure(self, selected_packets: List[ContextPacket], user_query: str) -> str:
    """将选中的信息包组织成结构化的上下文模板
    Args:
        selected_packets: 选中的信息包列表
        user_query: 用户查询
    Returns:
        str: 结构化的上下文字符串
    """
    # 按类型分组
    system_instructions = []
    evidence = []
    context = []
    for packet in selected_packets:
        packet_type = packet.metadata.get("type", "general")
        if packet_type == "system_instruction":
            system_instructions.append(packet.content)
        elif packet_type in ["rag_result", "knowledge"]:
            evidence.append(packet.content)
        else:
            context.append(packet.content)
    # 构建结构化模板
    sections = []
    # [Role & Policies]
    if system_instructions:
        sections.append("[Role & Policies]\n" + "\n".join(system_instructions))
    # [Task]
    sections.append(f"[Task]\n{user_query}")
    # [Evidence]
    if evidence:
        sections.append("[Evidence]\n" + "\n---\n".join(evidence))
    # [Context]
    if context:
        sections.append("[Context]\n" + "\n".join(context))
    # [Output]
    sections.append("[Output]\n请基于以上信息,提供准确、有据的回答。")
    return "\n\n".join(sections)
结构化阶段将散乱的信息包组织成清晰的分区,这种设计有几个优势:
- 可读性:清晰的分区让人类和模型都更容易理解上下文结构
- 可调试性:问题定位更容易,可以快速识别哪个区域的信息有问题
- 可扩展性:添加新的信息源只需要创建新的分区
(4)Compress:兜底压缩
第四阶段是对超限上下文进行压缩处理。
def _compress(self, context: str, max_tokens: int) -> str:
    """压缩超限的上下文
    Args:
        context: 原始上下文
        max_tokens: 最大 token 限制
    Returns:
        str: 压缩后的上下文
    """
    current_tokens = self._count_tokens(context)
    if current_tokens <= max_tokens:
        return context  # 无需压缩
    print(f"[ContextBuilder] 上下文超限({current_tokens} > {max_tokens}),执行压缩")
    # 分区压缩:保持结构完整性
    sections = context.split("\n\n")
    compressed_sections = []
    current_total = 0
    for section in sections:
        section_tokens = self._count_tokens(section)
        if current_total + section_tokens <= max_tokens:
            # 完整保留
            compressed_sections.append(section)
            current_total += section_tokens
        else:
            # 部分保留
            remaining_tokens = max_tokens - current_total
            if remaining_tokens > 50:  # 至少保留 50 tokens
                # 简单截断(生产环境中可以使用 LLM 摘要)
                truncated = self._truncate_text(section, remaining_tokens)
                compressed_sections.append(truncated + "\n[... 内容已压缩 ...]")
            break
    compressed_context = "\n\n".join(compressed_sections)
    final_tokens = self._count_tokens(compressed_context)
    print(f"[ContextBuilder] 压缩完成: {current_tokens} -> {final_tokens} tokens")
    return compressed_context
def _truncate_text(self, text: str, max_tokens: int) -> str:
    """截断文本到指定 token 数量
    Args:
        text: 原始文本
        max_tokens: 最大 token 数量
    Returns:
        str: 截断后的文本
    """
    # 简单实现:按字符比例估算
    # 生产环境中应该使用精确的 tokenizer
    char_per_token = len(text) / self._count_tokens(text) if self._count_tokens(text) > 0 else 4
    max_chars = int(max_tokens * char_per_token)
    return text[:max_chars]
def _count_tokens(self, text: str) -> int:
    """估算文本的 token 数量
    Args:
        text: 文本内容
    Returns:
        int: token 数量
    """
    # 简单估算:中文 1 字符 ≈ 1 token,英文 1 单词 ≈ 1.3 tokens
    # 生产环境中应该使用实际的 tokenizer
    chinese_chars = sum(1 for ch in text if '\u4e00' <= ch <= '\u9fff')
    english_words = len([w for w in text.split() if w])
    return int(chinese_chars + english_words * 1.3)
压缩阶段的设计体现了”保持结构完整性”的原则,即使在 token 预算紧张的情况下,也要尽量保留每个分区的关键信息。
最佳实践与优化建议
在实际应用 ContextBuilder 时,以下几点最佳实践值得注意:
- 动态调整 token 预算:根据任务复杂度动态调整 max_tokens,简单任务使用较小预算,复杂任务增加预算。
- 相关性计算优化:在生产环境中,将简单的关键词重叠替换为向量相似度计算,提升检索质量。
- 缓存机制:对于不变的系统指令和知识库内容,可以实现缓存机制,避免重复计算。
- 监控与日志:记录每次上下文构建的统计信息(选中信息数量、token 使用率等),便于后续优化。
- A/B 测试:对于关键参数(如相关性权重、新近性权重),通过 A/B 测试找到最优配置。
NoteTool:结构化笔记
NoteTool 是为”长时程任务”提供的结构化外部记忆组件。它以 Markdown 文件作为载体,头部使用 YAML 前置元数据记录关键信息,正文用于记录状态、结论、阻塞与行动项等内容。这种设计结合了人类可读性、版本控制友好性和易于回注上下文的特性,是构建长时程智能体的重要工具。
设计理念与应用场景
(1)为什么需要 NoteTool?
在第八章中,我们介绍了 MemoryTool,它提供了强大的记忆管理能力。然而,MemoryTool 主要关注对话式记忆——短期工作记忆、情景记忆和语义记忆。对于需要长期追踪、结构化管理的项目式任务,我们需要一种更轻量、更人类友好的记录方式。
NoteTool 填补了这个gap,它提供了:
- 结构化记录:使用 Markdown + YAML 格式,既适合机器解析,也方便人类阅读和编辑
- 版本友好:纯文本格式,天然支持 Git 等版本控制系统
- 低开销:无需复杂的数据库操作,适合轻量级的状态追踪
- 灵活分类:通过 type 和 tags 灵活组织笔记,支持多维度检索
(2)典型应用场景
NoteTool 特别适合以下场景:
场景1:长期项目追踪
想象一个智能体正在协助完成一个大型代码库的重构任务,这可能需要几天甚至几周。NoteTool 可以记录:
- task_state:当前阶段的任务状态和进度
- conclusion:每个阶段结束后的关键结论
- blocker:遇到的问题和阻塞点
- action:下一步的行动计划
# 记录任务状态
notes.run({
    "action": "create",
    "title": "重构项目 - 第一阶段",
    "content": "已完成数据模型层的重构,测试覆盖率达到85%。下一步将重构业务逻辑层。",
    "note_type": "task_state",
    "tags": ["refactoring", "phase1"]
})
# 记录阻塞点
notes.run({
    "action": "create",
    "title": "依赖冲突问题",
    "content": "发现某些第三方库版本不兼容,需要解决。影响范围:业务逻辑层的3个模块。",
    "note_type": "blocker",
    "tags": ["dependency", "urgent"]
})
场景2:研究任务管理
一个智能研究助手在进行文献综述时,可以使用 NoteTool 记录:
- 每篇论文的核心观点(conclusion)
- 待深入调研的主题(action)
- 重要的参考文献(reference)
场景3:与 ContextBuilder 配合
在每轮对话前,Agent 可以通过 search 或 list 操作检索相关笔记,并将其注入到上下文中:
# 在 Agent 的 run 方法中
def run(self, user_input: str) -> str:
    # 1. 检索相关笔记
    relevant_notes = self.note_tool.run({
        "action": "search",
        "query": user_input,
        "limit": 3
    })
    # 2. 将笔记内容转换为 ContextPacket
    note_packets = []
    for note in relevant_notes:
        note_packets.append(ContextPacket(
            content=note['content'],
            timestamp=note['updated_at'],
            token_count=self._count_tokens(note['content']),
            relevance_score=0.7,
            metadata={"type": "note", "note_type": note['type']}
        ))
    # 3. 构建上下文时传入笔记
    context = self.context_builder.build(
        user_query=user_input,
        custom_packets=note_packets,
        ...
    )
存储格式详解
NoteTool 采用了 Markdown + YAML 的混合格式,这种设计兼顾了结构化和可读性。
(1)笔记文件格式
每个笔记都是一个独立的 .md 文件,格式如下:
---
id: note_20250119_153000_0
title: 项目进展 - 第一阶段
type: task_state
tags: [refactoring, phase1, backend]
created_at: 2025-01-19T15:30:00
updated_at: 2025-01-19T15:30:00
---
# 项目进展 - 第一阶段
## 完成情况
已完成数据模型层的重构,主要改动包括:
1. 统一了实体类的命名规范
2. 引入了类型提示,提升代码可维护性
3. 优化了数据库查询性能
## 测试覆盖
- 单元测试覆盖率: 85%
- 集成测试覆盖率: 70%
## 下一步计划
1. 重构业务逻辑层
2. 解决依赖冲突问题
3. 提升集成测试覆盖率至85%
这种格式的优势:
- YAML 元数据:机器可解析,支持精确的字段提取和检索
- Markdown 正文:人类可读,支持丰富的格式化(标题、列表、代码块等)
- 文件名即 ID:简化管理,每个笔记的文件名就是其唯一标识
(2)索引文件
NoteTool 维护一个 notes_index.json 文件,用于快速检索和管理笔记:
{
  "note_20250119_153000_0": {
    "id": "note_20250119_153000_0",
    "title": "项目进展 - 第一阶段",
    "type": "task_state",
    "tags": ["refactoring", "phase1", "backend"],
    "created_at": "2025-01-19T15:30:00",
    "updated_at": "2025-01-19T15:30:00",
    "file_path": "./notes/note_20250119_153000_0.md"
  }
}
这个索引文件的作用:
- 快速检索:无需打开每个文件,直接从索引中查找
- 元数据管理:集中管理所有笔记的元数据
- 完整性校验:可以检测文件缺失或损坏
核心操作详解
NoteTool 提供了七个核心操作,覆盖了笔记的完整生命周期管理。
(1)create:创建笔记
def _create_note(
    self,
    title: str,
    content: str,
    note_type: str = "general",
    tags: Optional[List[str]] = None
) -> str:
    """创建笔记
    Args:
        title: 笔记标题
        content: 笔记内容(Markdown格式)
        note_type: 笔记类型(task_state/conclusion/blocker/action/reference/general)
        tags: 标签列表
    Returns:
        str: 笔记ID
    """
    from datetime import datetime
    # 1. 生成唯一ID
    timestamp = datetime.now().strftime('%Y%m%d_%H%M%S')
    note_id = f"note_{timestamp}_{len(self.index)}"
    # 2. 构建元数据
    metadata = {
        "id": note_id,
        "title": title,
        "type": note_type,
        "tags": tags or [],
        "created_at": datetime.now().isoformat(),
        "updated_at": datetime.now().isoformat()
    }
    # 3. 构建完整的 Markdown 文件内容
    md_content = self._build_markdown(metadata, content)
    # 4. 保存到文件
    file_path = os.path.join(self.workspace, f"{note_id}.md")
    with open(file_path, 'w', encoding='utf-8') as f:
        f.write(md_content)
    # 5. 更新索引
    metadata["file_path"] = file_path
    self.index[note_id] = metadata
    self._save_index()
    return note_id
def _build_markdown(self, metadata: Dict, content: str) -> str:
    """构建 Markdown 文件内容(YAML + 正文)"""
    import yaml
    # YAML 前置元数据
    yaml_header = yaml.dump(metadata, allow_unicode=True, sort_keys=False)
    # 组合格式
    return f"---\n{yaml_header}---\n\n{content}"
使用示例:
from hello_agents.tools import NoteTool
notes = NoteTool(workspace="./project_notes")
note_id = notes.run({
    "action": "create",
    "title": "重构项目 - 第一阶段",
    "content": """## 完成情况
已完成数据模型层的重构,测试覆盖率达到85%。
## 下一步
重构业务逻辑层""",
    "note_type": "task_state",
    "tags": ["refactoring", "phase1"]
})
print(f"✅ 笔记创建成功,ID: {note_id}")
(2)read:读取笔记
def _read_note(self, note_id: str) -> Dict:
    """读取笔记内容
    Args:
        note_id: 笔记ID
    Returns:
        Dict: 包含元数据和内容的字典
    """
    if note_id not in self.index:
        raise ValueError(f"笔记不存在: {note_id}")
    file_path = self.index[note_id]["file_path"]
    # 读取文件
    with open(file_path, 'r', encoding='utf-8') as f:
        raw_content = f.read()
    # 解析 YAML 元数据和 Markdown 正文
    metadata, content = self._parse_markdown(raw_content)
    return {
        "metadata": metadata,
        "content": content
    }
def _parse_markdown(self, raw_content: str) -> Tuple[Dict, str]:
    """解析 Markdown 文件(分离 YAML 和正文)"""
    import yaml
    # 查找 YAML 分隔符
    parts = raw_content.split('---\n', 2)
    if len(parts) >= 3:
        # 有 YAML 前置元数据
        yaml_str = parts[1]
        content = parts[2].strip()
        metadata = yaml.safe_load(yaml_str)
    else:
        # 无元数据,全部作为正文
        metadata = {}
        content = raw_content.strip()
    return metadata, content
(3)update:更新笔记
def _update_note(
    self,
    note_id: str,
    title: Optional[str] = None,
    content: Optional[str] = None,
    note_type: Optional[str] = None,
    tags: Optional[List[str]] = None
) -> str:
    """更新笔记
    Args:
        note_id: 笔记ID
        title: 新标题(可选)
        content: 新内容(可选)
        note_type: 新类型(可选)
        tags: 新标签(可选)
    Returns:
        str: 操作结果消息
    """
    if note_id not in self.index:
        raise ValueError(f"笔记不存在: {note_id}")
    # 1. 读取现有笔记
    note = self._read_note(note_id)
    metadata = note["metadata"]
    old_content = note["content"]
    # 2. 更新字段
    if title:
        metadata["title"] = title
    if note_type:
        metadata["type"] = note_type
    if tags is not None:
        metadata["tags"] = tags
    if content is not None:
        old_content = content
    # 更新时间戳
    from datetime import datetime
    metadata["updated_at"] = datetime.now().isoformat()
    # 3. 重新构建并保存
    md_content = self._build_markdown(metadata, old_content)
    file_path = metadata["file_path"]
    with open(file_path, 'w', encoding='utf-8') as f:
        f.write(md_content)
    # 4. 更新索引
    self.index[note_id] = metadata
    self._save_index()
    return f"✅ 笔记已更新: {metadata['title']}"
(4)search:搜索笔记
def _search_notes(
    self,
    query: str,
    limit: int = 10,
    note_type: Optional[str] = None,
    tags: Optional[List[str]] = None
) -> List[Dict]:
    """搜索笔记
    Args:
        query: 搜索关键词
        limit: 返回数量限制
        note_type: 按类型过滤(可选)
        tags: 按标签过滤(可选)
    Returns:
        List[Dict]: 匹配的笔记列表
    """
    results = []
    query_lower = query.lower()
    for note_id, metadata in self.index.items():
        # 类型过滤
        if note_type and metadata.get("type") != note_type:
            continue
        # 标签过滤
        if tags:
            note_tags = set(metadata.get("tags", []))
            if not note_tags.intersection(tags):
                continue
        # 读取笔记内容
        try:
            note = self._read_note(note_id)
            content = note["content"]
            title = metadata.get("title", "")
            # 在标题和内容中搜索
            if query_lower in title.lower() or query_lower in content.lower():
                results.append({
                    "note_id": note_id,
                    "title": title,
                    "type": metadata.get("type"),
                    "tags": metadata.get("tags", []),
                    "content": content,
                    "updated_at": metadata.get("updated_at")
                })
        except Exception as e:
            print(f"[WARNING] 读取笔记 {note_id} 失败: {e}")
            continue
    # 按更新时间排序
    results.sort(key=lambda x: x["updated_at"], reverse=True)
    return results[:limit]
(5)list:列出笔记
def _list_notes(
    self,
    note_type: Optional[str] = None,
    tags: Optional[List[str]] = None,
    limit: int = 20
) -> List[Dict]:
    """列出笔记(按更新时间倒序)
    Args:
        note_type: 按类型过滤(可选)
        tags: 按标签过滤(可选)
        limit: 返回数量限制
    Returns:
        List[Dict]: 笔记元数据列表
    """
    results = []
    for note_id, metadata in self.index.items():
        # 类型过滤
        if note_type and metadata.get("type") != note_type:
            continue
        # 标签过滤
        if tags:
            note_tags = set(metadata.get("tags", []))
            if not note_tags.intersection(tags):
                continue
        results.append(metadata)
    # 按更新时间排序
    results.sort(key=lambda x: x.get("updated_at", ""), reverse=True)
    return results[:limit]
(6)summary:笔记摘要
def _summary(self) -> Dict[str, Any]:
    """生成笔记摘要统计
    Returns:
        Dict: 统计信息
    """
    total_count = len(self.index)
    # 按类型统计
    type_counts = {}
    for metadata in self.index.values():
        note_type = metadata.get("type", "general")
        type_counts[note_type] = type_counts.get(note_type, 0) + 1
    # 最近更新的笔记
    recent_notes = sorted(
        self.index.values(),
        key=lambda x: x.get("updated_at", ""),
        reverse=True
    )[:5]
    return {
        "total_notes": total_count,
        "type_distribution": type_counts,
        "recent_notes": [
            {
                "id": note["id"],
                "title": note.get("title", ""),
                "type": note.get("type"),
                "updated_at": note.get("updated_at")
            }
            for note in recent_notes
        ]
    }
(7)delete:删除笔记
def _delete_note(self, note_id: str) -> str:
    """删除笔记
    Args:
        note_id: 笔记ID
    Returns:
        str: 操作结果消息
    """
    if note_id not in self.index:
        raise ValueError(f"笔记不存在: {note_id}")
    # 1. 删除文件
    file_path = self.index[note_id]["file_path"]
    if os.path.exists(file_path):
        os.remove(file_path)
    # 2. 从索引中移除
    title = self.index[note_id].get("title", note_id)
    del self.index[note_id]
    self._save_index()
    return f"✅ 笔记已删除: {title}"
与contextbuilder的深度集成
NoteTool 的真正威力在于与 ContextBuilder 的配合使用。让我们通过一个完整的案例来展示这种集成。
(1)场景设定
假设我们正在构建一个长期项目助手,它需要:
- 记录项目的阶段性进展
- 追踪待解决的问题
- 在每次对话时,自动回顾相关笔记
- 基于历史笔记提供连贯的建议
(2)实现示例
from hello_agents import SimpleAgent, HelloAgentsLLM
from hello_agents.context import ContextBuilder, ContextConfig, ContextPacket
from hello_agents.tools import MemoryTool, RAGTool, NoteTool
from datetime import datetime
class ProjectAssistant(SimpleAgent):
    """长期项目助手,集成 NoteTool 和 ContextBuilder"""
    def __init__(self, name: str, project_name: str, **kwargs):
        super().__init__(name=name, llm=HelloAgentsLLM(), **kwargs)
        self.project_name = project_name
        # 初始化工具
        self.memory_tool = MemoryTool(user_id=project_name)
        self.rag_tool = RAGTool(knowledge_base_path=f"./{project_name}_kb")
        self.note_tool = NoteTool(workspace=f"./{project_name}_notes")
        # 初始化上下文构建器
        self.context_builder = ContextBuilder(
            memory_tool=self.memory_tool,
            rag_tool=self.rag_tool,
            config=ContextConfig(max_tokens=4000)
        )
        self.conversation_history = []
    def run(self, user_input: str, note_as_action: bool = False) -> str:
        """运行助手,自动集成笔记"""
        # 1. 从 NoteTool 检索相关笔记
        relevant_notes = self._retrieve_relevant_notes(user_input)
        # 2. 将笔记转换为 ContextPacket
        note_packets = self._notes_to_packets(relevant_notes)
        # 3. 构建优化的上下文
        context = self.context_builder.build(
            user_query=user_input,
            conversation_history=self.conversation_history,
            system_instructions=self._build_system_instructions(),
            custom_packets=note_packets
        )
        # 4. 调用 LLM
        response = self.llm.invoke(context)
        # 5. 如果需要,将交互记录为笔记
        if note_as_action:
            self._save_as_note(user_input, response)
        # 6. 更新对话历史
        self._update_history(user_input, response)
        return response
    def _retrieve_relevant_notes(self, query: str, limit: int = 3) -> List[Dict]:
        """检索相关笔记"""
        try:
            # 优先检索 blocker 和 action 类型的笔记
            blockers = self.note_tool.run({
                "action": "list",
                "note_type": "blocker",
                "limit": 2
            })
            # 通用搜索
            search_results = self.note_tool.run({
                "action": "search",
                "query": query,
                "limit": limit
            })
            # 合并并去重
            all_notes = {note['note_id']: note for note in blockers + search_results}
            return list(all_notes.values())[:limit]
        except Exception as e:
            print(f"[WARNING] 笔记检索失败: {e}")
            return []
    def _notes_to_packets(self, notes: List[Dict]) -> List[ContextPacket]:
        """将笔记转换为上下文包"""
        packets = []
        for note in notes:
            content = f"[笔记:{note['title']}]\n{note['content']}"
            packets.append(ContextPacket(
                content=content,
                timestamp=datetime.fromisoformat(note['updated_at']),
                token_count=len(content) // 4,  # 简单估算
                relevance_score=0.75,  # 笔记具有较高相关性
                metadata={
                    "type": "note",
                    "note_type": note['type'],
                    "note_id": note['note_id']
                }
            ))
        return packets
    def _save_as_note(self, user_input: str, response: str):
        """将交互保存为笔记"""
        try:
            # 判断应该保存为什么类型的笔记
            if "问题" in user_input or "阻塞" in user_input:
                note_type = "blocker"
            elif "计划" in user_input or "下一步" in user_input:
                note_type = "action"
            else:
                note_type = "conclusion"
            self.note_tool.run({
                "action": "create",
                "title": f"{user_input[:30]}...",
                "content": f"## 问题\n{user_input}\n\n## 分析\n{response}",
                "note_type": note_type,
                "tags": [self.project_name, "auto_generated"]
            })
        except Exception as e:
            print(f"[WARNING] 保存笔记失败: {e}")
    def _build_system_instructions(self) -> str:
        """构建系统指令"""
        return f"""你是 {self.project_name} 项目的长期助手。
你的职责:
1. 基于历史笔记提供连贯的建议
2. 追踪项目进展和待解决问题
3. 在回答时引用相关的历史笔记
4. 提供具体、可操作的下一步建议
注意:
- 优先关注标记为 blocker 的问题
- 在建议中说明依据来源(笔记、记忆或知识库)
- 保持对项目整体进度的认识"""
    def _update_history(self, user_input: str, response: str):
        """更新对话历史"""
        from hello_agents.core.message import Message
        self.conversation_history.append(
            Message(content=user_input, role="user", timestamp=datetime.now())
        )
        self.conversation_history.append(
            Message(content=response, role="assistant", timestamp=datetime.now())
        )
        # 限制历史长度
        if len(self.conversation_history) > 10:
            self.conversation_history = self.conversation_history[-10:]
# 使用示例
assistant = ProjectAssistant(
    name="项目助手",
    project_name="data_pipeline_refactoring"
)
# 第一次交互:记录项目状态
response = assistant.run(
    "我们已经完成了数据模型层的重构,测试覆盖率达到85%。下一步计划重构业务逻辑层。",
    note_as_action=True
)
# 第二次交互:提出问题
response = assistant.run(
    "在重构业务逻辑层时,我遇到了依赖版本冲突的问题,该如何解决?"
)
# 查看笔记摘要
summary = assistant.note_tool.run({"action": "summary"})
print(summary)
最佳实践
在实际使用 NoteTool 时,以下最佳实践能帮助您构建更强大的长时程智能体:
- 合理的笔记分类:
- task_state:记录阶段性进展和状态
- conclusion:记录重要的结论和发现
- blocker:记录阻塞问题,优先级最高
- action:记录下一步行动计划
- reference:记录重要的参考资料
- 定期清理和归档:
- 对于已解决的 blocker,更新为 conclusion
- 对于过时的 action,及时删除或更新
- 使用 tags 进行版本管理,如 [“v1.0”, “completed”]
- 与 ContextBuilder 的配合:
- 在每轮对话前检索相关笔记
- 根据笔记类型设置不同的相关性分数(blocker > action > conclusion)
- 限制笔记数量,避免上下文过载
- 人机协作:
- 笔记是人类可读的 Markdown 格式,支持手动编辑
- 使用 Git 进行版本控制,追踪笔记的演化
- 在关键阶段,人工审核 Agent 生成的笔记
- 自动化工作流:
- 定期生成笔记摘要报告
- 基于笔记自动生成项目进度文档
- 将笔记内容同步到其他系统(如 Notion、Confluence)
TerminalTool:即时文件系统访问
MemoryTool 和 RAGTool,分别提供了对话记忆和知识检索能力。然而,在许多实际场景中,智能体需要即时访问和探索文件系统——查看日志文件、分析代码库结构、检索配置文件等。这就是 TerminalTool 的用武之地。
TerminalTool 为智能体提供了安全的命令行执行能力,支持常用的文件系统和文本处理命令,同时通过多层安全机制确保系统安全。这种设计实现了”即时(Just-in-time, JIT)上下文”理念——智能体不需要预先加载所有文件,而是按需探索和检索。
设计理念与安全机制
(1)为什么需要 TerminalTool?
在构建长程智能体时,我们经常遇到以下场景:
场景1:代码库探索
一个开发助手需要帮助用户理解一个大型代码库的结构:
# 传统方式:预先索引所有文件(成本高、可能过时)
rag_tool.add_document("./project/**/*.py")  # 耗时、占用大量存储
# TerminalTool 方式:即时探索
terminal.run({"command": "find . -name '*.py' -type f"})  # 快速、实时
terminal.run({"command": "grep -r '
class UserService' ."})  # 精确定位
terminal.run({"command": "head -n 50 src/services/user.py"})  # 按需查看
场景2:日志文件分析
一个运维助手需要分析应用日志:
# 检查日志文件大小
terminal.run({"command": "ls -lh /var/log/app.log"})
# 查看最新的错误日志
terminal.run({"command": "tail -n 100 /var/log/app.log | grep ERROR"})
# 统计错误类型分布
terminal.run({"command": "grep ERROR /var/log/app.log | cut -d':' -f3 | sort | uniq -c"})
场景3:数据文件预览
一个数据分析助手需要快速了解数据文件的结构:
# 查看 CSV 文件的前几行
terminal.run({"command": "head -n 5 data/sales.csv"})
# 统计行数
terminal.run({"command": "wc -l data/*.csv"})
# 查看列名
terminal.run({"command": "head -n 1 data/sales.csv | tr ',' '\n'"})
这些场景的共同特点是:需要实时、轻量级的文件系统访问,而不是预先索引和向量化。TerminalTool 正是为这种”探索式”工作流设计的。
(2)安全机制详解
允许智能体执行命令是一个强大但危险的能力。TerminalTool 通过多层安全机制确保系统安全:
第一层:命令白名单
只允许安全的只读命令,完全禁止任何可能修改系统的操作:
ALLOWED_COMMANDS = {
    # 文件列表与信息
    'ls', 'dir', 'tree',
    # 文件内容查看
    'cat', 'head', 'tail', 'less', 'more',
    # 文件搜索
    'find', 'grep', 'egrep', 'fgrep',
    # 文本处理
    'wc', 'sort', 'uniq', 'cut', 'awk', 'sed',
    # 目录操作
    'pwd', 'cd',
    # 文件信息
    'file', 'stat', 'du', 'df',
    # 其他
    'echo', 'which', 'whereis',
}
如果agent尝试执行白名单以外的命令,会立即被拒绝。
第二层:工作目录限制(沙箱)
TerminalTool 只能访问指定的工作目录及其子目录,无法访问系统其他部分:
# 初始化时指定工作目录
terminal = TerminalTool(workspace="./project")
# 允许:访问工作目录内的文件
terminal.run({"command": "cat ./src/main.py"})  # ✅
# 禁止:访问工作目录外的文件
terminal.run({"command": "cat /etc/passwd"})  # ❌ 不允许访问工作目录外的路径
# 禁止:通过 .. 逃逸
terminal.run({"command": "cd ../../../etc"})  # ❌ 不允许访问工作目录外的路径
这种沙箱机制确保了即使智能体的行为出现异常,也无法影响系统其他部分。
第三层:超时控制
每个命令都有执行时间限制,防止无限循环或资源耗尽:
terminal = TerminalTool(
    workspace="./project",
    timeout=30  # 30秒超时
)
# 如果命令执行超过30秒
terminal.run({"command": "find / -name '*.log'"})
# ❌ 命令执行超时(超过 30 秒)
第四层:输出大小限制
限制命令输出的大小,防止内存溢出:
terminal = TerminalTool(
    workspace="./project",
    max_output_size=10 * 1024 * 1024  # 10MB
)
# 如果输出超过10MB
terminal.run({"command": "cat huge_file.log"})
# ... (前10MB的内容) ...
# ⚠️ 输出被截断(超过 10485760 字节)
通过这四层安全机制,TerminalTool 在提供强大能力的同时,最大程度地保证了系统安全。
核心功能详解
TerminalTool 的实现聚焦于两个核心功能:命令执行和目录导航。
(1)命令执行
核心的 _execute_command 方法负责实际执行命令:
def _execute_command(self, command: str) -> str:
    """执行命令"""
    try:
        # 在当前目录下执行命令
        result = subprocess.run(
            command,
            shell=True,
            cwd=str(self.current_dir),  # 在当前工作目录执行
            capture_output=True,
            text=True,
            timeout=self.timeout,
            env=os.environ.copy()
        )
        # 合并标准输出和标准错误
        output = result.stdout
        if result.stderr:
            output += f"\n[stderr]\n{result.stderr}"
        # 检查输出大小
        if len(output) > self.max_output_size:
            output = output[:self.max_output_size]
            output += f"\n\n⚠️ 输出被截断(超过 {self.max_output_size} 字节)"
        # 添加返回码信息
        if result.returncode != 0:
            output = f"⚠️ 命令返回码: {result.returncode}\n\n{output}"
        return output if output else "✅ 命令执行成功(无输出)"
    except subprocess.TimeoutExpired:
        return f"❌ 命令执行超时(超过 {self.timeout} 秒)"
    except Exception as e:
        return f"❌ 命令执行失败: {e}"
这个实现的关键点:
- 当前目录感知:使用 cwd 参数在正确的目录下执行命令
- 错误处理:捕获并合并标准错误,提供完整的诊断信息
- 返回码检查:非零返回码会被标记为警告
- 容错设计:超时和异常都会被妥善处理,不会导致智能体崩溃
(2)目录导航
cd 命令的特殊处理支持智能体在文件系统中导航:
def _handle_cd(self, parts: List[str]) -> str:
    """处理 cd 命令"""
    if not self.allow_cd:
        return "❌ cd 命令已禁用"
    if len(parts) < 2:
        # cd 无参数,返回当前目录
        return f"当前目录: {self.current_dir}"
    target_dir = parts[1]
    # 处理相对路径
    if target_dir == "..":
        new_dir = self.current_dir.parent
    elif target_dir == ".":
        new_dir = self.current_dir
    elif target_dir == "~":
        new_dir = self.workspace
    else:
        new_dir = (self.current_dir / target_dir).resolve()
    # 检查是否在工作目录内
    try:
        new_dir.relative_to(self.workspace)
    except ValueError:
        return f"❌ 不允许访问工作目录外的路径: {new_dir}"
    # 检查目录是否存在
    if not new_dir.exists():
        return f"❌ 目录不存在: {new_dir}"
    if not new_dir.is_dir():
        return f"❌ 不是目录: {new_dir}"
    # 更新当前目录
    self.current_dir = new_dir
    return f"✅ 切换到目录: {self.current_dir}"
典型使用模式
TerminalTool 支持多种常见的文件系统操作模式。
(1)探索式导航
智能体可以像人类开发者一样逐步探索代码库:
from hello_agents.tools import TerminalTool
terminal = TerminalTool(workspace="./my_project")
# 第一步:查看项目根目录
print(terminal.run({"command": "ls -la"}))
"""
total 24
drwxr-xr-x  6 user  staff   192 Jan 19 16:00 .
drwxr-xr-x  5 user  staff   160 Jan 19 15:30 ..
-rw-r--r--  1 user  staff  1234 Jan 19 15:30 README.md
drwxr-xr-x  4 user  staff   128 Jan 19 15:30 src
drwxr-xr-x  3 user  staff
    96 Jan 19 15:30 tests
-rw-r--r--  1 user  staff   456 Jan 19 15:30 requirements.txt
"""
# 第二步:查看源代码目录结构
terminal.run({"command": "cd src"})
print(terminal.run({"command": "tree"}))
# 第三步:搜索特定模式
print(terminal.run({"command": "grep -r 'def process' ."}))
(2)数据文件分析
快速了解数据文件的结构和内容:
terminal = TerminalTool(workspace="./data")
# 查看 CSV 文件的前几行
print(terminal.run({"command": "head -n 5 sales_2024.csv"}))
"""
date,product,quantity,revenue
2024-01-01,Widget A,150,4500.00
2024-01-01,Widget B,200,8000.00
2024-01-02,Widget A,180,5400.00
2024-01-02,Widget C,120,3600.00
"""
# 统计总行数
print(terminal.run({"command": "wc -l *.csv"}))
"""
  10234 sales_2024.csv
   8567 sales_2023.csv
  18801 total
"""
# 提取和统计产品类别
print(terminal.run({"command": "tail -n +2 sales_2024.csv | cut -d',' -f2 | sort | uniq -c"}))
"""
  3456 Widget A
  4123 Widget B
  2655 Widget C
"""
(3)日志文件分析
实时分析应用日志,快速定位问题:
terminal = TerminalTool(workspace="/var/log")
# 查看最新的错误日志
print(terminal.run({"command": "tail -n 50 app.log | grep ERROR"}))
# 统计错误类型分布
print(terminal.run({"command": "grep ERROR app.log | awk '{print $4}' | sort | uniq -c | sort -rn"}))
"""
  245 DatabaseConnectionError
  123 TimeoutException
   67 ValidationError
   34 AuthenticationError
"""
# 查找特定时间段的日志
print(terminal.run({"command": "grep '2024-01-19 15:' app.log | tail -n 20"}))
(4)代码库分析
辅助代码审查和理解:
terminal = TerminalTool(workspace="./codebase")
# 统计代码行数
print(terminal.run({"command": "find . -name '*.py' -exec wc -l {} + | tail -n 1"}))
# 查找所有 TODO 注释
print(terminal.run({"command": "grep -rn 'TODO' --include='*.py'"}))
# 查找特定函数的定义
print(terminal.run({"command": "grep -rn 'def process_data' --include='*.py'"}))
# 查看函数实现
print(terminal.run({"command": "sed -n '/def process_data/,/^def /p' src/processor.py | head -n -1"}))
与其他工具的协同
TerminalTool 的真正威力在于与 MemoryTool、NoteTool 和 ContextBuilder 的协同使用。
(1)与 MemoryTool 协同
TerminalTool 发现的信息可以存储到记忆系统中:
# 使用 TerminalTool 发现项目结构
structure = terminal.run({"command": "tree -L 2 src"})
# 存储到语义记忆
memory_tool.run({
    "action": "add",
    "content": f"项目结构:\n{structure}",
    "memory_type": "semantic",
    "importance": 0.8,
    "metadata": {"type": "project_structure"}
})
(2)与 NoteTool 协同
重要的发现可以记录为结构化笔记:
# 发现一个性能瓶颈
log_analysis = terminal.run({"command": "grep 'slow query' app.log | tail -n 10"})
# 记录为 blocker 笔记
note_tool.run({
    "action": "create",
    "title": "数据库慢查询问题",
    "content": f"## 问题描述\n发现多个慢查询,影响系统性能\n\n## 日志分析\n```\n{log_analysis}\n```\n\n## 下一步\n1. 分析慢查询SQL\n2. 添加索引\n3. 优化查询逻辑",
    "note_type": "blocker",
    "tags": ["performance", "database"]
})
(3)与 ContextBuilder 协同
TerminalTool 的输出可以作为上下文的一部分:
# 探索代码库
code_structure = terminal.run({"command": "ls -R src"})
recent_changes = terminal.run({"command": "git log --oneline -10"})
# 转换为 ContextPacket
from hello_agents.context import ContextPacket
from datetime import datetime
packets = [
    ContextPacket(
        content=f"代码库结构:\n{code_structure}",
        timestamp=datetime.now(),
        token_count=len(code_structure) // 4,
        relevance_score=0.7,
        metadata={"type": "code_structure", "source": "terminal"}
    ),
    ContextPacket(
        content=f"最近提交:\n{recent_changes}",
        timestamp=datetime.now(),
        token_count=len(recent_changes) // 4,
        relevance_score=0.8,
        metadata={"type": "git_history", "source": "terminal"}
    )
]
# 在构建上下文时包含这些信息
context = context_builder.build(
    user_query="如何重构用户服务模块?",
    custom_packets=packets
)
智能体通信协议
如何让智能体与外部世界高效交互?如何让多个智能体相互协作?这正是智能体通信协议要解决的核心问题。MCP(Model Context Protocol)用于智能体与工具的标准化通信,A2A(Agent-to-Agent Protocol)用于智能体间的点对点协作,ANP(Agent Network Protocol)用于构建大规模智能体网络。这三种协议共同构成了智能体通信的基础设施层。
没有通信协议的代码:
# 传统方式:手动集成每个服务
class GitHubTool(BaseTool):
    """需要手写GitHub API适配器"""
    def run(self, repo_url):
        # 大量的API调用代码...
        pass
class DatabaseTool(BaseTool):
    """需要手写数据库适配器"""
    def run(self, query):
        # 数据库连接和查询代码...
        pass
class WeatherTool(BaseTool):
    """需要手写天气API适配器"""
    def run(self, location):
        # 天气API调用代码...
        pass
# 每个新服务都需要重复这个过程
agent.add_tool(GitHubTool())
agent.add_tool(DatabaseTool())
agent.add_tool(WeatherTool())
这种方式存在明显的问题:代码重复(每个工具都要处理 HTTP 请求、错误处理、认证等),难以维护(API 变更需要修改所有相关工具),无法复用(其他开发者的工具无法直接使用),扩展性差(添加新服务需要大量编码工作)。
通信协议的核心价值正是解决这些问题。它提供了一套标准化的接口规范,让智能体能够以统一的方式访问各种外部服务,而无需为每个服务编写专门的适配器。这就像互联网的 TCP/IP 协议,它让不同的设备能够相互通信,而不需要为每种设备编写专门的通信代码。
有了通信协议,上面的代码可以简化为:
from hello_agents.tools import MCPTool
# 连接到MCP服务器,自动获得所有工具
mcp_tool = MCPTool()  # 内置服务器提供基础工具
# 或者连接到专业的MCP服务器
github_mcp = MCPTool(server_command=["npx", "-y", "@modelcontextprotocol/server-github"])
database_mcp = MCPTool(server_command=["python", "database_mcp_server.py"])
# 智能体自动获得所有能力,无需手写适配器
agent.add_tool(mcp_tool)
agent.add_tool(github_mcp)
agent.add_tool(database_mcp)
通信协议带来的改变是根本性的:标准化接口让不同服务提供统一的访问方式,互操作性使得不同开发者的工具可以无缝集成,动态发现允许智能体在运行时发现新的服务和能力,可扩展性让系统能够轻松添加新的功能模块。
三种协议设计理解比较
智能体通信协议并非单一的解决方案,而是针对不同通信场景设计的一系列标准。以目前业界主流的三种协议 MCP、A2A 和 ANP 为例进行实践,下面是一个总览的比较。
(1)MCP:智能体与工具的桥梁
MCP(Model Context Protocol)由 Anthropic 团队提出,其核心设计理念是标准化智能体与外部工具/资源的通信方式。想象一下,你的智能体需要访问文件系统、数据库、GitHub、Slack 等各种服务。传统做法是为每个服务编写专门的适配器,这不仅工作量大,而且难以维护。MCP 通过定义统一的协议规范,让所有服务都能以相同的方式被访问。
MCP 的设计哲学是”上下文共享”。它不仅仅是一个 RPC(远程过程调用)协议,更重要的是它允许智能体和工具之间共享丰富的上下文信息。如图所示,当智能体访问一个代码仓库时,MCP 服务器不仅能提供文件内容,还能提供代码结构、依赖关系、提交历史等上下文信息,让智能体能够做出更智能的决策。
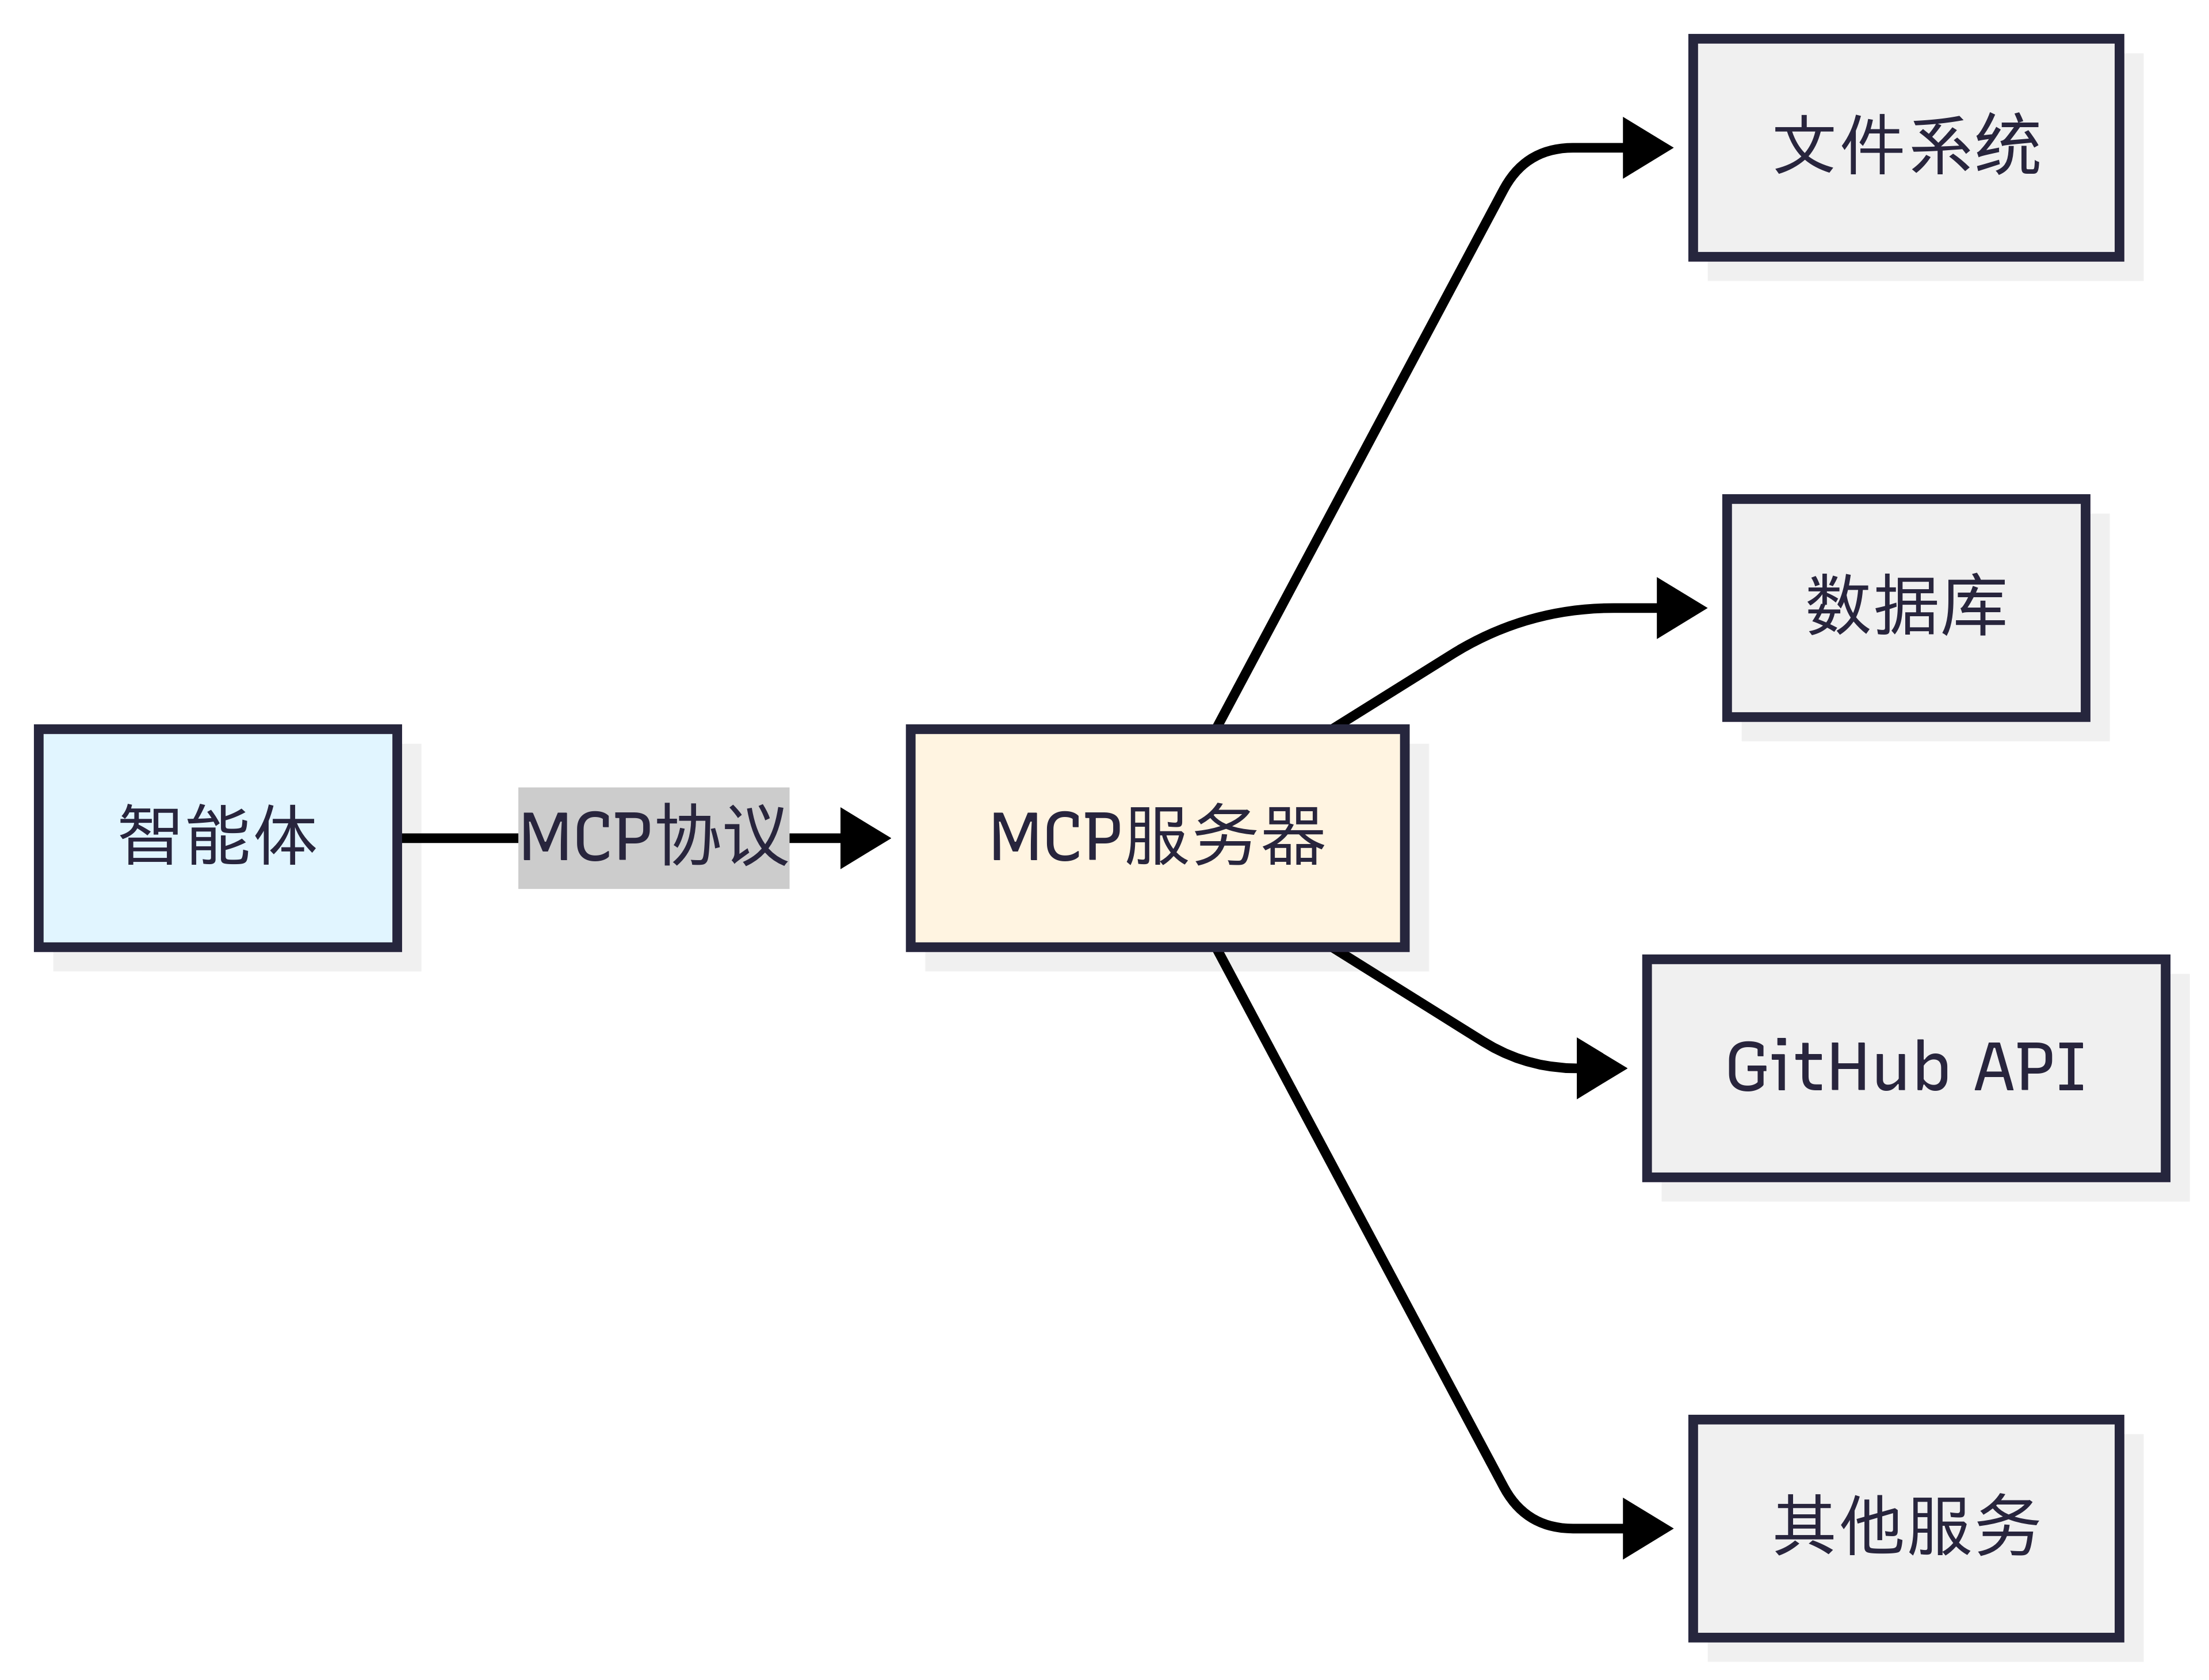
(2)A2A:智能体间的对话
A2A(Agent-to-Agent Protocol)协议由 Google 团队提出,其核心设计理念是实现智能体之间的点对点通信。与 MCP 关注智能体与工具的通信不同,A2A 关注的是智能体之间如何相互协作。这种设计让智能体能够像人类团队一样进行对话、协商和协作。
A2A 的设计哲学是”对等通信”。如图所示,在 A2A 网络中,每个智能体既是服务提供者,也是服务消费者。智能体可以主动发起请求,也可以响应其他智能体的请求。这种对等的设计避免了中心化协调器的瓶颈,让智能体网络更加灵活和可扩展。
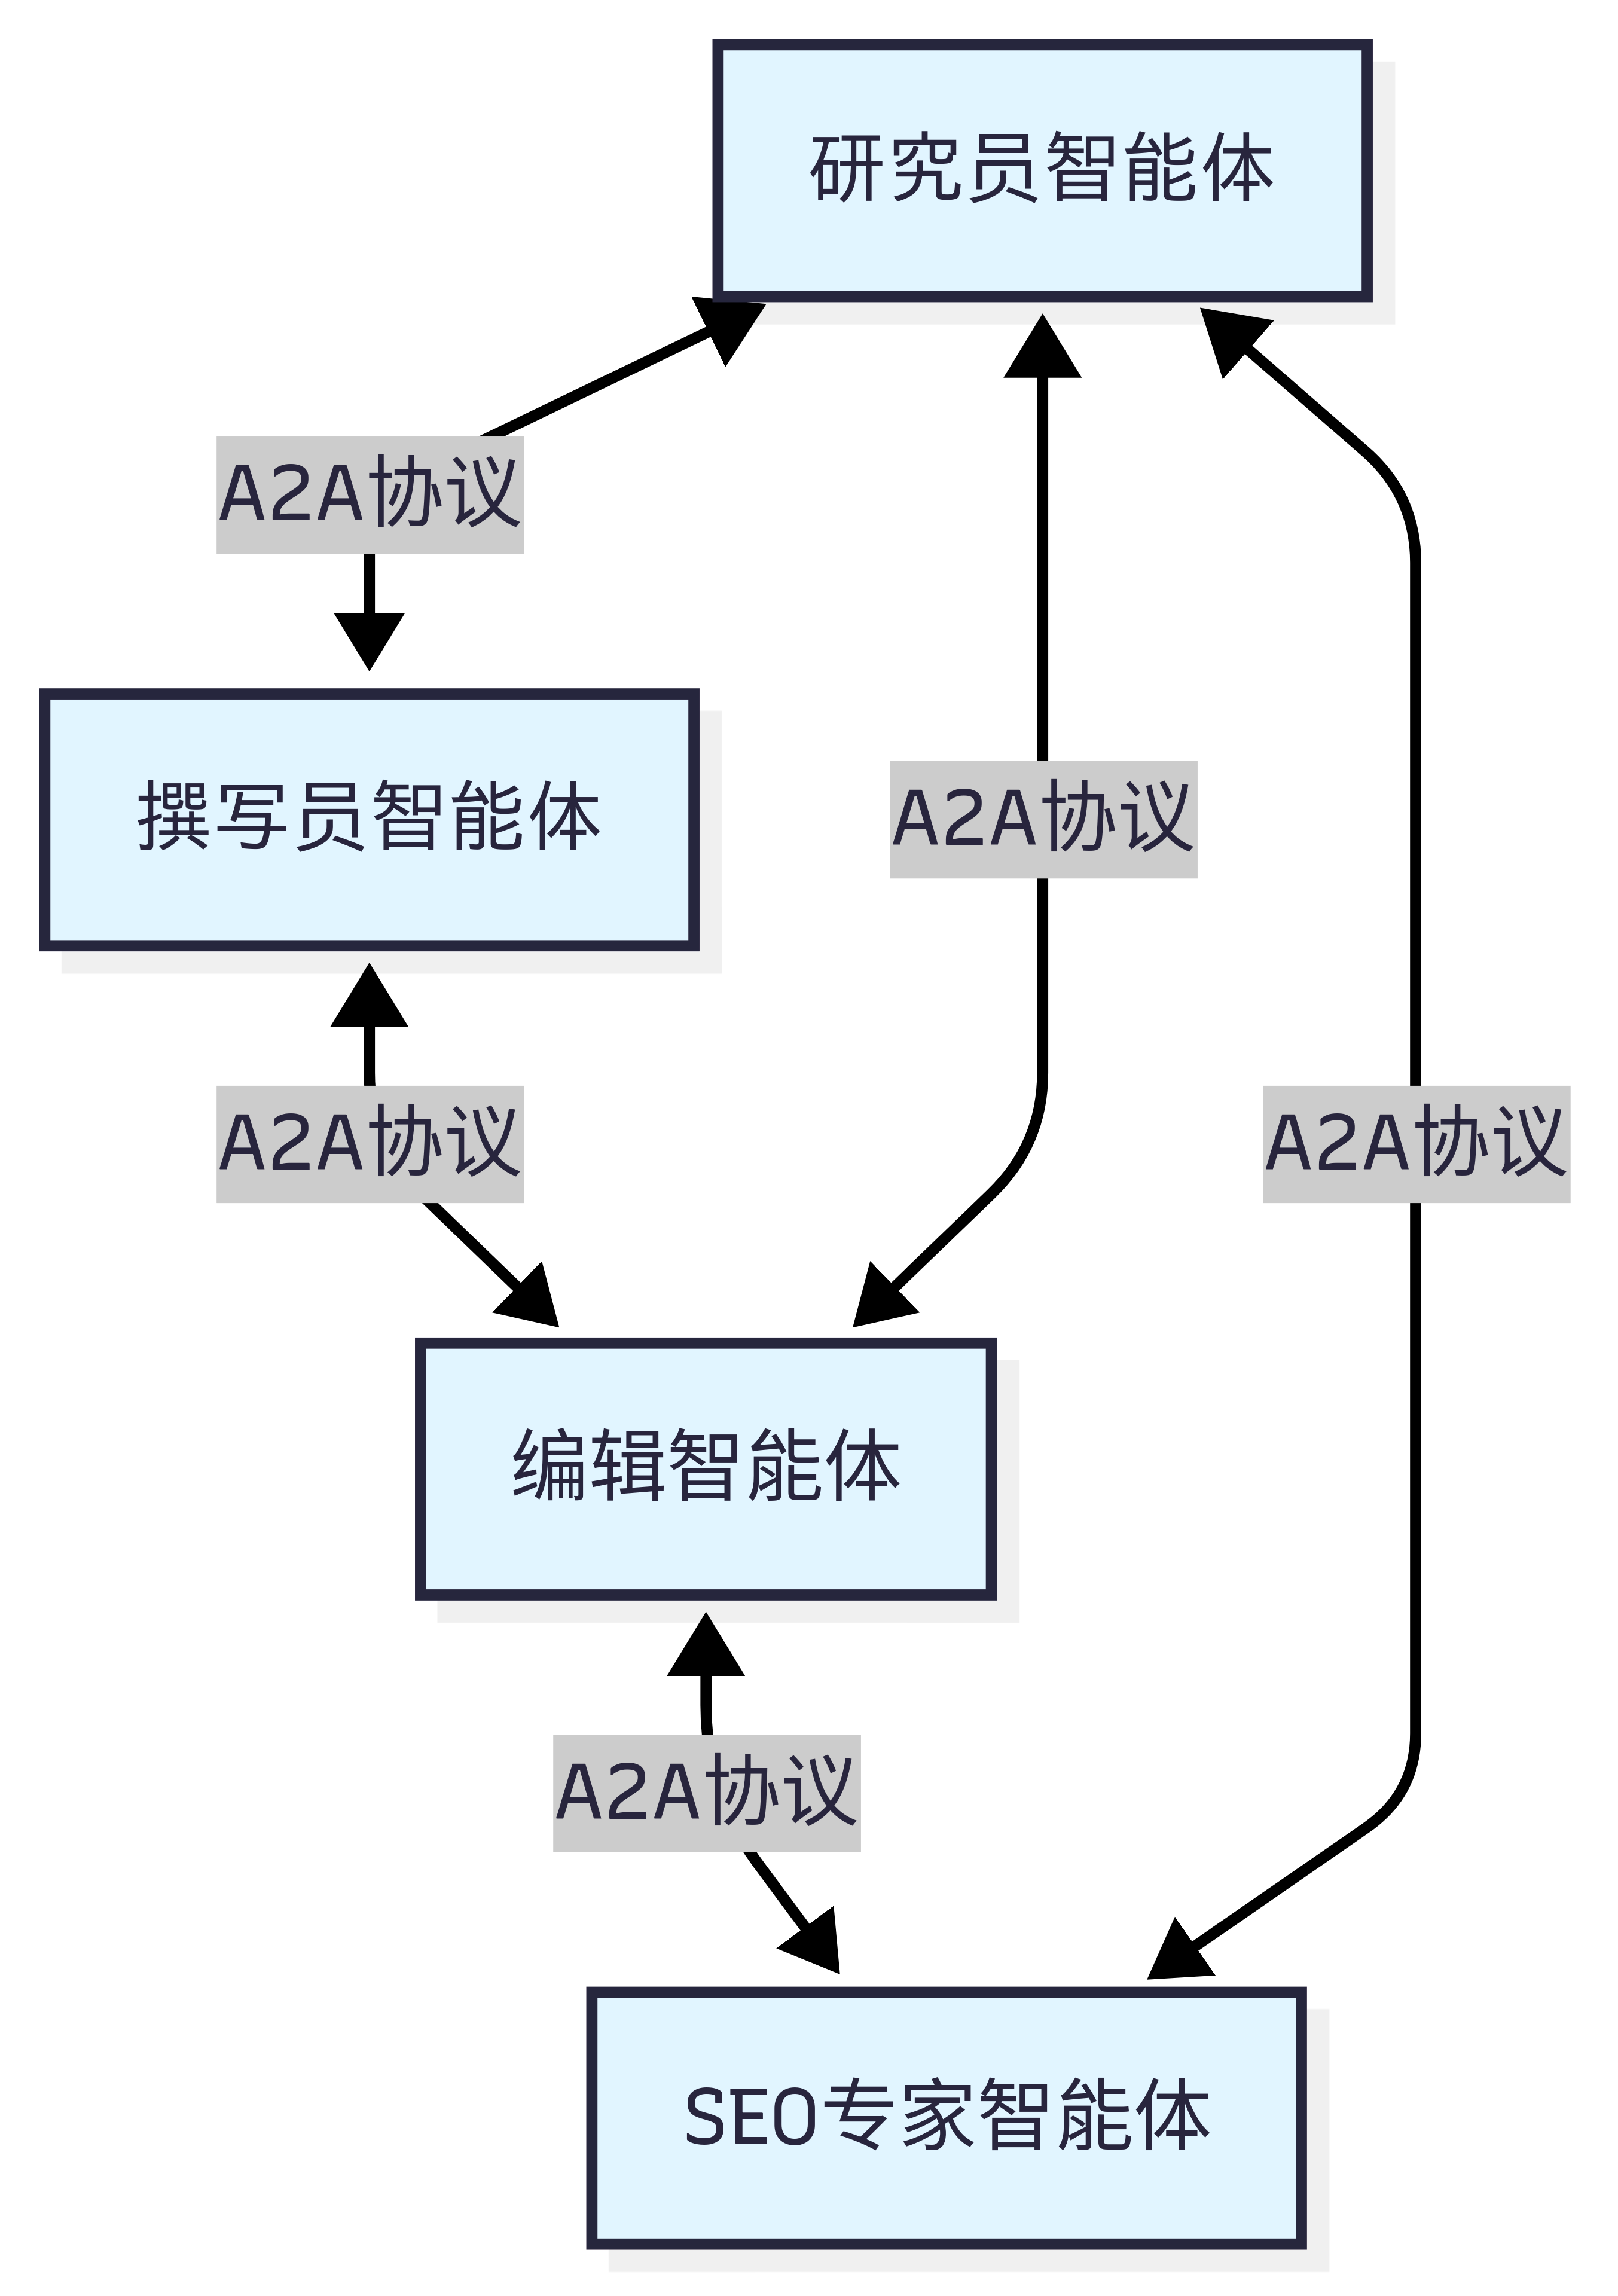
(3)ANP:智能体网络的基础设施
ANP(Agent Network Protocol)是一个概念性的协议框架,目前由开源社区维护,还没有成熟的生态,其核心设计理念是构建大规模智能体网络的基础设施。如果说 MCP 解决的是”如何访问工具”,A2A 解决的是”如何与其他智能体对话”,那么 ANP 解决的是”如何在大规模网络中发现和连接智能体”。
ANP 的设计哲学是”去中心化服务发现”。在一个包含成百上千个智能体的网络中,如何让智能体能够找到它需要的服务?如图所示,ANP 提供了服务注册、发现和路由机制,让智能体能够动态地发现网络中的其他服务,而不需要预先配置所有的连接关系。
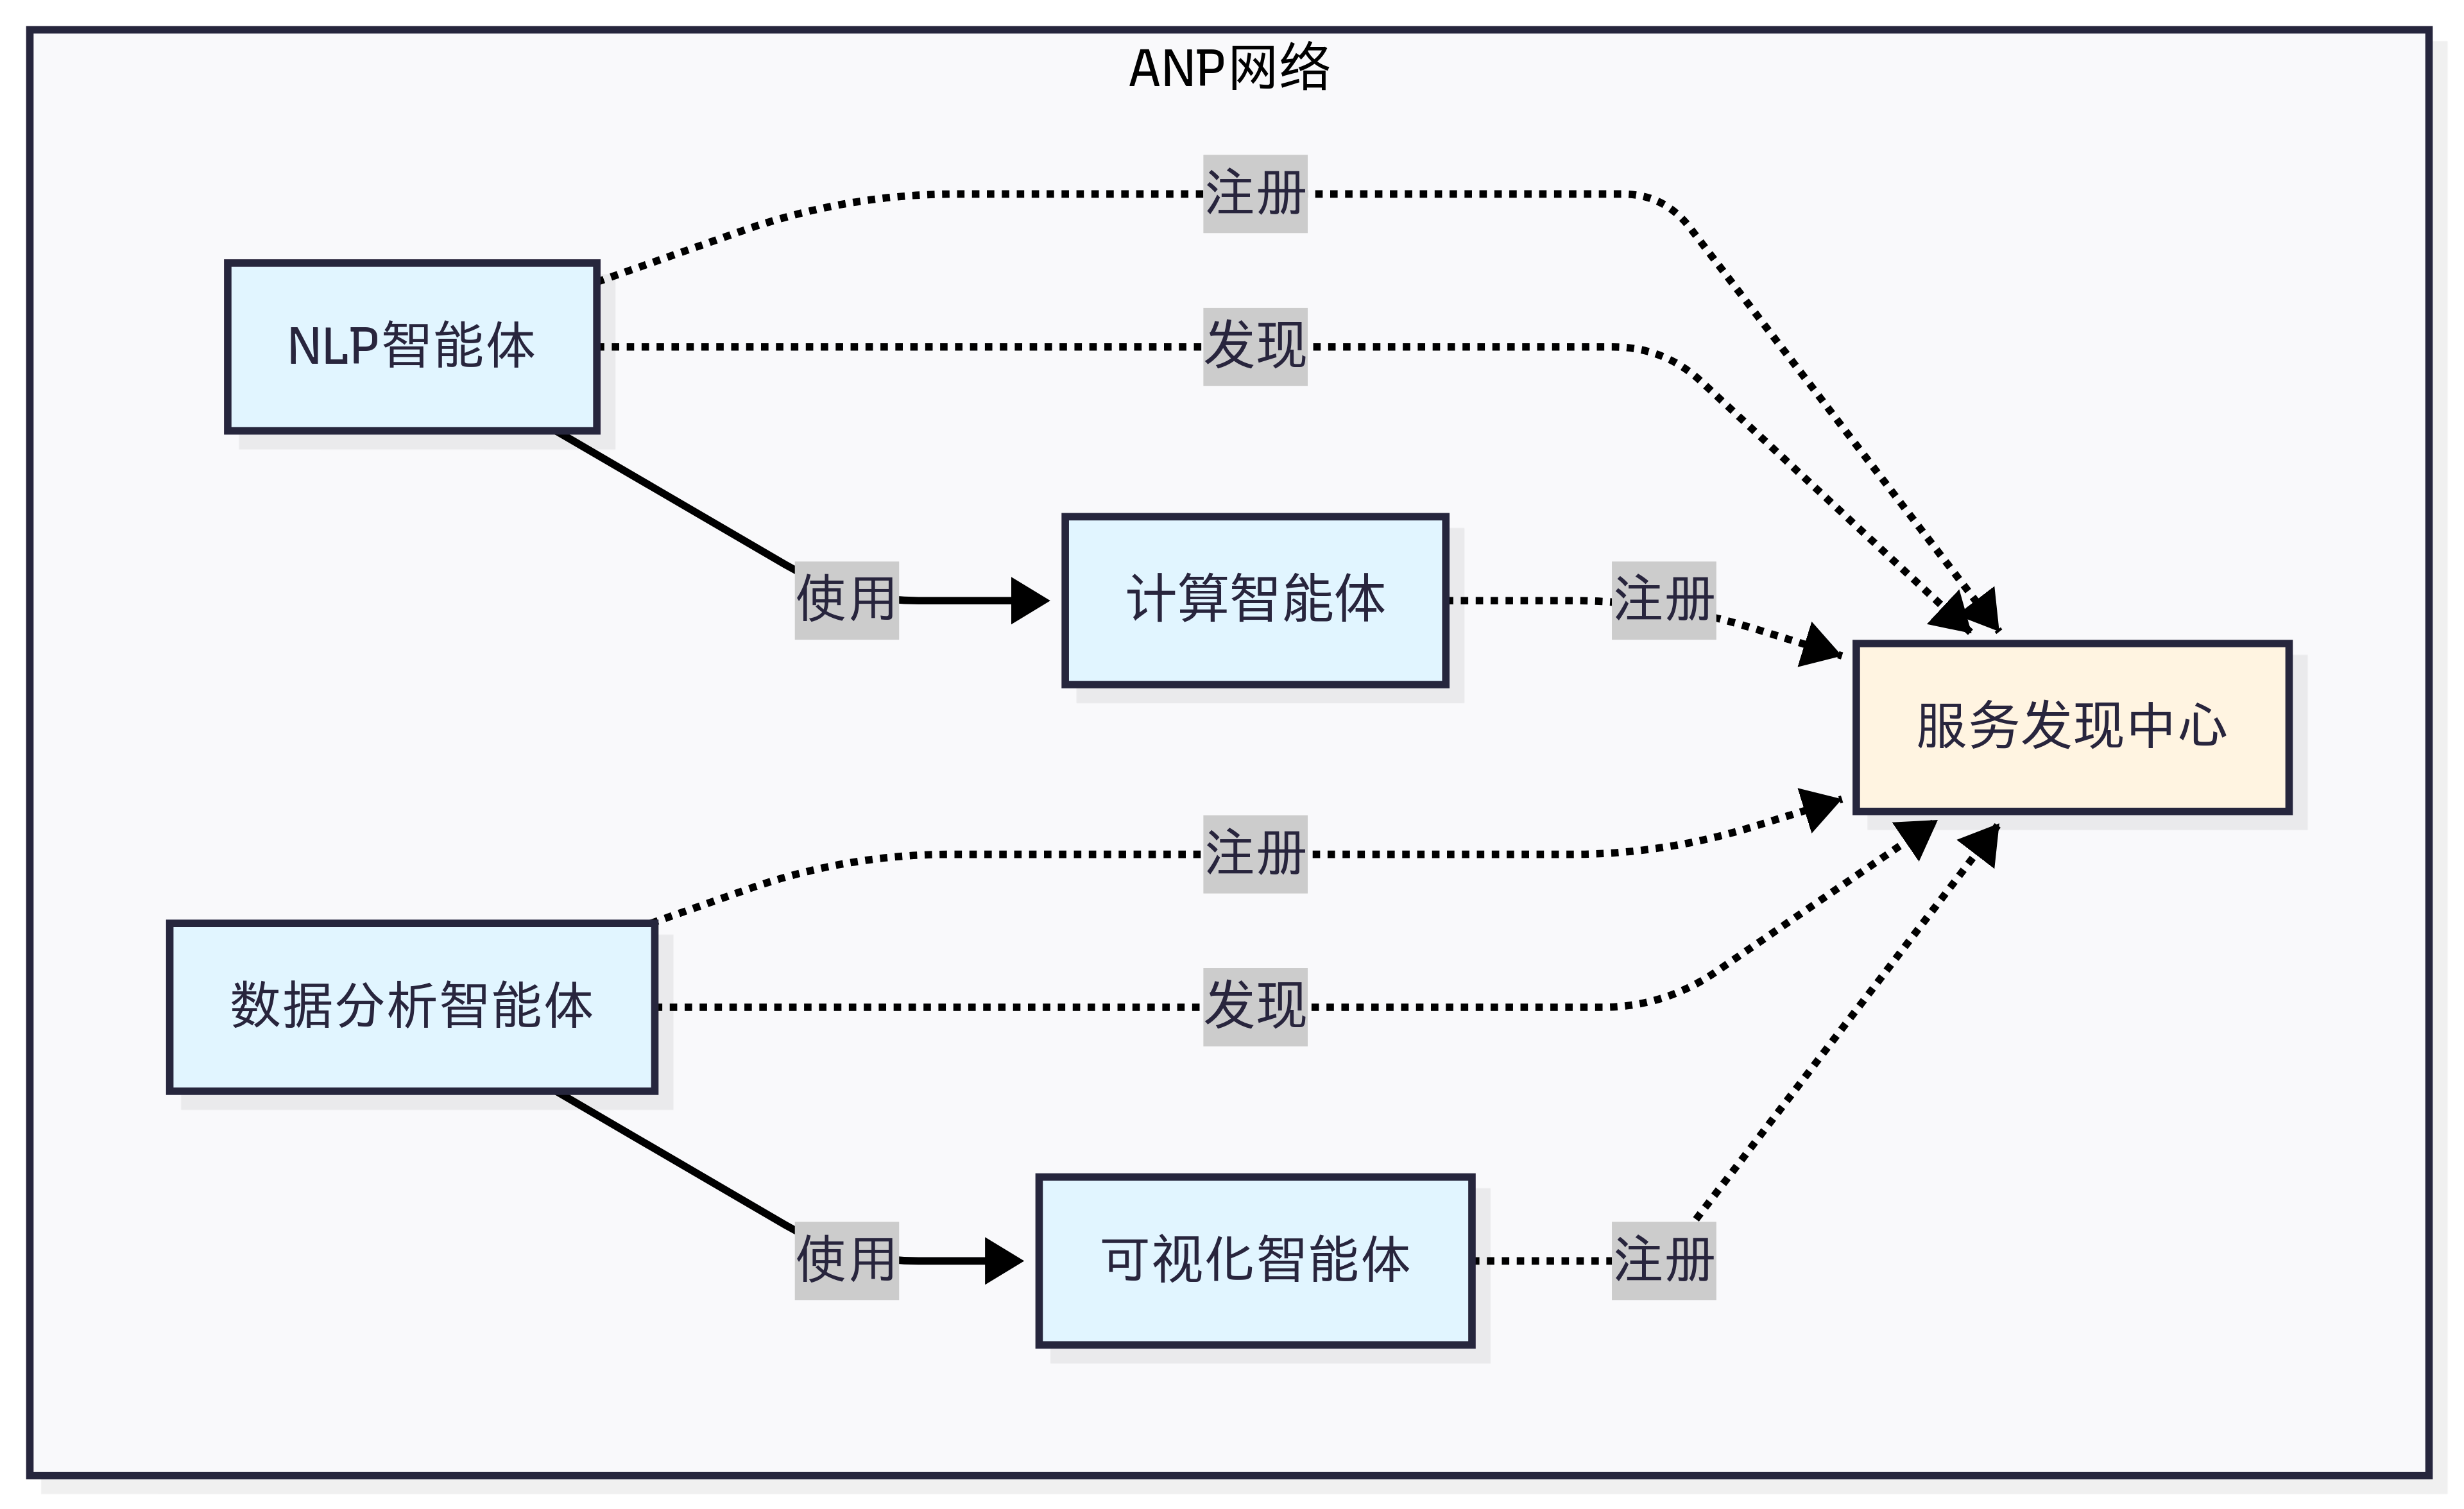
| 维度 | MCP | A2A | ANP |
|---|---|---|---|
| 设计目标 | 智能体与工具/资源的标准化通信 | 智能体间点对点通信 | 大规模智能体网络的服务发现 |
| 通信模式 | 客户端-服务器 (C/S) | 对等网络 (P2P) | 对等网络 (P2P) |
| 核心理念 | 上下文共享 | 对等协作 | 去中心化发现 |
| 适用场景 | 访问外部工具和数据源 | 智能体间的任务委托 | 大规模智能体系统 |
| 扩展性 | 通过添加 MCP 服务器扩展 | 通过添加智能体扩展 | 支持动态加入 |
| 实现状态 | 已有成熟实现 (FastMCP) | 官方 SDK 可用 | 概念性探索 |
(4)如何选择合适的协议?
目前的协议还处于发展早期,MCP 的生态相对成熟,不过各种工具的时效性取决于维护者,更推荐选择大公司背书的 MCP 工具。
选择协议的关键在于理解你的需求:
- 如果你的智能体需要访问外部服务(文件、数据库、API),选择MCP
- 如果你需要多个智能体相互协作完成任务,选择A2A
- 如果你要构建大规模的智能体生态系统,考虑ANP
Hello Agents通信协议架构设计
HelloAgents 的通信协议架构采用三层设计,从底层到上层分别是:协议实现层、工具封装层和智能体集成层。
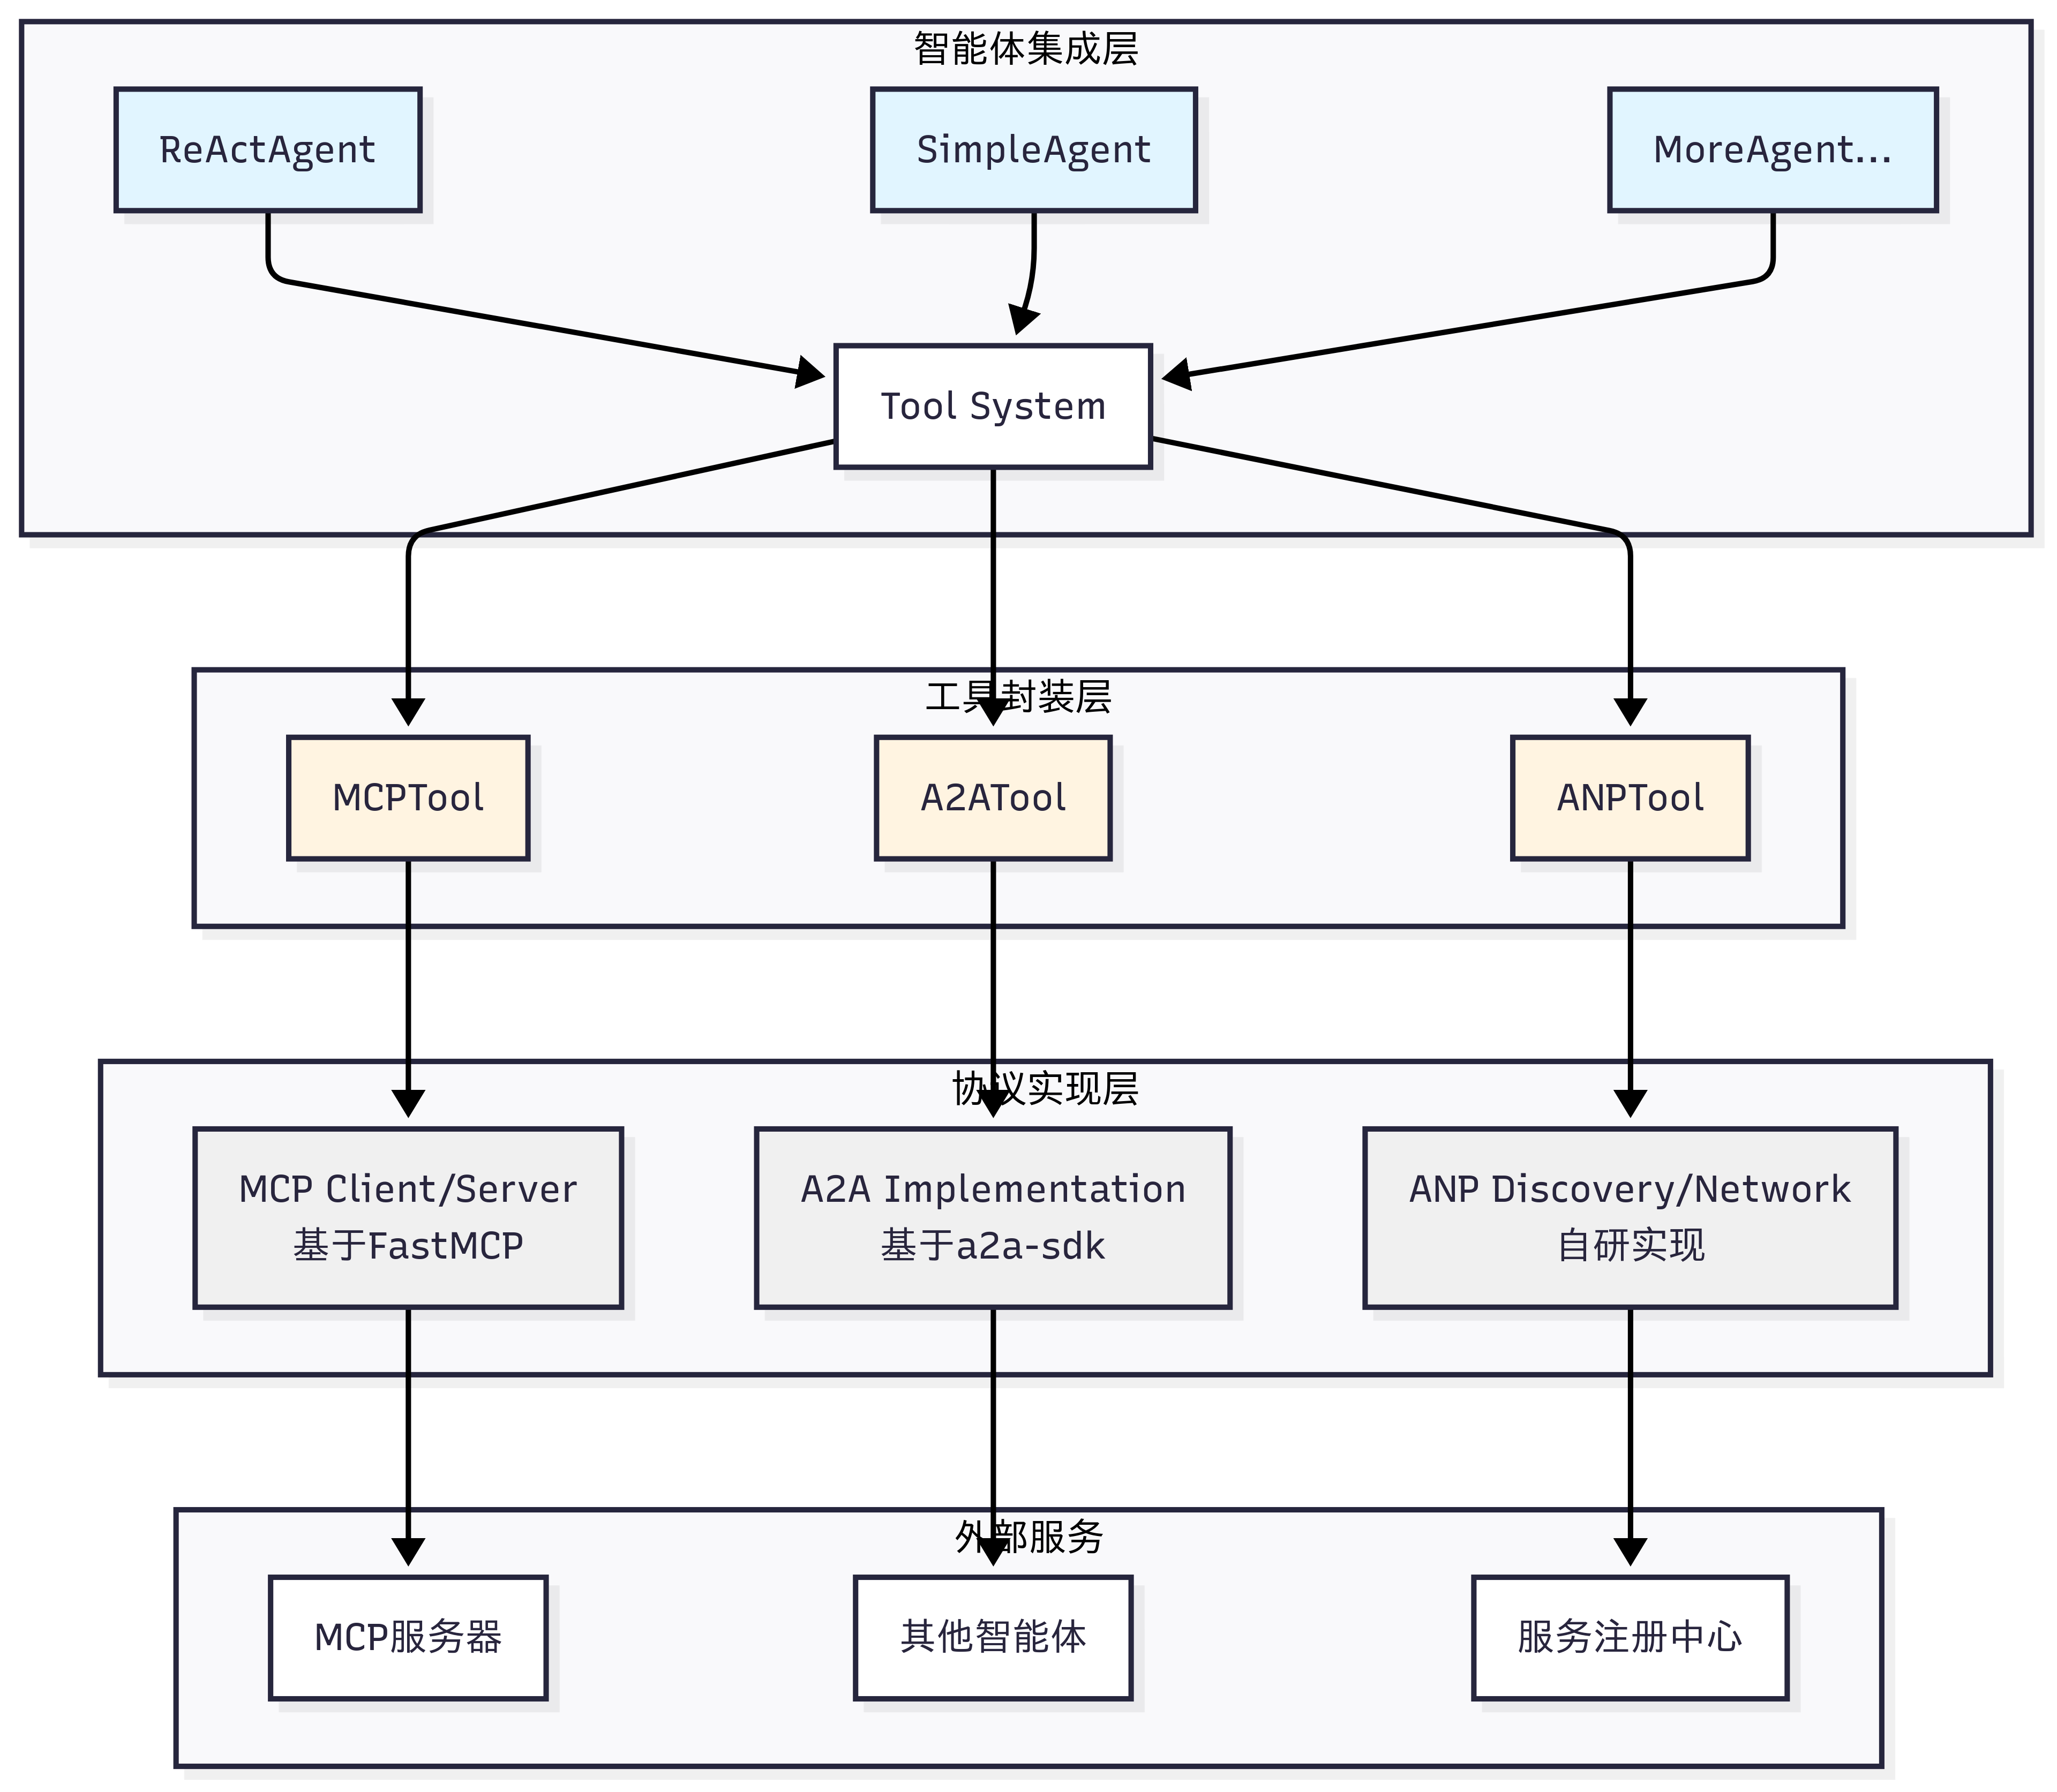
(1)协议实现层:这一层包含了三种协议的具体实现。MCP 基于 FastMCP 库实现,提供客户端和服务器功能;A2A 基于 Google 官方的 a2a-sdk 实现;ANP 是我们自研的轻量级实现,提供服务发现和网络管理功能,当然目前也有官方的实现,考虑到后期的迭代,因此这里只做概念的模拟。
(2)工具封装层:这一层将协议实现封装成统一的 Tool 接口。MCPTool、A2ATool 和 ANPTool 都继承自 BaseTool,提供一致的run()方法。这种设计让智能体能够以相同的方式使用不同的协议。
(3)智能体集成层:这一层是智能体与协议的集成点。所有的智能体(ReActAgent、SimpleAgent 等)都通过 Tool System 来使用协议工具,无需关心底层的协议细节。
MCP协议实战
(1)MCP:智能体的”USB-C”
想象一下,你的智能体可能需要同时做很多事情,例如:
- 读取本地文件系统的文档
- 查询 PostgreSQL 数据库
- 搜索 GitHub 上的代码
- 发送 Slack 消息
- 访问 Google Drive
传统方式下,你需要为每个服务编写适配器代码,处理不同的 API、认证方式、错误处理等。这不仅工作量大,而且难以维护。更重要的是,不同 LLM 平台的 function call 实现差异巨大,切换模型时需要重写大量代码。
MCP 的出现改变了这一切。它就像 USB-C 统一了各种设备的连接方式一样,MCP 统一了智能体与外部工具的交互方式。无论你使用 Claude、GPT 还是其他模型,只要它们支持 MCP 协议,就能无缝访问相同的工具和资源。
(2)MCP 架构
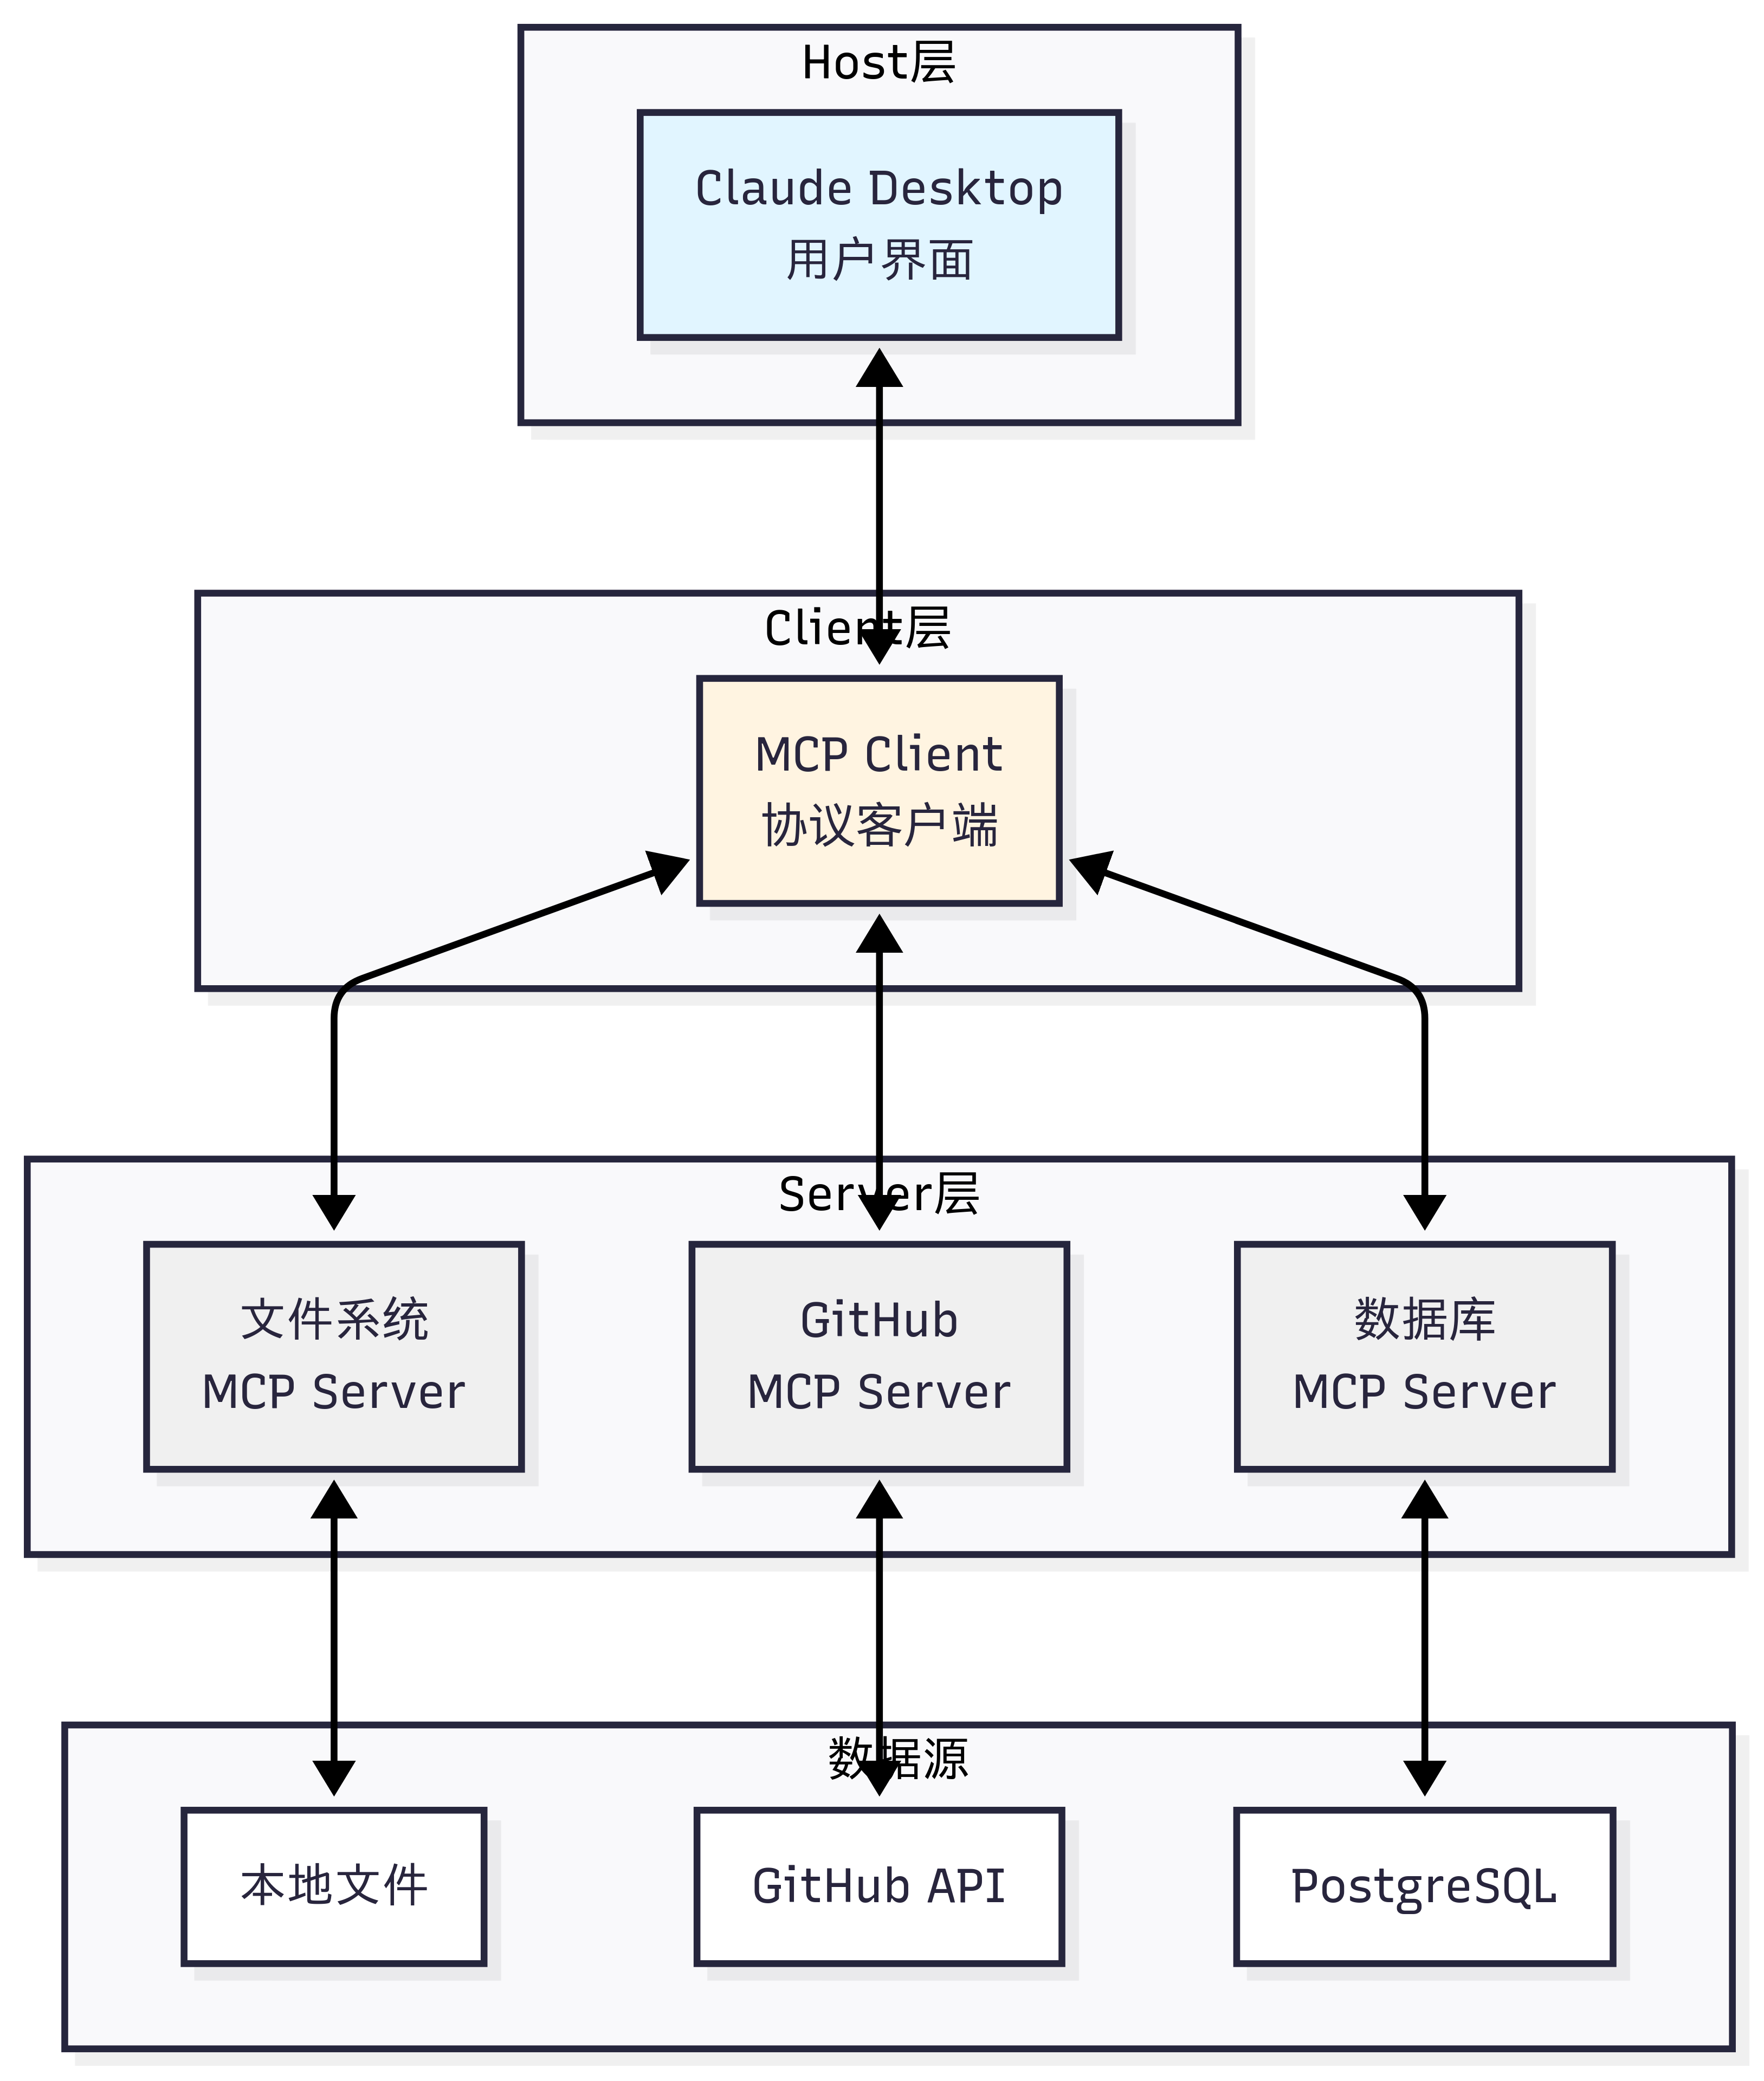
MCP 协议采用 Host、Client、Servers 三层架构设计,让我们通过图片的场景来理解这些组件如何协同工作。
假设你正在使用 Claude Desktop 询问:”我桌面上有哪些文档?”
三层架构的职责:
- Host(宿主层):Claude Desktop 作为 Host,负责接收用户提问并与 Claude 模型交互。Host 是用户直接交互的界面,它管理整个对话流程。
- Client(客户端层):当 Claude 模型决定需要访问文件系统时,Host 中内置的 MCP Client 被激活。Client 负责与适当的 MCP Server 建立连接,发送请求并接收响应。
- Server(服务器层):文件系统 MCP Server 被调用,执行实际的文件扫描操作,访问桌面目录,并返回找到的文档列表。
完整的交互流程:用户问题 → Claude Desktop(Host) → Claude 模型分析 → 需要文件信息 → MCP Client 连接 → 文件系统 MCP Server → 执行操作 → 返回结果 → Claude 生成回答 → 显示在 Claude Desktop 上
这种架构设计的优势在于关注点分离:Host 专注于用户体验,Client 专注于协议通信,Server 专注于具体功能实现。开发者只需专注于开发对应的 MCP Server,无需关心 Host 和 Client 的实现细节。
(3)MCP 的核心能力
如表所示,MCP 协议提供了三大核心能力,构成完整的工具访问框架:
| 能力 | 说明 | 使用场景 | 示例 |
|---|---|---|---|
| Tools(工具) | 可执行功能,类似函数调用 | 处理数据、调用外部 API | read_file、search_code、send_email |
| Resources(资源) | 可访问的数据,类似文件系统 | 读取数据、订阅变化 | 文件内容、数据库记录、API 响应 |
| Prompts(提示) | 预定义的提示模板 | 标准化任务、最佳实践 | 代码审查提示、文档生成提示 |
这三种能力的区别在于:Tools 是主动的(执行操作),Resources 是被动的(提供数据),Prompts 是指导性的(提供模板)。
(4)MCP 的工作流程
让我们通过一个具体例子来理解 MCP 的完整工作流程,如图所示:
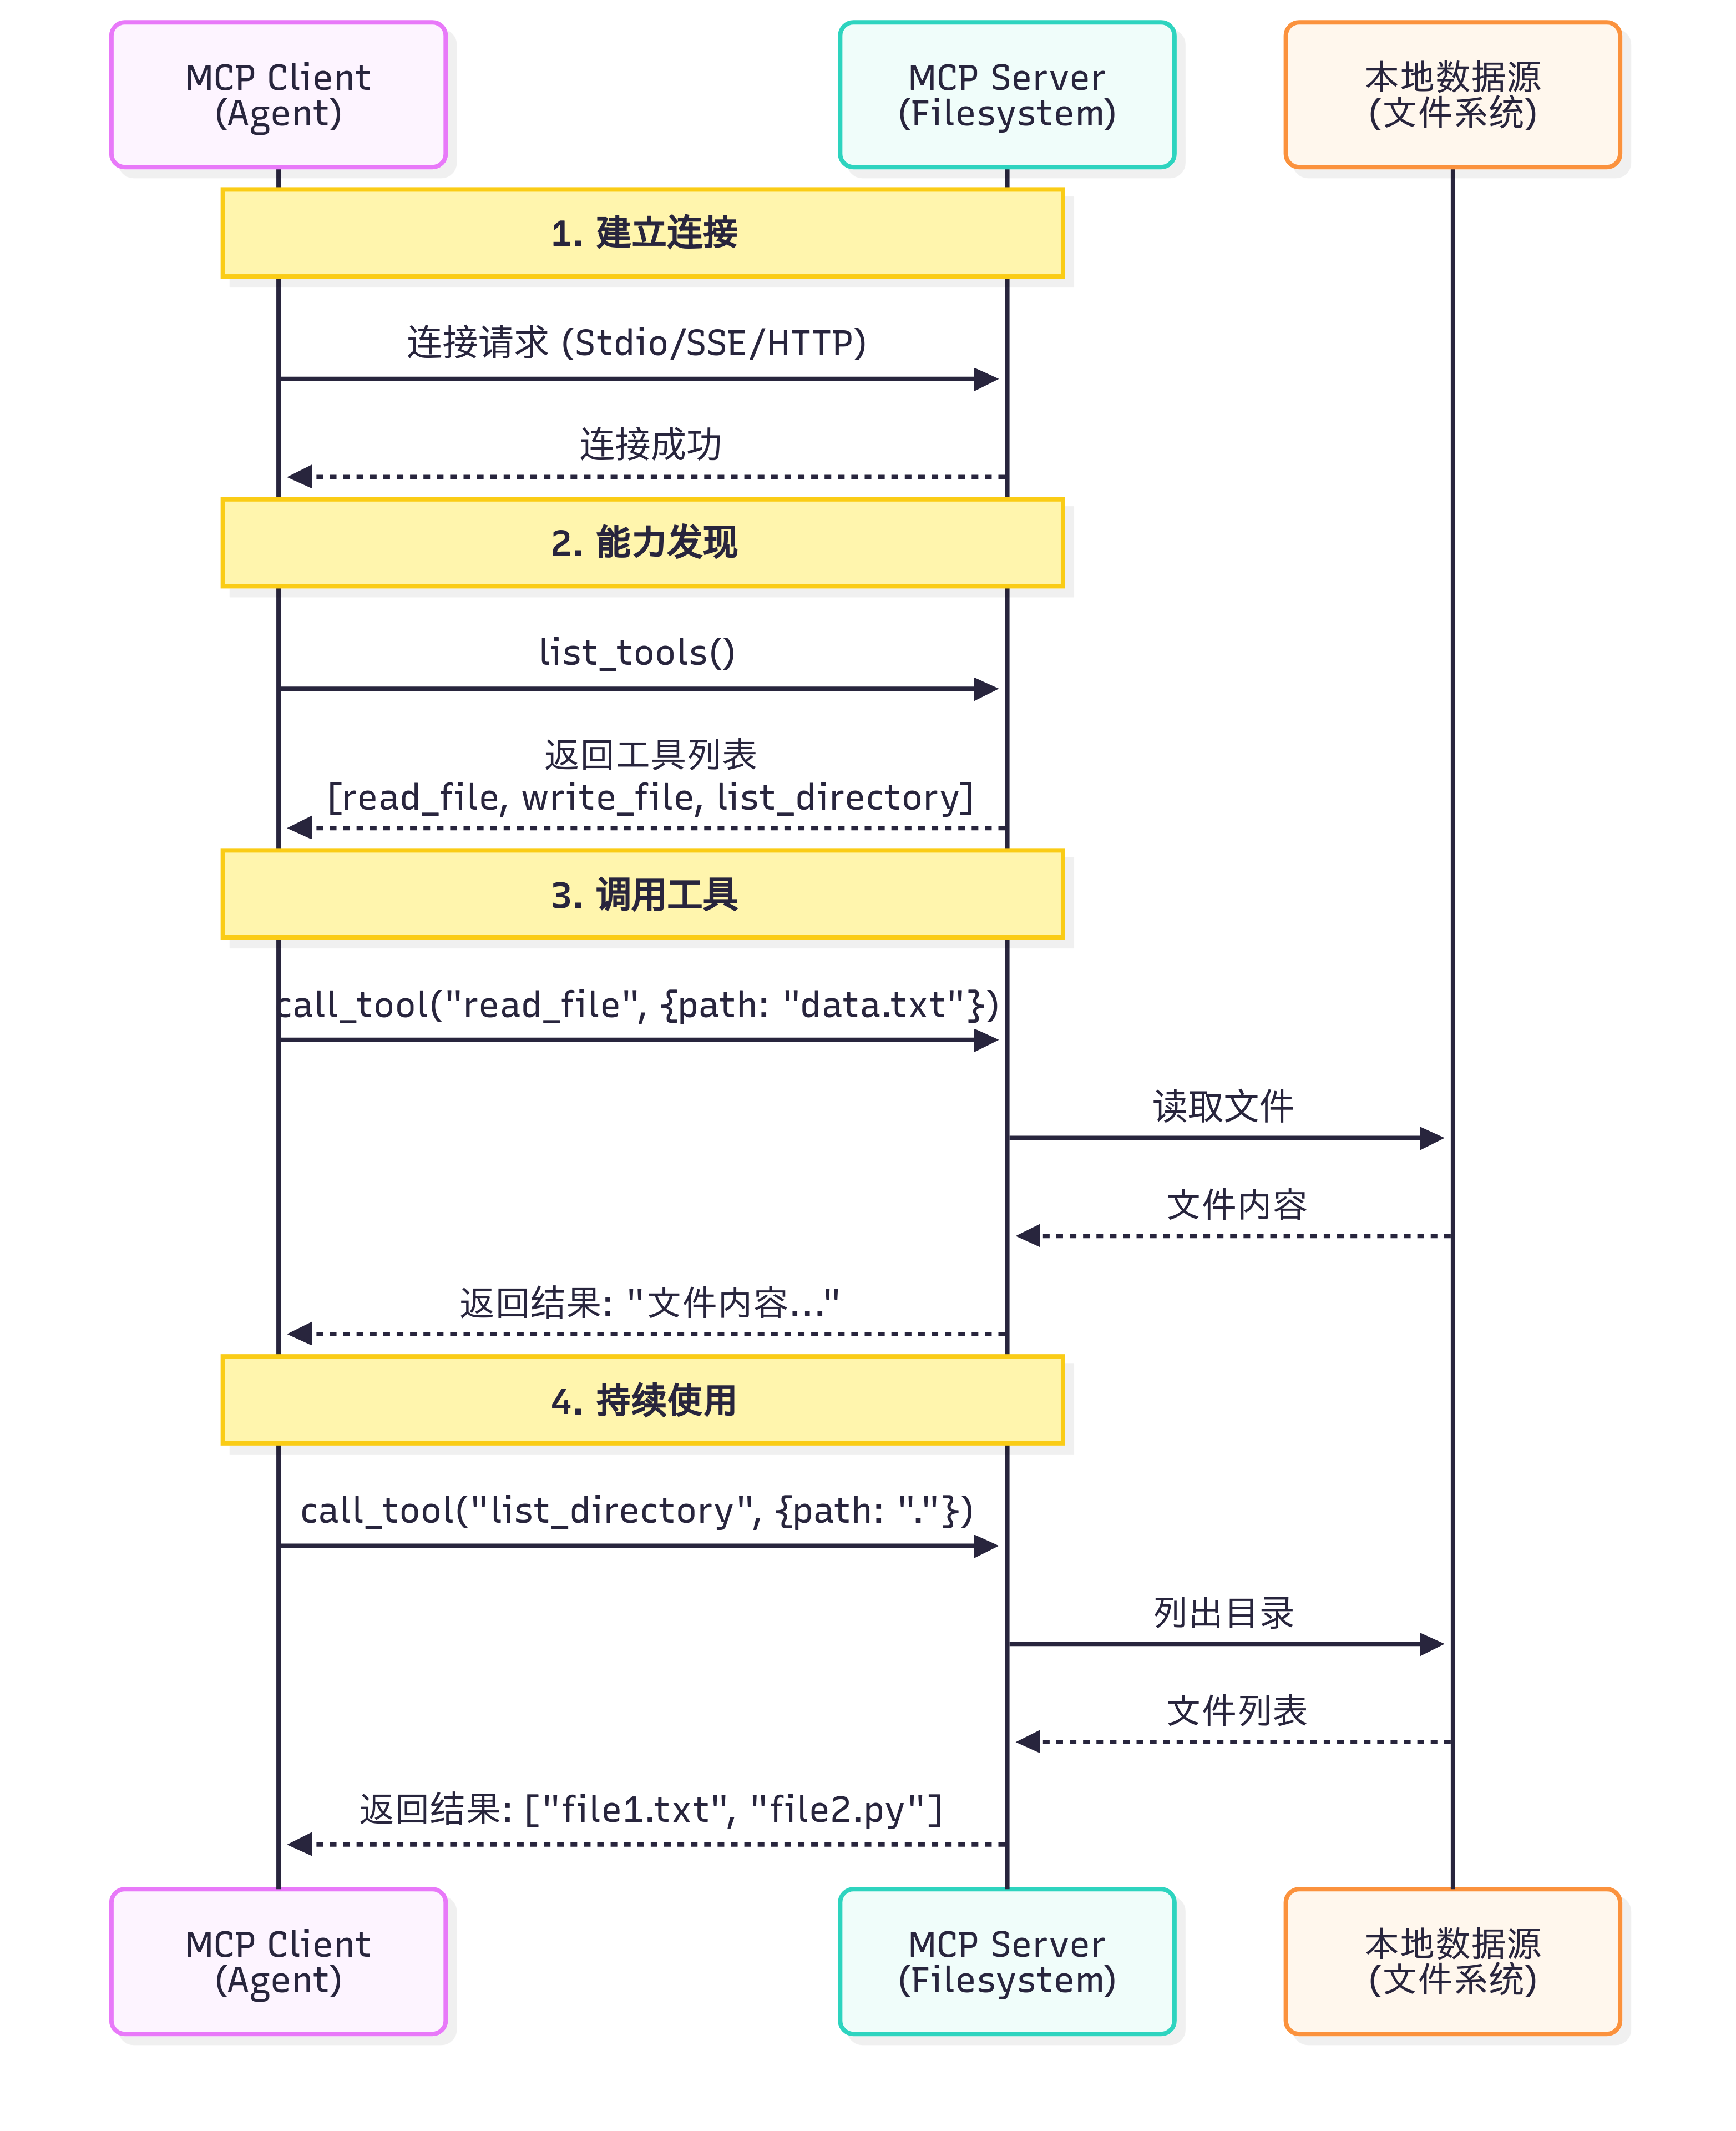
一个关键问题是:Claude(或其他 LLM)是如何决定使用哪些工具的?
当用户提出问题时,完整的工具选择流程如下:
- 工具发现阶段:MCP Client 连接到 Server 后,首先调用list_tools()获取所有可用工具的描述信息(包括工具名称、功能说明、参数定义)
- 上下文构建:Client 将工具列表转换为 LLM 能理解的格式,添加到系统提示词中。例如:
你可以使用以下工具:
- read_file(path: str): 读取指定路径的文件内容
- search_code(query: str, language: str): 在代码库中搜索
- 模型推理:LLM 分析用户问题和可用工具,决定是否需要调用工具以及调用哪个工具。这个决策基于工具的描述和当前对话上下文
- 工具执行:如果 LLM 决定使用工具,Client 通过 MCP Server 执行所选工具,获取结果
- 结果整合:工具执行结果被送回给 LLM,LLM 结合结果生成最终回答
这个过程是完全自动化的,LLM 会根据工具描述的质量来决定是否使用以及如何使用工具。因此,编写清晰、准确的工具描述至关重要。
(5)MCP 与 Function Calling 的差异
| 维度 | Function Calling | MCP |
|---|---|---|
| 本质 | LLM 的一种能力 | 标准化的通信协议 |
| 作用层级 | 模型层 | 基础设施层 |
| 解决问题 | 让 LLM 知道”如何调用函数” | 让工具和模型”如何连接” |
| 标准化 | 每个模型提供商实现不同 | 统一的协议规范 |
| 工具复用 | 需要为每个应用重写 | 社区工具可直接使用 |
这里我们以智能体需要访问 GitHub 仓库和本地文件系统为例子来详细对比同一个任务的两种实现
方式 1:使用 Function Calling
# 步骤1:为每个LLM提供商定义函数
# OpenAI格式
openai_tools = [
    {
        "type": "function",
        "function": {
            "name": "search_github",
            "description": "搜索GitHub仓库",
            "parameters": {
                "type": "object",
                "properties": {
                    "query": {"type": "string", "description": "搜索关键词"}
                },
                "required": ["query"]
            }
        }
    }
]
# Claude格式
claude_tools = [
    {
        "name": "search_github",
        "description": "搜索GitHub仓库",
        "input_schema": {  # 注意:不是parameters
            "type": "object",
            "properties": {
                "query": {"type": "string", "description": "搜索关键词"}
            },
            "required": ["query"]
        }
    }
]
# 步骤2:自己实现工具函数
def search_github(query):
    import requests
    response = requests.get(
        "https://api.github.com/search/repositories",
        params={"q": query}
    )
    return response.json()
# 步骤3:处理不同模型的响应格式
# OpenAI的响应
if response.choices[0].message.tool_calls:
    tool_call = response.choices[0].message.tool_calls[0]
    result = search_github(**json.loads(tool_call.function.arguments))
# Claude的响应
if response.content[0].type == "tool_use":
    tool_use = response.content[0]
    result = search_github(**tool_use.input)
方式 2:使用 MCP
from hello_agents.protocols import MCPClient
# 步骤1:连接到社区提供的MCP服务器(无需自己实现)
github_client = MCPClient([
    "npx", "-y", "@modelcontextprotocol/server-github"
])
fs_client = MCPClient([
    "npx", "-y", "@modelcontextprotocol/server-filesystem", "."
])
# 步骤2:统一的调用方式(与模型无关)
async with github_client:
    # 自动发现工具
    tools = await github_client.list_tools()
    # 调用工具(标准化接口)
    result = await github_client.call_tool(
        "search_repositories",
        {"query": "AI agents"}
    )
# 步骤3:任何支持MCP的模型都能使用
# OpenAI、Claude、Llama等都使用相同的MCP客户端
首先需要明确的是,Function Calling 与 MCP 并非竞争关系,而是相辅相成的。Function Calling 是大语言模型的一项核心能力,它体现了模型内在的智能,使模型能够理解何时需要调用函数,并精准生成相应的调用参数。相对地,MCP 则扮演着基础设施协议的角色,它在工程层面解决了工具与模型如何连接的问题,通过标准化的方式来描述和调用工具。
我们可以用一个简单的类比来理解:Function Calling 相当于你学会了“如何打电话”这项技能,包括何时拨号、如何与对方沟通、何时挂断。而 MCP 则是那个全球统一的“电话通信标准”,确保了任何一部电话都能顺利地拨通另一部。
MCP的传输方式详解
MCP 协议的一个重要特性是传输层无关性(Transport Agnostic)。这意味着 MCP 协议本身不依赖于特定的传输方式,可以在不同的通信通道上运行。HelloAgents 基于 FastMCP 2.0,提供了完整的传输方式支持,让你可以根据实际场景选择最合适的传输模式。
(1)传输方式概览
HelloAgents 的MCPClient支持五种传输方式,每种都有不同的使用场景,如表所示:
| 传输方式 | 适用场景 | 优点 | 缺点 |
|---|---|---|---|
| Memory | 单元测试、快速原型 | 最快、无网络开销 | 仅限同进程 |
| Stdio | 本地开发、命令行工具 | 简单、无需网络配置 | 仅限本机,可能有兼容性问题 |
| HTTP | 生产环境、远程服务 | 通用、防火墙友好 | 大流量支持、延迟较高 |
| SSE | 实时通信、流式响应 | 支持服务端推送 | 单向流式、需 HTTP 服务器 |
| StreamableHTTP | 流式 HTTP 通信 | 双向流式、HTTP 兼容 | 需要特定服务器支持 |
(2)传输方式使用示例
from hello_agents.tools import MCPTool
# 1. Memory Transport - 内存传输(用于测试)
# 不指定任何参数,使用内置演示服务器
mcp_tool = MCPTool()
# 2. Stdio Transport - 标准输入输出传输(本地开发)
# 使用命令列表启动本地服务器
mcp_tool = MCPTool(server_command=["python", "examples/mcp_example_server.py"])
# 3. Stdio Transport with Args - 带参数的命令传输
# 可以传递额外参数
mcp_tool = MCPTool(server_command=["python", "examples/mcp_example_server.py", "--debug"])
# 4. Stdio Transport - 社区服务器(npx方式)
# 使用npx启动社区MCP服务器
mcp_tool = MCPTool(server_command=["npx", "-y", "@modelcontextprotocol/server-filesystem", "."])
# 5. HTTP/SSE/StreamableHTTP Transport
# 注意:MCPTool主要用于Stdio和Memory传输
# 对于HTTP/SSE等远程传输,建议直接使用MCPClient
(3)Memory Transport - 内存传输
适用场景:单元测试、快速原型开发
from hello_agents.tools import MCPTool
# 使用内置演示服务器(Memory传输)
mcp_tool = MCPTool()
# 列出可用工具
result = mcp_tool.run({"action": "list_tools"})
print(result)
# 调用工具
result = mcp_tool.run({
    "action": "call_tool",
    "tool_name": "add",
    "arguments": {"a": 10, "b": 20}
})
print(result)
(4)Stdio Transport - 标准输入输出传输
适用场景:本地开发、调试、Python 脚本服务器
from hello_agents.tools import MCPTool
# 方式1:使用自定义Python服务器
mcp_tool = MCPTool(server_command=["python", "my_mcp_server.py"])
# 方式2:使用社区服务器(文件系统)
mcp_tool = MCPTool(server_command=["npx", "-y", "@modelcontextprotocol/server-filesystem", "."])
# 列出工具
result = mcp_tool.run({"action": "list_tools"})
print(result)
# 调用工具
result = mcp_tool.run({
    "action": "call_tool",
    "tool_name": "read_file",
    "arguments": {"path": "README.md"}
})
print(result)
(5)HTTP Transport - HTTP 传输
适用场景:生产环境、远程服务、微服务架构
# 注意:MCPTool 主要用于 Stdio 和 Memory 传输
# 对于 HTTP/SSE 等远程传输,建议使用底层的 MCPClient
import asyncio
from hello_agents.protocols import MCPClient
async def test_http_transport():
    # 连接到远程 HTTP MCP 服务器
    client = MCPClient("http://api.example.com/mcp")
    async with client:
        # 获取服务器信息
        tools = await client.list_tools()
        print(f"远程服务器工具: {len(tools)} 个")
        # 调用远程工具
        result = await client.call_tool("process_data", {
            "data": "Hello, World!",
            "operation": "uppercase"
        })
        print(f"远程处理结果: {result}")
# 注意:需要实际的 HTTP MCP 服务器
# asyncio.run(test_http_transport())
(6)SSE Transport - Server-Sent Events 传输
适用场景:实时通信、流式处理、长连接
# 注意:MCPTool 主要用于 Stdio 和 Memory 传输
# 对于 SSE 传输,建议使用底层的 MCPClient
import asyncio
from hello_agents.protocols import MCPClient
async def test_sse_transport():
    # 连接到 SSE MCP 服务器
    client = MCPClient(
        "http://localhost:8080/sse",
        transport_type="sse"
    )
    async with client:
        # SSE 特别适合流式处理
        result = await client.call_tool("stream_process", {
            "input": "大量数据处理请求",
            "stream": True
        })
        print(f"流式处理结果: {result}")
# 注意:需要支持 SSE 的 MCP 服务器
# asyncio.run(test_sse_transport())
(7)StreamableHTTP Transport - 流式 HTTP 传输
适用场景:需要双向流式通信的 HTTP 场景
# 注意:MCPTool 主要用于 Stdio 和 Memory 传输
# 对于 StreamableHTTP 传输,建议使用底层的 MCPClient
import asyncio
from hello_agents.protocols import MCPClient
async def test_streamable_http_transport():
    # 连接到 StreamableHTTP MCP 服务器
    client = MCPClient(
        "http://localhost:8080/mcp",
        transport_type="streamable_http"
    )
    async with client:
        # 支持双向流式通信
        tools = await client.list_tools()
        print(f"StreamableHTTP 服务器工具: {len(tools)} 个")
# 注意:需要支持 StreamableHTTP 的 MCP 服务器
# asyncio.run(test_streamable_http_transport())
MCP社区生态
- Awesome MCP Servers (https://github.com/punkpeye/awesome-mcp-servers)
- 社区维护的 MCP 服务器精选列表
- 包含各种第三方服务器
- 按功能分类,易于查找
- MCP Servers Website (https://mcpservers.org/)
- 官方 MCP 服务器目录网站
- 提供搜索和筛选功能
- 包含使用说明和示例
- Official MCP Servers (https://github.com/modelcontextprotocol/servers)
- Anthropic 官方维护的服务器
- 质量最高、文档最完善
- 包含常用服务的实现
社区基础 MCP 服务器:
| 服务器名称 | 功能 | NPM 包名 | 使用场景 |
|---|---|---|---|
| filesystem | 文件系统访问 | @modelcontextprotocol/server-filesystem |
读取本地文件、目录操作 |
| github | GitHub API | @modelcontextprotocol/server-github |
搜索仓库、读取代码 |
| postgres | PostgreSQL 数据库 | @modelcontextprotocol/server-postgres |
数据库查询、数据分析 |
| sqlite | SQLite 数据库 | @modelcontextprotocol/server-sqlite |
轻量级数据库操作 |
| slack | Slack 消息 | @modelcontextprotocol/server-slack |
发送消息、读取频道 |
| google-drive | Google Drive | @modelcontextprotocol/server-google-drive |
访问云端文件 |
| brave-search | Brave 搜索 | @modelcontextprotocol/server-brave-search |
网页搜索、实时信息获取 |
| fetch | 网页抓取 | @modelcontextprotocol/server-fetch |
获取网页内容、提取数据 |
生态创新型 MCP 服务器:
| 服务器名称 | 功能 | 包名 / 仓库 | 炫酷特性 |
|---|---|---|---|
| Playwright | 浏览器自动化 | @playwright/mcp |
自动化网页交互、截图、填表单 |
| Puppeteer | 浏览器控制 | mcp-server-puppeteer |
网页爬取、PDF 生成 |
| Screenpipe | 屏幕识别 | mediar-ai/screenpipe |
本地屏幕/音频捕获、时间戳搜索、语义检索 |
| Obsidian | 笔记管理 | calclavia/mcp-obsidian |
读取和搜索 Markdown 笔记、知识图谱管理 |
| Notion | 协作文档 | Badhansen/notion-mcp |
管理待办事项、数据库操作 |
| Jira | 项目管理 | nguyenvanduocit/jira-mcp |
Issue 管理、Sprint 规划、工作流 |
| Tavily | AI 搜索 | kshern/mcp-tavily |
专为 AI 优化的搜索 API |
| YouTube | 视频处理 | anaisbetts/mcp-youtube |
获取字幕、视频信息、转录内容 |
| Spotify | 音乐控制 | marcelmarais/Spotify |
播放控制、推荐音乐 |
| Wolfram Alpha | 计算知识 | ricocf/mcp-wolframalpha |
数学计算、科学数据、实时知识 |
| Sentry | 错误监控 | getsentry/sentry-mcp |
错误监控、性能分析 |
| Grafana | 可视化监控 | grafana/mcp-grafana |
查询仪表板、数据源管理 |
以下是一些特别有趣的案例 TODO 可供参考:
- Playwright
# Agent可以自动:
# - 打开浏览器访问网站
# - 填写表单并提交
# - 截图验证结果
# - 生成测试报告
playwright_tool = MCPTool(
    name="playwright",
    server_command=["npx", "-y", "@playwright/mcp"]
)
- 智能笔记助手(Obsidian + Perplexity)
# Agent可以:
# - 搜索最新技术资讯(Perplexity)
# - 整理成结构化笔记
# - 保存到Obsidian知识库
# - 自动建立笔记间的链接
- 项目管理自动化(Jira + GitHub)
# Agent可以:
# - 从GitHub Issue创建Jira任务
# - 同步代码提交到Jira
# - 自动更新Sprint进度
# - 生成项目报告
- 内容创作工作流(YouTube + Notion + Spotify)
# Agent可以:
# - 获取YouTube视频字幕
# - 生成内容摘要
# - 保存到Notion数据库
# - 播放背景音乐(Spotify)
A2A协议实战
A2A(Agent-to-Agent)是一种支持智能体之间直接通信与协作的协议。
协议设计动机
MCP 协议解决了智能体与工具的交互,而 A2A 协议则解决智能体之间的协作问题。在一个需要多智能体(如研究员、撰写员、编辑)协作的任务中,它们需要通信、委托任务、协商能力和同步状态。
传统的中央协调器(星型拓扑)方案存在三个主要问题:
- 单点故障:协调器失效导致系统整体瘫痪。
- 性能瓶颈:所有通信都经过中心节点,限制了并发。
- 扩展困难:增加或修改智能体需要改动中心逻辑。
A2A 协议采用点对点(P2P)架构(网状拓扑),允许智能体直接通信,从根本上解决了上述问题。它的核心是任务(Task)和工件(Artifact)这两个抽象概念,这是它与 MCP 最大的区别,如表所示。
| 概念 | 说明 | 与 MCP 的区别 | 示例 |
|---|---|---|---|
| Task(任务) | 智能体之间委托的单元 | 比 Tool 更高层次的抽象 | “撰写一篇关于 AI 的文章” |
| Artifact(工件) | 任务执行产生的结果 | 比 Resource 更结构化 | 文章文本、分析报告 |
| Message(消息) | 智能体间通信载体 | 包含任务状态信息 | “任务已完成 50%” |
| Part(部分) | 消息的组成部分 | 支持多模态内容 | 文本、图片、文件 |
| Agent Card | 智能体能力描述文档 | 类似 MCP 的工具描述 | JSON 格式的能力声明 |
为实现对协作过程的管理,A2A 为任务定义了标准化的生命周期,包括创建、协商、代理、执行中、完成、失败等状态。
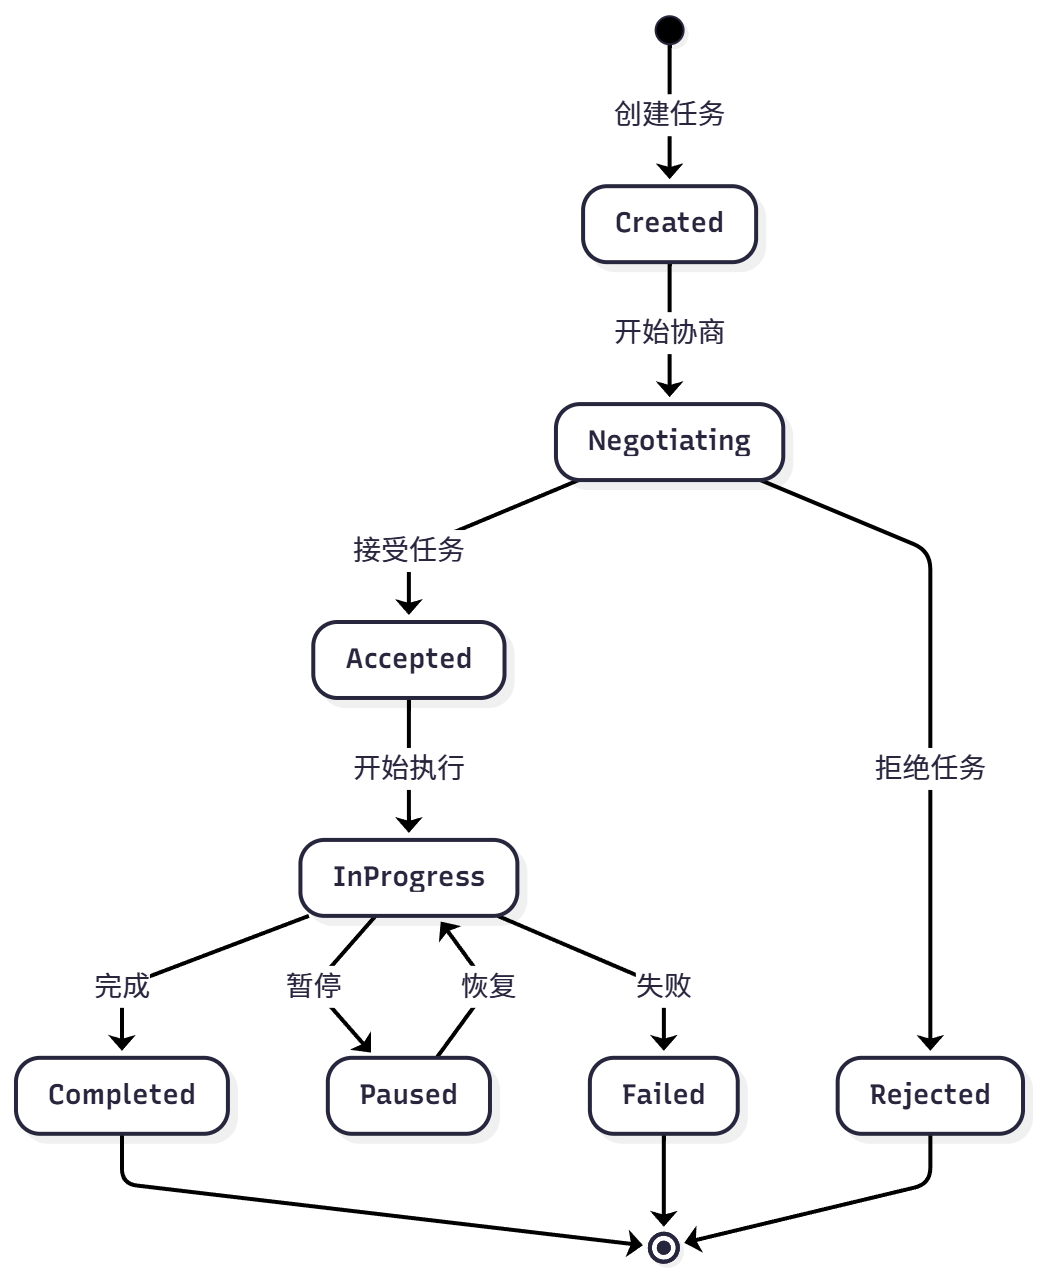
该机制使智能体可以进行任务协商、进度跟踪和异常处理。
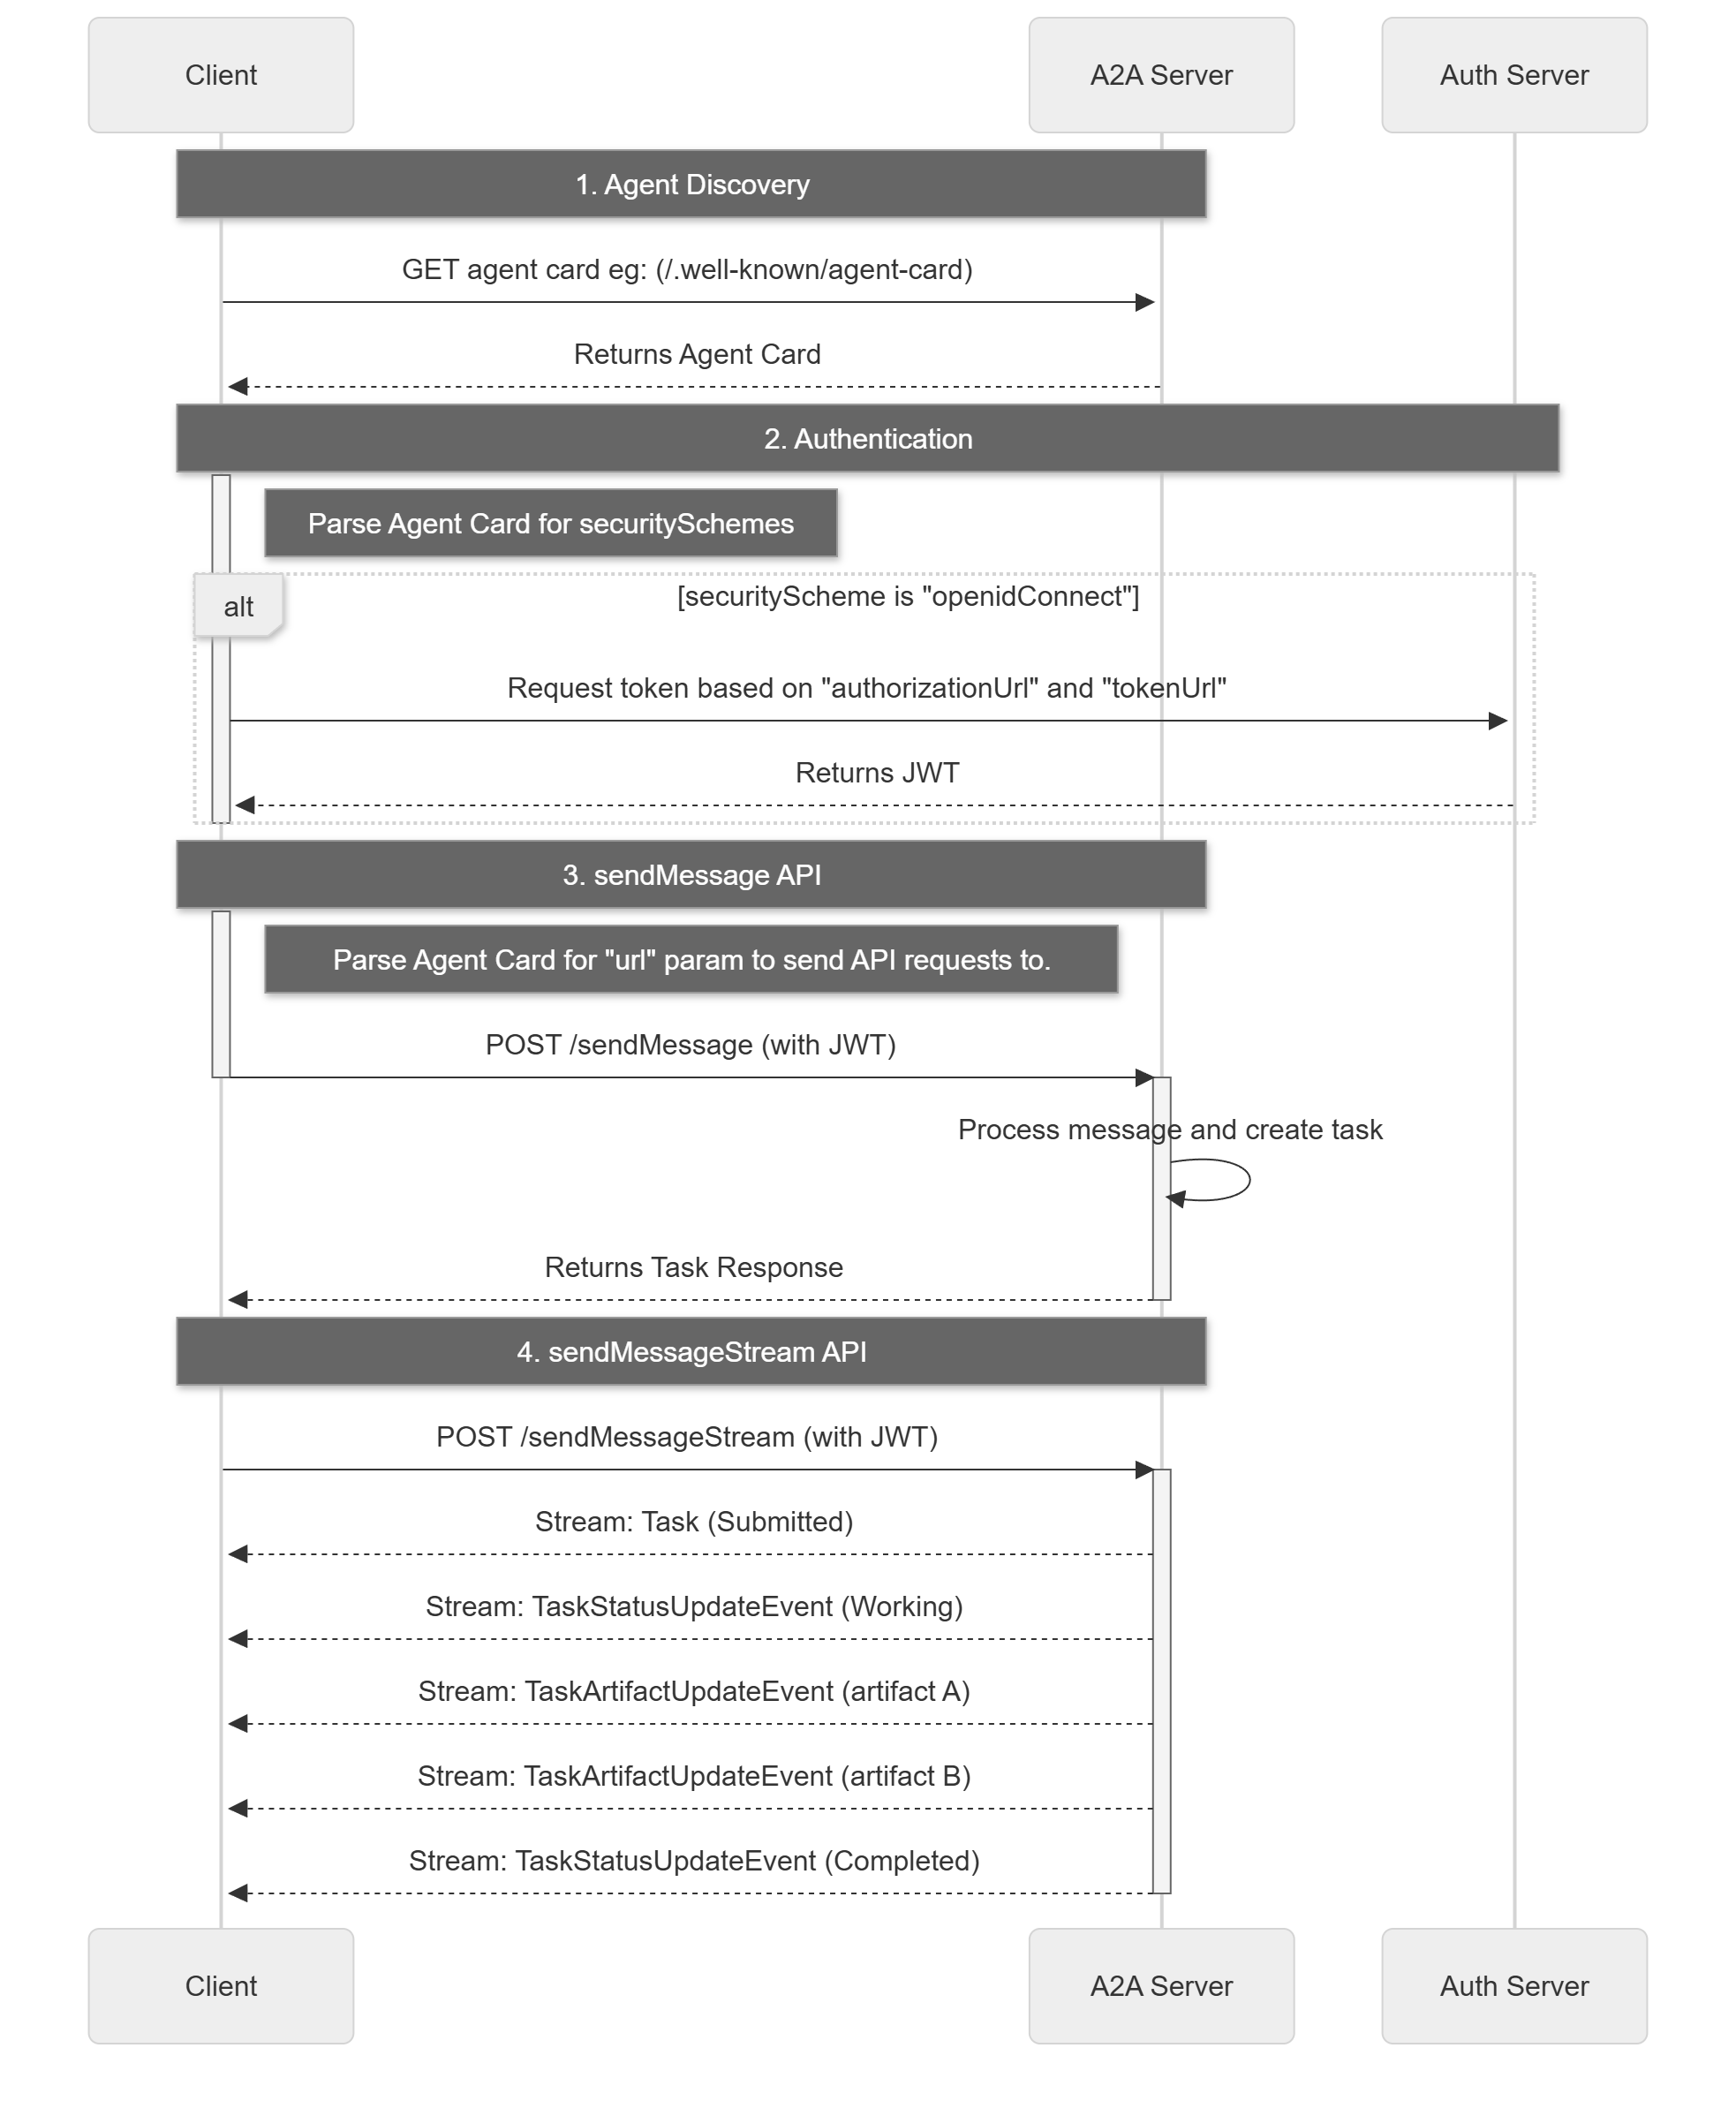
A2A 请求生命周期是一个序列,详细说明了请求遵循的四个主要步骤:代理发现、身份验证、发送消息 API 和发送消息流 API。下图借鉴了官网的流程图,用来展示了操作流程,说明了客户端、A2A 服务器和身份验证服务器之间的交互。
ANP协议实战
在 MCP 协议解决了工具调用、A2A 协议解决点对点智能体协作之后,ANP 协议则专注于解决大规模、开放网络环境下的智能体管理问题。
我们学习了 MCP(工具访问)和 A2A(智能体协作)。现在,让我们学习 ANP(Agent Network Protocol)协议,它专注于构建大规模、开放的智能体网络。
协议目标
当一个网络中存在大量功能各异的智能体(例如,自然语言处理、图像识别、数据分析等)时,系统会面临一系列挑战:
- 服务发现:当新任务到达时,如何快速找到能够处理该任务的智能体?
- 智能路由:如果多个智能体都能处理同一任务,如何选择最合适的一个(如根据负载、成本等)并向其分派任务?
- 动态扩展:如何让新加入网络的智能体被其他成员发现和调用?
ANP 的设计目标就是提供一套标准化的机制,来解决上述的服务发现、路由选择和网络扩展性问题。
为实现其设计目标,ANP 定义了以下几个核心概念,如表所示:
| 概念 | 说明 | 示例 |
|---|---|---|
| ANP Discovery | 服务发现中心,用于注册和查询网络中的智能体服务 | 中央服务器或一个 P2P / DHT 网络 |
| Service Info | 描述智能体服务的信息:地址、能力、负载状态等元数据 | {"agent_id": "nlp-agent-01", ...} |
| ANP Network Capability Metadata | 描述智能体的能力标签,用于服务发现的查询匹配;以及服务的动态状态元数据,供商业决策 | “text_analysis”、”image_processing”、价格、负载情况、软件版本等 |
借用官方的入门指南来介绍 ANP 的架构设计,如图所示:
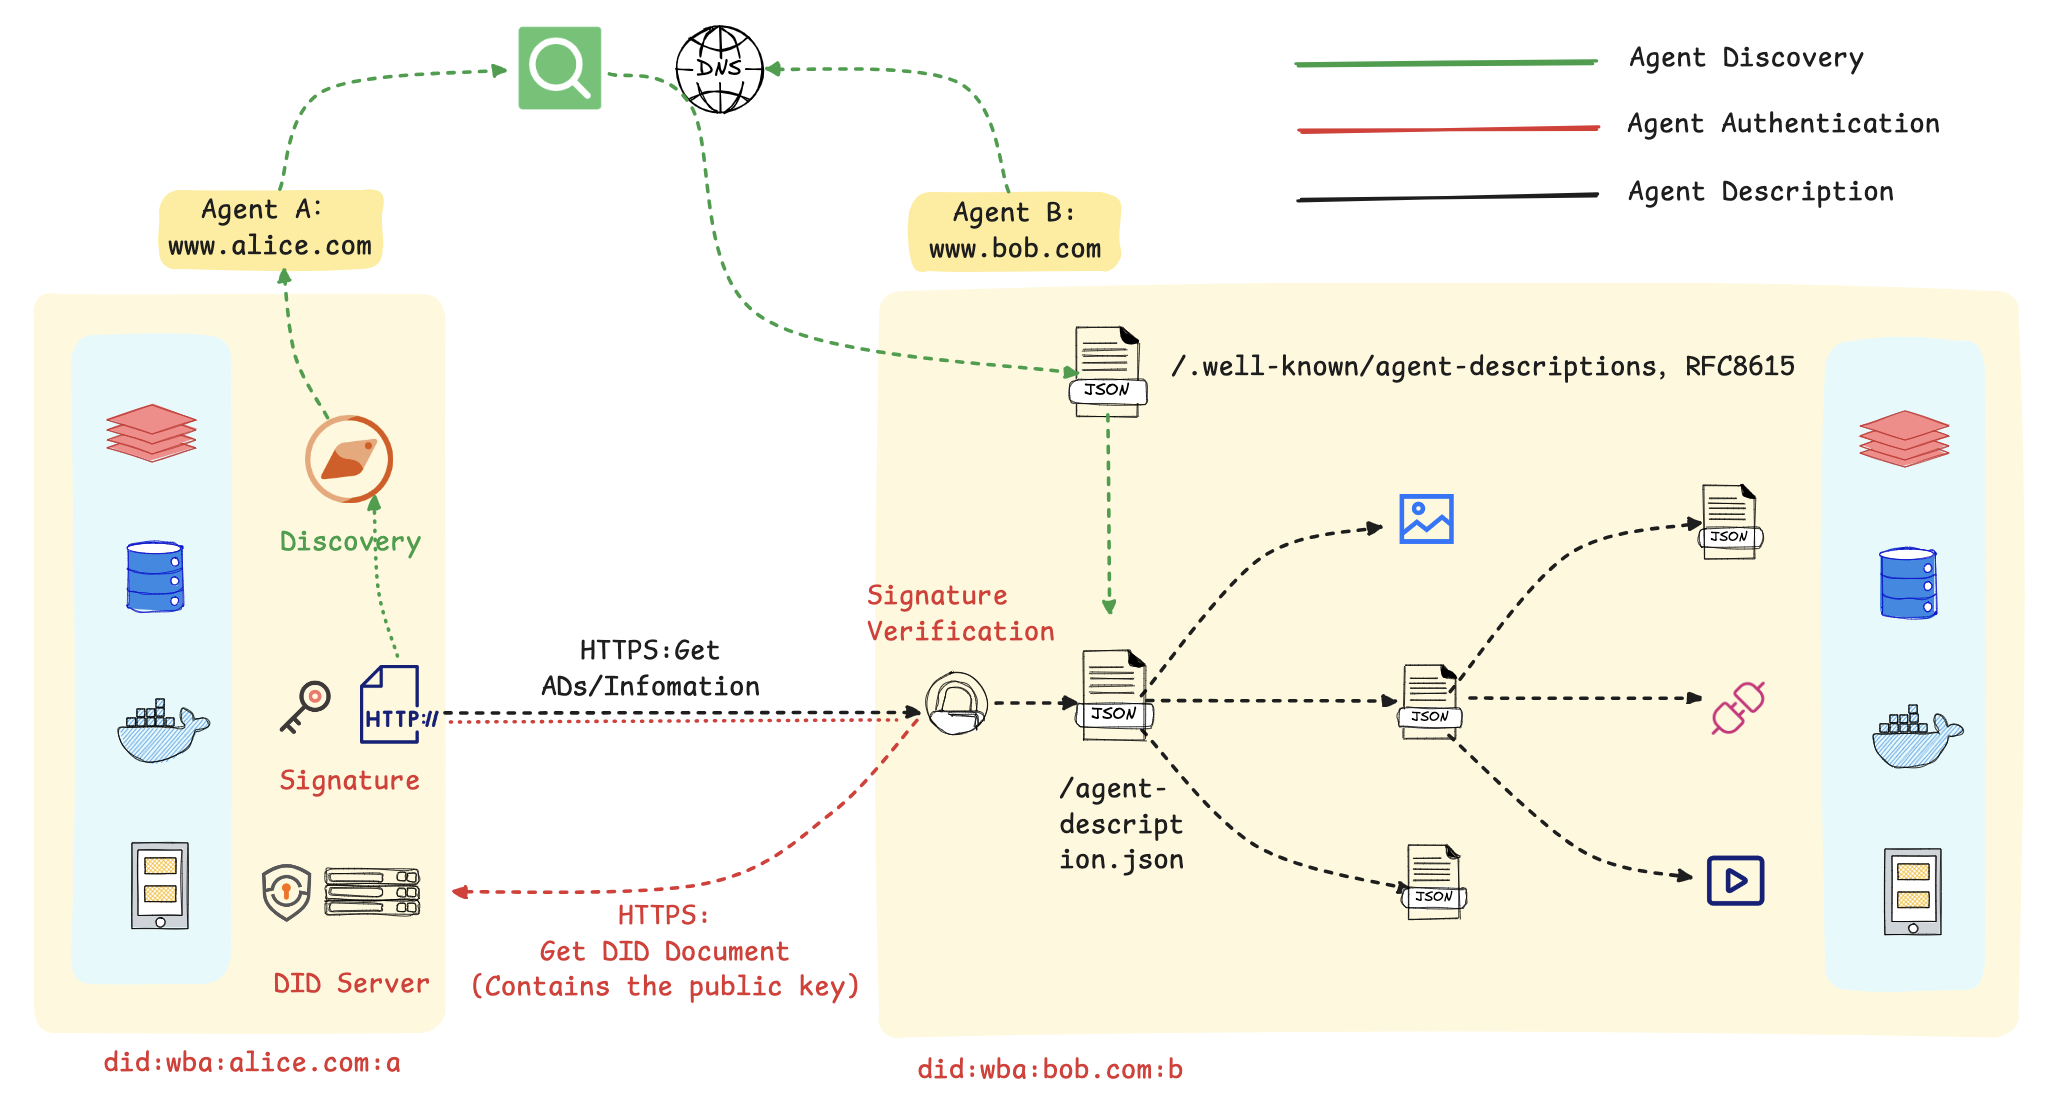
在这个流程图里,主要包括以下几个步骤:
-
服务的发现与匹配:首先,智能体 A 通过一个公开的发现服务,基于语义或功能描述进行查询,以定位到符合其任务需求的智能体 B。该发现服务通过预先爬取各智能体对外暴露的标准端点(.well-known/agent-descriptions)来建立索引,从而实现服务需求方与提供方的动态匹配。
-
基于 DID 的身份验证:在交互开始时,智能体 A 使用其私钥对包含自身 DID 的请求进行签名。智能体 B 收到后,通过解析该 DID 获取对应的公钥,并以此验证签名的真实性与请求的完整性,从而建立起双方的可信通信。
-
标准化的服务执行:身份验证通过后,智能体 B 响应请求,双方依据预定义的标准接口和数据格式进行数据交换或服务调用(如预订、查询等)。标准化的交互流程是实现跨平台、跨系统互操作性的基础。
总而言之,该机制的核心是利用 DID 构建了一个去中心化的信任根基,并借助标准化的描述协议实现了服务的动态发现。这套方法使得智能体能够在无需中央协调的前提下,安全、高效地在互联网上形成协作网络。
使用ANP服务发现
(1)创建服务发现中心
from hello_agents.protocols import ANPDiscovery, register_service
# 创建服务发现中心
discovery = ANPDiscovery()
# 注册Agent服务
register_service(
    discovery=discovery,
    service_id="nlp_agent_1",
    service_name="NLP处理专家A",
    service_type="nlp",
    capabilities=["text_analysis", "sentiment_analysis", "ner"],
    endpoint="http://localhost:8001",
    metadata={"load": 0.3, "price": 0.01, "version": "1.0.0"}
)
register_service(
    discovery=discovery,
    service_id="nlp_agent_2",
    service_name="NLP处理专家B",
    service_type="nlp",
    capabilities=["text_analysis", "translation"],
    endpoint="http://localhost:8002",
    metadata={"load": 0.7, "price": 0.02, "version": "1.1.0"}
)
print("✅ 服务注册完成")
(2)发现服务
from hello_agents.protocols import discover_service
# 按类型查找
nlp_services = discover_service(discovery, service_type="nlp")
print(f"找到 {len(nlp_services)} 个NLP服务")
# 选择负载最低的服务
best_service = min(nlp_services, key=lambda s: s.metadata.get("load", 1.0))
print(f"最佳服务:{best_service.service_name} (负载: {best_service.metadata['load']})")
(3)构建agent网络
from hello_agents.protocols import ANPNetwork
# 创建网络
network = ANPNetwork(network_id="ai_cluster")
# 添加节点
for service in discovery.list_all_services():
    network.add_node(service.service_id, service.endpoint)
# 建立连接(根据能力匹配)
network.connect_nodes("nlp_agent_1", "nlp_agent_2")
stats = network.get_network_stats()
print(f"✅ 网络构建完成,共 {stats['total_nodes']} 个节点")
构建自定义MCP服务器
(1)为什么要构建自定义 MCP 服务器?
虽然可以直接使用公开的 MCP 服务,但在许多实际应用场景中,需要构建自定义的 MCP 服务器以满足特定需求。
主要动机包括以下几点:
- 封装业务逻辑:将企业内部特有的业务流程或复杂操作封装为标准化的 MCP 工具,供智能体统一调用。
- 访问私有数据:创建一个安全可控的接口或代理,用于访问内部数据库、API 或其他无法对公网暴露的私有数据源。
- 性能专项优化:针对高频调用或对响应延迟有严苛要求的应用场景,进行深度优化。
- 功能定制扩展:实现标准 MCP 服务未提供的特定功能,例如集成专有算法模型或连接特定的硬件设备。
上传MCP服务器
我们创建了一个真实的天气查询 MCP 服务器。现在,让我们将它发布到 Smithery 平台,让全世界的开发者都能使用我们的服务。
(1)什么是 Smithery?
Smithery 是 MCP 服务器的官方发布平台,类似于 Python 的 PyPI 或 Node.js 的 npm。通过 Smithery,用户可以:
- 🔍 发现和搜索 MCP 服务器
- 📦 一键安装 MCP 服务器
- 📊 查看服务器的使用统计和评价
- 🔄 自动获取服务器更新
(2)准备发布
首先,需要将项目整理成标准的发布格式,这个文件夹已经在code目录下整理好,可供参考:
weather-mcp-server/
├── README.md         # 项目说明文档
├── LICENSE           # 开源许可证
├── Dockerfile        # Docker 构建配置(推荐)
├── pyproject.toml    # Python 项目配置(必需)
├── requirements.txt  # Python 依赖
├── smithery.yaml     # Smithery 配置文件(必需)
└── server.py         # MCP 服务器主文件
需要注意的是,smithery.yaml是 Smithery 平台的配置文件:
name: weather-mcp-server
displayName: Weather MCP Server
description: Real-time weather query MCP server based on HelloAgents framework
version: 1.0.0
author: HelloAgents Team
homepage: https://github.com/yourusername/weather-mcp-server
license: MIT
categories:
  - weather
  - data
tags:
  - weather
  - real-time
  - helloagents
  - wttr
runtime: container
build:
  dockerfile: Dockerfile
  dockerBuildPath: .
startCommand:
  type: http
tools:
  - name: get_weather
    description: Get current weather for a city
  - name: list_supported_cities
    description: List all supported cities
  - name: get_server_info
    description: Get server information
配置说明:
- name: 服务器的唯一标识符(小写,用连字符分隔)
- displayName: 显示名称
- description: 简短描述
- version: 版本号(遵循语义化版本)
- runtime: 运行时环境(python/node)
- entrypoint: 入口文件
- tools: 工具列表
pyproject.toml是 Python 项目的标准配置文件,Smithery 要求必须包含此文件,因为后续会打包成一个 server:
[build-system]
requires = ["setuptools>=61.0", "wheel"]
build-backend = "setuptools.build_meta"
[project]
name = "weather-mcp-server"
version = "1.0.0"
description = "Real-time weather query MCP server based on HelloAgents framework"
readme = "README.md"
license = {text = "MIT"}
authors = [
    {name = "HelloAgents Team", email = "xxx"}
]
requires-python = ">=3.10"
dependencies = [
    "hello-agents>=0.2.1",
    "requests>=2.31.0",
]
[project.urls]
Homepage = "https://github.com/yourusername/weather-mcp-server"
Repository = "https://github.com/yourusername/weather-mcp-server"
"Bug Tracker" = "https://github.com/yourusername/weather-mcp-server/issues"
[tool.setuptools]
py-modules = ["server"]
配置说明:
-
- name: 项目名称
- version: 版本号(遵循语义化版本)
- dependencies: 项目依赖列表
- requires-python: Python 版本要求
虽然 Smithery 会自动生成 Dockerfile,但提供自定义 Dockerfile 可以确保部署成功:
# Multi-stage build for weather-mcp-server
FROM python:3.12-slim-bookworm as base
# Set working directory
WORKDIR /app
# Install system dependencies
RUN apt-get update && apt-get install -y \
    --no-install-recommends \
    && rm -rf /var/lib/apt/lists/*
# Copy project files
COPY pyproject.toml requirements.txt ./
COPY server.py ./
# Install Python dependencies
RUN pip install --no-cache-dir --upgrade pip && \
    pip install --no-cache-dir -r requirements.txt
# Set environment variables
ENV PYTHONUNBUFFERED=1
ENV PORT=8081
# Expose port (Smithery uses 8081)
EXPOSE 8081
# Health check
HEALTHCHECK --interval=30s --timeout=3s --start-period=5s --retries=3 \
    CMD python -c "
import sys; sys.exit(0)"
# Run the MCP server
CMD ["python", "server.py"]
Dockerfile 配置说明:
- 基础镜像: python:3.12-slim-bookworm - 轻量级 Python 镜像
- 工作目录: /app - 应用程序根目录
- 端口: 8081 - Smithery 平台标准端口
- 启动命令: python server.py - 运行 MCP 服务器
(3)提交到 Smithery
打开浏览器,访问 https://smithery.ai/。使用 GitHub 账号登录 Smithery。点击页面上的 “Publish Server” 按钮,输入你的 GitHub 仓库 URL:https://github.com/yourusername/weather-mcp-server,即可等待发布。
Agentic RL
从LLM训练到Agentic RL
如何让智能体具备更强的推理能力?如何让智能体学会更好地使用工具?如何让智能体能够自我改进?
这正是 Agentic RL(基于强化学习的智能体训练)要解决的核心问题。本章将为Agents框架引入强化学习训练能力,训练出具备推理、工具使用等高级能力的智能体。我们将从 LLM 训练的基础知识开始,逐步深入到监督微调(Supervised Fine-Tuning,SFT)、群组相对策略优化(Group Relative Policy Optimization, GRPO)等实用技术,最终构建一个完整的智能体训练 pipeline。
从强化学习到Agentic RL
强化学习(Reinforcement Learning, RL)是一种专注于解决序贯决策问题的学习范式,它通过智能体与环境的直接交互,在”试错”中学习如何最大化长期收益。
现在,让我们将这个框架应用到 LLM 智能体上。考虑一个数学问题求解智能体,它需要回答这样的问题:
问题: Janet's ducks lay 16 eggs per day. She eats three for breakfast
every morning and bakes muffins for her friends every day with four.
She sells the remainder at the farmers' market daily for $2 per fresh
duck egg. How much in dollars does she make every day at the farmers' market?
这个问题需要多步推理:首先计算 Janet 每天剩余的鸡蛋数量(16 - 3 - 4 = 9),然后计算她的收入(9 × 2 = 18)。我们可以将这个任务映射到强化学习框架:
- 智能体:基于 LLM 的推理系统
- 环境:数学问题和验证系统
- 状态:当前的问题描述和已有的推理步骤
- 行动:生成下一步推理或最终答案
- 奖励:答案是否正确(正确+1,错误 0)
传统的监督学习方法存在三个核心局限:一是数据质量完全决定训练质量,模型只能模仿训练数据,难以超越;二是缺乏探索能力,只能被动学习人类提供的路径;三是难以优化长期目标,无法精确优化多步推理的中间过程。
强化学习提供了新的可能性。通过让智能体自主生成多个候选答案并根据正确性获得奖励,它可以学习哪些推理路径更优、哪些步骤是关键,甚至发现比人类标注更好的解题方法。这就是 Agentic RL 的核心思想:将 LLM 作为可学习策略,嵌入智能体的感知-决策-执行循环,通过强化学习优化多步任务表现。
LLM训练全景图
在深入 Agentic RL 之前,我们需要先理解 LLM 训练的完整流程。一个强大的 LLM(如 GPT、Claude、Qwen)的诞生,通常要经历两个主要阶段:预训练(Pretraining)和后训练(Post-training)。如图所示,这两个阶段构成了 LLM 从”语言模型”到”对话助手”的完整演化路径。
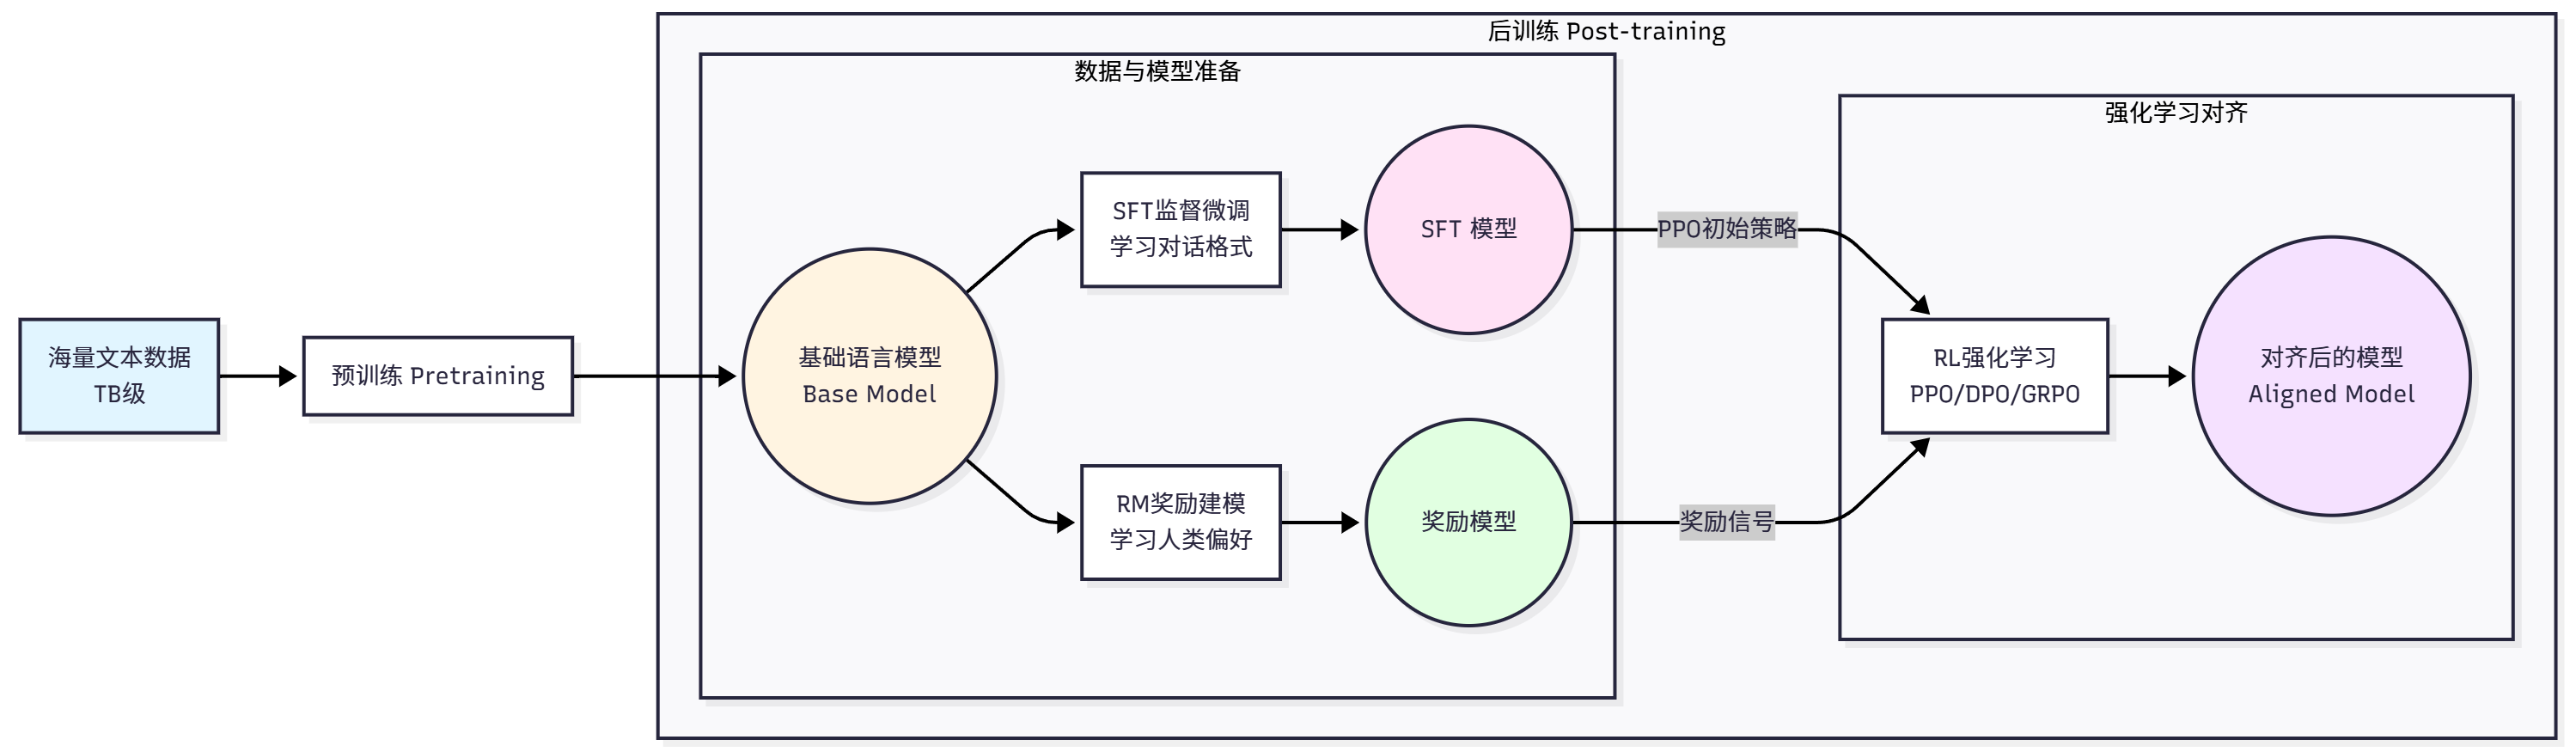
预训练阶段是 LLM 训练的第一阶段,目标是让模型学习语言的基本规律和世界知识。这个阶段使用海量的文本数据(通常是数 TB 级别),通过自监督学习的方式训练模型:训练信号来自文本本身,例如根据上文预测下一个词。最常见的预训练任务是因果语言建模(Causal Language Modeling),也称为下一个词预测(Next Token Prediction)。
给定一个文本序列 $x_1, x_2, \ldots, x_t$,模型需要预测下一个词 $x_{t+1}$:
\[\mathcal{L}_{\text{pretrain}} = -\sum_{t=1}^{T} \log P(x_t \mid x_1, x_2, \ldots, x_{t-1}; \theta)\]其中 $\theta$ 是模型参数,$P(x_t \mid x_1, \ldots, x_{t-1}; \theta)$ 是模型预测的下一个词的概率分布,目标是最小化负对数似然,即最大化预测正确词的概率。例如,给定文本”The cat sat on the”,模型需要预测下一个词最可能是”mat”。通过在海量文本上进行这样的训练,模型逐渐学会语法规则(什么样的词序是合法的)、语义知识(词与词之间的关系)、世界知识(关于世界的事实性信息)以及基础的推理能力。
预训练阶段的特点是数据量巨大、计算成本高,学到的是通用的语言理解和生成能力,训练过程通常采用从未标注文本中自动构造监督信号的自监督目标。
后训练阶段则是要解决预训练模型的不足。预训练后的模型虽然具备了强大的语言能力,但它只是一个”预测下一个词”的模型,并不知道如何遵循人类的指令、生成有帮助无害诚实的回答、拒绝不当的请求,以及以对话的方式与人交互。后训练阶段就是要解决这些问题,让模型对齐人类的偏好和价值观。
后训练通常包含三个步骤。第一步是监督微调(SFT),目标是让模型学会遵循指令和对话格式。训练数据是(prompt, completion)对,训练目标与预训练类似,仍然是最大化正确输出的概率:
\[\mathcal{L}_{\text{SFT}} = -\sum_{i=1}^{N} \log P(y_i \mid x_i; \theta)\]其中 $x_i$ 是输入提示(prompt),$y_i$ 是期望的输出,$N$ 是训练样本数量。SFT 的特点是数据量较小、需要人工标注、快速见效、主要学习任务格式和基本能力。
第二步是奖励建模(RM)。SFT 后的模型虽然能遵循指令,但生成的回答质量参差不齐。我们需要一种方式来评估回答的质量,这就是奖励模型的作用。奖励模型的训练数据是偏好对比数据,包含同一个问题的两个回答,一个更好(chosen),一个更差(rejected)。奖励模型的训练目标是学习人类的偏好:
\[\mathcal{L}_{\text{RM}} = -\mathbb{E}_{(x, y_w, y_l)} \left[ \log \sigma\bigl(r_\phi(x, y_w) - r_\phi(x, y_l)\bigr) \right]\]其中 $r_\phi(x, y)$ 是奖励模型,输入是(提示,回答)对,输出是质量分数;$y_w$ 是更好的回答(chosen),$y_l$ 是更差的回答(rejected),$\sigma$ 是 sigmoid 函数,目标是让奖励模型给更好的回答更高的分数。
第三步是强化学习微调。有了奖励模型后,我们就可以用强化学习来优化语言模型,让它生成更高质量的回答。最经典的算法是 PPO(Proximal Policy Optimization),训练目标是:
\[J_{\text{PPO}} = \mathbb{E}_{x, y \sim \pi_\theta} \bigl[ r_\phi(x, y) \bigr] - \beta \cdot D_{\text{KL}}\bigl(\pi_\theta \,\|\, \pi_{\text{ref}}\bigr)\]其中 $\pi_\theta$ 是当前策略,即语言模型,$\pi_{\text{ref}}$ 是参考策略,这个场景下可以是 SFT 模型,$r_\phi(x, y)$ 是奖励模型的评分,$D_{\text{KL}}$ 是 KL 散度,目的是为了防止模型偏离太远,$\beta$ 是平衡系数。这个目标函数的含义是:最大化奖励,同时不要偏离原始模型太远。
传统的 RLHF(Reinforcement Learning from Human Feedback)需要大量人工标注偏好数据,成本高昂。为了降低成本,研究者提出了 RLAIF(Reinforcement Learning from AI Feedback),用强大的 AI 模型(如 GPT-4)来替代人类标注员。RLAIF 的工作流程是:用 SFT 模型生成多个候选回答,用强大的 AI 模型对回答进行评分和排序,用 AI 的评分训练奖励模型,用奖励模型进行强化学习。实验表明,RLAIF 的效果接近甚至超过 RLHF,同时成本大幅降低。
Agentic RL的核心理念
在理解了 LLM 的基础训练流程后,让我们来看看 Agentic RL 与传统训练方法的区别。传统的后训练(我们称之为 PBRFT: Preference-Based Reinforcement Fine-Tuning)主要关注单轮对话的质量优化:给定一个用户问题,模型生成一个回答,然后根据回答的质量获得奖励。这种方式适合优化对话助手,但对于需要多步推理、工具使用、长期规划的智能体任务来说,就显得力不从心了。
Agentic RL则是一种新的范式,它将 LLM 视为一个可学习的策略,嵌入在一个顺序决策循环中。在这个框架下,智能体需要在动态环境中与外部世界交互,执行多步行动来完成复杂任务,获得中间反馈来指导后续决策,优化长期累积奖励而非单步奖励。
让我们通过一个具体例子来理解这个区别。在 PBRFT 场景中,用户问”请解释什么是强化学习”,模型生成完整回答,然后根据回答质量直接给分。而在 Agentic RL 场景中,用户请求”帮我分析这个 GitHub 仓库的代码质量”,智能体需要经历多个步骤:首先调用 GitHub API 获取仓库信息,成功获得仓库结构和文件列表,得到+0.1 的奖励;然后读取主要代码文件,成功获得代码内容,得到+0.1 的奖励;接着分析代码质量合理,得到+0.2 的奖励;最后生成分析报告质量高,得到+0.6 的奖励。总奖励是所有步骤的累积:1.0。
可以看到,Agentic RL 的关键特征是多步交互、每一步的行动都会改变环境状态、每一步都可以获得反馈、优化整个任务的完成质量。
强化学习常用马尔可夫决策过程(Markov Decision Process,MDP)框架进行形式化。MDP 由五元组 $(\mathcal{S}, \mathcal{A}, P, R, \gamma)$ 定义:状态空间 $\mathcal{S}$、行动空间 $\mathcal{A}$、状态转移函数 $P(s’ \mid s, a)$、奖励函数 $R(s, a)$ 和折扣因子 $\gamma$。下表从 MDP 角度对比 PBRFT 和 Agentic RL。
| 维度 | PBRFT | Agentic RL |
|---|---|---|
| 状态 | 单一提示 $s_0$ | 动态演化 $s_t$ |
| 行动 | 文本生成 | 文本 + 工具 + 环境操作 |
| 转移 | 无转移 | 状态随行动变化 |
| 奖励 | 单步 $r(s_0, y)$ | 累积 $\sum_t \gamma^t r(s_t, a_t)$ |
| 时间 | $T = 1$ | $T \gg 1$ |
| 目标 | 短期质量 | 长期成功 |
在状态方面,PBRFT 的状态 $s_0$ 仅由用户提示构成,时间跨度 $T = 1$(单步),状态不变化,可以表示为 $s_0 = \text{prompt}$。而 Agentic RL 的状态 $s_t$ 包含历史观察和上下文,时间跨度 $T \gg 1$(多步),状态随行动演化,可以表示为 $s_t = (\text{prompt}, o_1, o_2, \ldots, o_t)$,其中 $o_t$ 是第 $t$ 步的观察(如工具返回结果、环境反馈等)。
在行动方面,PBRFT 的行动空间只有文本生成,单一行动类型,表示为 $a = y \sim \pi_\theta(y \mid s_0)$。而 Agentic RL 的行动空间包含文本生成、工具调用、环境操作等多种类型,表示为 $a_t \in {a_t^{\text{text}}, a_t^{\text{tool}}}$,例如 $a_t^{\text{text}}$ 是生成思考过程或回答,$a_t^{\text{tool}}$ 是调用计算器、搜索引擎等工具。
在转移函数方面,PBRFT 无状态转移,表示为 $P(s’ \mid s, a) = \delta(s’ - s_{\text{terminal}})$。而 Agentic RL 的状态根据行动和环境动态变化,表示为 $s_{t+1} \sim P(s_{t+1} \mid s_t, a_t)$,例如调用搜索工具后,状态会包含搜索结果。
在奖励方面,PBRFT 只有单步奖励 $r(s_0, a)$,仅在任务结束时给予,表示为 $R_{\text{PBRFT}} = r(s_0, y)$,通常由奖励模型给出:$r(s_0, y) = r_\phi(s_0, y)$。而 Agentic RL 有多步奖励 $r(s_t, a_t)$,可以在中间步骤给予部分奖励,表示为:
\[R_{\text{Agentic}} = \sum_{t=0}^{T} \gamma^t r(s_t, a_t)\]其中 $\gamma \in [0, 1]$ 是折扣因子,$r(s_t, a_t)$ 可以是稀疏奖励(只在任务完成时给予,如答案正确 +1)、密集奖励(每步都给予,如工具调用成功 +0.1)或结合两者的混合奖励。
在目标函数方面,PBRFT 最大化单步期望奖励:
\[J_{\text{PBRFT}}(\theta) = \mathbb{E}_{s_0,\, y \sim \pi_\theta} \bigl[ r(s_0, y) \bigr]\]而 Agentic RL 最大化累积折扣奖励:
\[J_{\text{Agentic}}(\theta) = \mathbb{E}_{\tau \sim \pi_\theta} \left[ \sum_{t=0}^{T} \gamma^t r(s_t, a_t) \right]\]其中 $\tau = (s_0, a_0, s_1, a_1, \ldots, s_T)$ 是完整的轨迹(trajectory)。
这种转变不仅仅是技术细节的差异,而是思维方式的根本转变。PBRFT 思维关注”如何让模型生成更好的单个回答”,优化回答质量,关注语言表达,进行单步决策。而 Agentic RL 思维关注”如何让智能体完成复杂任务”,优化任务完成度,关注行动策略,进行多步规划。这种转变使得 LLM 从”对话助手”进化为”自主智能体”,能够主动寻找信息、知道何时、如何使用外部工具、为了最终目标,愿意执行看似”绕路”的中间步骤、从错误学习。
Agentic RL 的目标是赋予 LLM 智能体六大核心能力,如图所示。
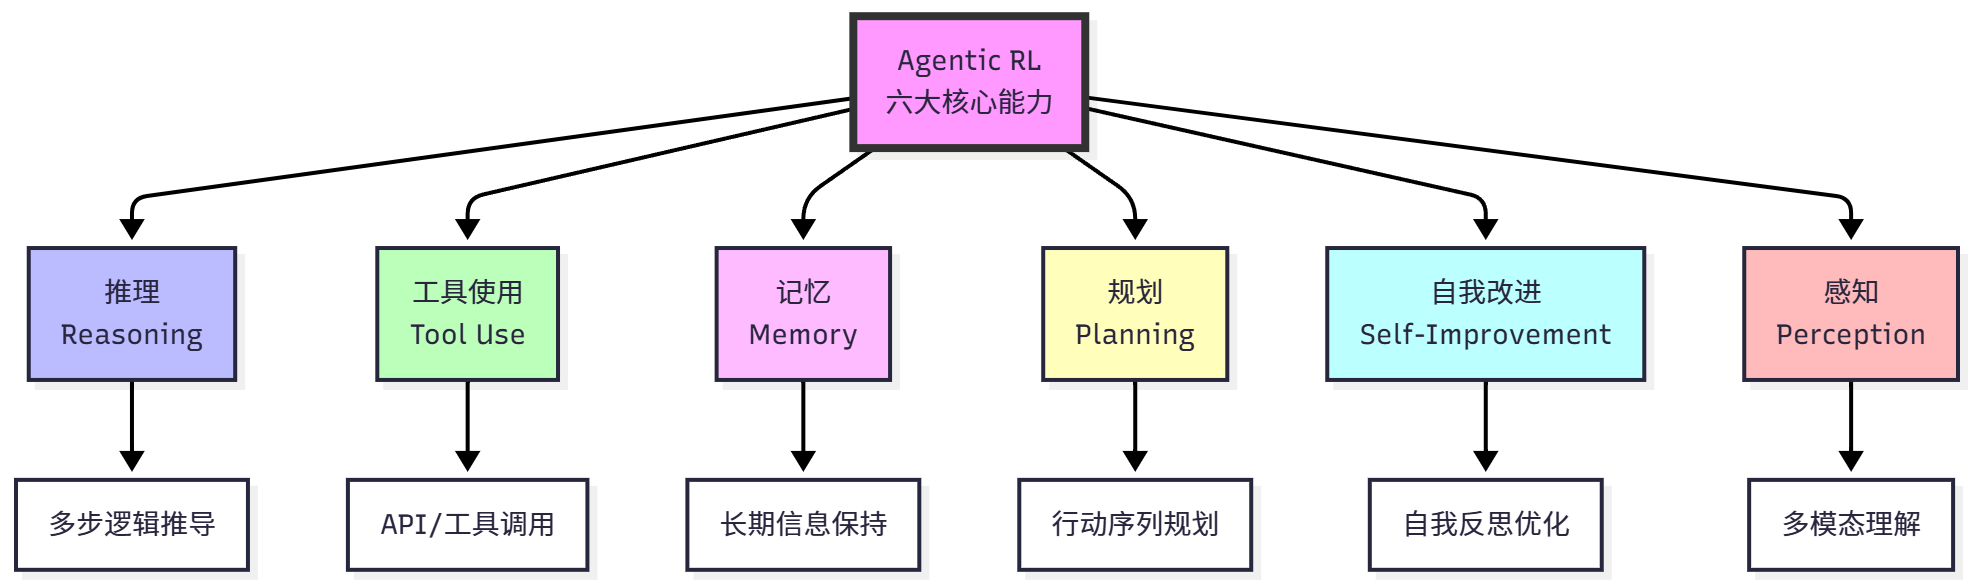
推理(Reasoning) 是指从给定信息中逻辑地得出结论的过程,是智能体的核心能力。传统的 CoT 提示方法依赖少样本示例,泛化能力有限;SFT 只能模仿训练数据中的推理模式,难以创新。强化学习的优势在于通过试错学习有效的推理策略,发现训练数据中没有的推理路径,学会何时需要深度思考、何时可以快速回答。推理任务可以建模为序列决策问题,给定问题 $q$,智能体需要生成推理链 $c = (c_1, c_2, \ldots, c_n)$ 和最终答案 $a$。奖励函数通常设计为 $r(q, c, a) = \mathbb{1}[a = a^*]$,训练目标是 $\max_\theta \mathbb{E}{q,\, (c, a) \sim \pi\theta} \bigl[ r(q, c, a) \bigr]$。通过这种方式,模型学会生成高质量的推理链,而不仅仅是记忆答案。
工具使用(Tool Use) 是指智能体调用外部工具来完成任务的能力。在工具使用任务中,行动空间扩展为 $a_t \in {a_t^{\text{think}}, a_t^{\text{tool}}}$,其中 $a_t^{\text{think}}$ 是生成思考过程,$a_t^{\text{tool}} = (\text{tool_name}, \text{arguments})$ 是调用工具。强化学习让智能体学会何时需要使用工具、选择哪个工具、如何组合多个工具。例如,在解决数学问题时,智能体需要学会何时使用计算器、何时使用代码解释器、何时直接推理。
记忆(Memory)是指智能体保持和重用过去信息的能力,对于长期任务至关重要。LLM 的上下文窗口有限,静态检索策略(如 RAG)无法针对任务优化。强化学习让智能体学会记忆管理策略:决定哪些信息值得记住、何时更新记忆、何时删除过时信息。这类似于人类的工作记忆,我们会主动管理大脑中的信息,保留重要的、遗忘无关的。
规划(Planning)是指制定行动序列以达成目标的能力。传统的 CoT 是线性思考,无法回溯;提示工程使用静态规划模板,难以适应新情况。强化学习让智能体学会动态规划:通过试错发现有效的行动序列,学会权衡短期和长期收益。例如,在多步任务中,智能体可能需要先执行一些看似”绕路”的步骤,例如收集信息,才能最终完成任务。
自我改进(Self-Improvement)是指智能体回顾自身输出、纠正错误并优化策略的能力。强化学习让智能体学会自我反思:识别自己的错误、分析失败原因、调整策略。这种能力使得智能体能够在没有人工干预的情况下持续改进,类似于人类的”从错误中学习”。
感知(Perception)是指理解多模态信息的能力。例如,强化学习可以提升视觉推理能力,让模型学会使用视觉工具,学会视觉规划。这使得智能体不仅能理解文本,还能理解和操作视觉世界。
SFT训练
监督微调(Supervised Fine-Tuning, SFT)是强化学习训练的第一步,也是最重要的基础。SFT 让模型学习任务的基本格式、对话模式和初步的推理能力。没有 SFT 的基础,直接进行强化学习往往会失败,因为模型连基本的输出格式都不会。
Why SFT
在开始强化学习之前,我们需要先进行 SFT 训练。这是因为预训练模型虽然具备强大的语言能力,但它并不知道如何完成特定任务。预训练模型的训练目标是预测下一个词,而不是解决数学问题或使用工具。预训练模型的输出格式是自由文本,而我们需要结构化的输出(如”Step 1: …, Step 2: …, Final Answer: …”)。预训练模型没有见过任务相关的数据,不知道什么是”好的”推理过程。
SFT 的作用是教会模型任务的基本规则。首先,学习输出格式,让模型知道如何组织答案(如使用”Step 1”, “Final Answer”等标记)。其次,学习推理模式,通过示例学习如何分解问题、逐步推导。再次,建立基线能力,为后续的强化学习提供一个合理的起点。最后,减少探索空间,强化学习不需要从零开始,可以在 SFT 的基础上优化。
让我们通过一个对比实验来理解 SFT 的重要性。假设我们直接用预训练模型解决 GSM8K 问题:
`
from transformers import AutoTokenizer, AutoModelForCausalLM
# 加载预训练模型
model_name = "Qwen/Qwen3-0.6B"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)
# 测试问题
question = """Natalia sold clips to 48 of her friends in April, and then she sold half as many clips in May. How many clips did Natalia sell altogether in April and May?"""
# 构造输入
prompt = f"<|im_start|>user\n{question}<|im_end|>\n<|im_start|>assistant\n"
inputs = tokenizer(prompt, return_tensors="pt")
# 生成回答
outputs = model.generate(**inputs, max_new_tokens=200)
response = tokenizer.decode(outputs[0], skip_special_tokens=False)
print("预训练模型的回答:")
print(response)`
预训练模型的输出可能是:
`<|im_start|>user
Natalia sold clips to 48 of her friends in April, and then she sold half as many clips in May. How many clips did Natalia sell altogether in April and May?<|im_end|>
<|im_start|>assistant
I can help you with that. Let me think about this problem. Natalia sold clips to her friends. In April she sold 48 clips. In May she sold half as many. So we need to find out how many she sold in May and then add them together. But I'm not sure how to calculate half of 48. Maybe I should use a calculator? Or maybe I can just estimate...`
可以看到,预训练模型虽然理解了问题,但输出非常冗长、缺乏结构、没有明确的答案、推理过程混乱。这样的输出无法用于强化学习,因为我们无法提取答案、无法评估质量、无法提供有效的奖励信号。
现在让我们看看 SFT 后的模型:
`# 加载SFT模型(假设已经训练好)
sft_model_path = "./models/sft_model"
sft_model = AutoModelForCausalLM.from_pretrained(sft_model_path)
# 使用相同的问题
outputs = sft_model.generate(**inputs, max_new_tokens=200)
response = tokenizer.decode(outputs[0], skip_special_tokens=False)
print("SFT模型的回答:")
print(response)`
SFT模型的输出:
`<|im_start|>user
Natalia sold clips to 48 of her friends in April, and then she sold half as many clips in May. How many clips did Natalia sell altogether in April and May?<|im_end|>
<|im_start|>assistant
Let me solve this step by step.
Step 1: Calculate clips sold in May
Natalia sold half as many clips in May as in April.
Clips in May = 48 / 2 = 24
Step 2: Calculate total clips
Total = April + May = 48 + 24 = 72
Final Answer: 72<|im_end|>`
可以看到,SFT 模型的输出结构清晰(使用”Step 1”, “Step 2”, “Final Answer”标记)、推理正确、答案明确、格式统一。这样的输出可以用于强化学习,因为我们可以提取答案、计算奖励、优化策略。
如图 11.6 所示,SFT 是从预训练模型到强化学习的桥梁。
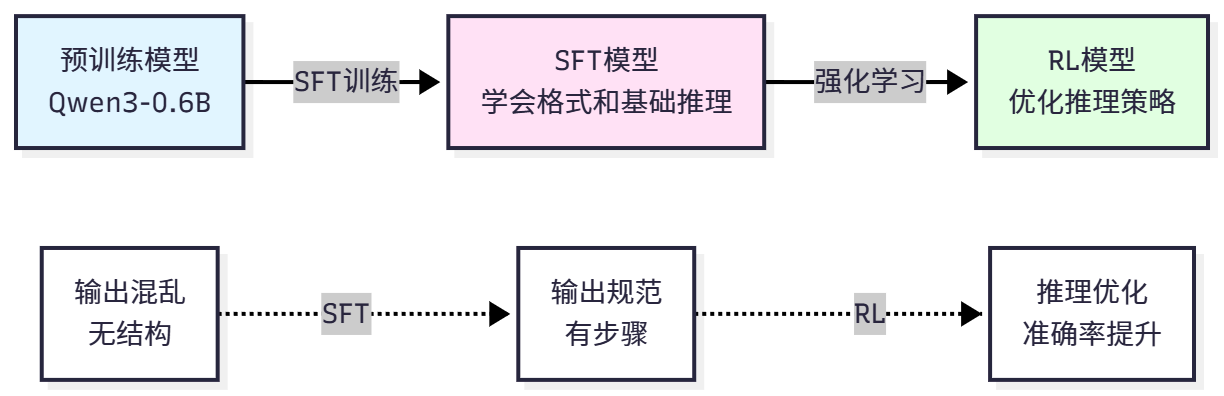
LoRA:参数高效微调
直接微调整个模型需要大量的计算资源和显存。对于 Qwen3-0.6B(0.6B 参数),全量微调需要约 12GB 显存(FP16)或 24GB 显存(FP32)。对于更大的模型(如 7B、13B),全量微调几乎不可能在消费级 GPU 上进行。
LoRA(Low-Rank Adaptation)[3]是一种参数高效微调方法,它只训练少量的额外参数,而保持原模型参数冻结。LoRA 的核心思想是:模型微调时的参数变化可以用低秩矩阵表示。
假设原模型的权重矩阵为 $W \in \mathbb{R}^{d \times k}$,微调后的权重为 $W’ = W + \Delta W$。LoRA 假设 $\Delta W$ 可以分解为两个低秩矩阵的乘积:
\[\Delta W = BA\]其中 $B \in \mathbb{R}^{d \times r}$,$A \in \mathbb{R}^{r \times k}$,$r \ll \min(d, k)$ 是秩(rank)。
前向传播时,输出为:
\[h = Wx + \Delta W x = Wx + BAx\]原模型参数 $W$ 保持冻结,只训练 $B$ 和 $A$。
参数量对比:原模型参数量为 $d \times k$,LoRA 参数量为 $d \times r + r \times k = r(d + k)$。当 $r \ll \min(d, k)$ 时,LoRA 参数量远小于原模型。例如,对于 $d = 4096$、$k = 4096$、$r = 8$ 的情况,原模型参数量为 $4096 \times 4096 = 16{,}777{,}216$,LoRA 参数量为 $8 \times (4096 + 4096) = 65{,}536$,参数量减少了 256 倍!
因此可以总结 LoRA 的优势:显存占用大幅降低、训练速度更快、易于部署、防止过拟合。不过训练的效果通常情况会比全量调参更差一些。
如表所示,LoRA 在不同模型规模下的效果对比。
| 模型 | 全量参数 | LoRA 参数 (r=8) | 显存(全量) | 显存(LoRA) |
|---|---|---|---|---|
| Qwen3-0.6B | 0.6B | 2.4M | 12GB | 4GB |
| Qwen3-1.5B | 1.5B | 6.0M | 24GB | 8GB |
| Qwen3-7B | 7B | 28M | 112GB | 28GB |
LoRA 的关键超参数包括:秩(rank, $r$),控制 LoRA 矩阵的秩,越大表达能力越强,但参数量也越多,典型值为 4–64,默认 8;Alpha ($\alpha$),LoRA 的缩放因子,实际更新为 $\Delta W = \frac{\alpha}{r} BA$,控制 LoRA 的影响强度,典型值等于 rank;目标模块(target_modules),指定哪些层应用 LoRA,通常选择注意力层 (q_proj, k_proj, v_proj, o_proj),也可以包括 MLP 层 (gate_proj, up_proj, down_proj)。
SFT训练实战
现在让我们使用 HelloAgents 进行 SFT 训练。完整的训练流程包括:准备数据集、配置 LoRA、设置训练参数、开始训练、保存模型。
基础训练示例:
`
from hello_agents.tools import RLTrainingTool
# 创建训练工具
rl_tool = RLTrainingTool()
# SFT训练
result = rl_tool.run({
    # 训练配置
    "action": "train",
    "algorithm": "sft",
    # 模型配置
    "model_name": "Qwen/Qwen3-0.6B",
    "output_dir": "./models/sft_model",
    # 数据配置
    "max_samples": 100,
     # 使用100个样本快速测试
    # 训练参数
    "num_epochs": 3,
        # 训练3轮
    "batch_size": 4,
        # 批次大小
    "learning_rate": 5e-5,  # 学习率
    # LoRA配置
    "use_lora": True,
       # 使用LoRA
    "lora_rank": 8,
         # LoRA秩
    "lora_alpha": 16,
       # LoRA alpha
})
print(f"\n✓ 训练完成!")
print(f"  - 模型保存路径: {result['model_path']}")
print(f"  - 训练样本数: {result['num_samples']}")
print(f"  - 训练轮数: {result['num_epochs']}")
print(f"  - 最终损失: {result['final_loss']:.4f}")`
如果训练过程中损失逐渐下降,说明模型正在学习。
(1)训练参数详解
让我们详细了解各个训练参数的含义和调优建议。
数据参数:
- max_samples: 使用的训练样本数量。快速测试时可以用 100-1000 个样本,完整训练建议使用全部数据(7473 个样本)。更多数据通常带来更好的效果,但训练时间也更长。
- split: 数据集划分,默认”train”。可以设置为”train[:1000]”只使用前 1000 个样本。
训练参数:
- num_epochs: 训练轮数。1 轮表示遍历整个数据集一次。太少(1-2 轮)可能欠拟合,太多(>10 轮)可能过拟合。建议从 3 轮开始,观察损失曲线调整。
- batch_size: 每次更新使用的样本数。越大训练越稳定,但显存占用越高。建议根据显存调整:4GB 显存用 batch_size=1-2,8GB 显存用 batch_size=4-8,16GB 显存用 batch_size=8-16。
- learning_rate: 学习率,控制参数更新的步长。太小(1e-6)收敛慢,太大(1e-3)可能不收敛。SFT 推荐 5e-5,LoRA 可以稍大(1e-4)。
LoRA 参数:
- use_lora: 是否使用 LoRA。建议始终开启,除非有充足的显存。
- lora_rank: LoRA 秩,控制表达能力。4-8 适合小任务,16-32 适合复杂任务,64 适合大规模微调。
- lora_alpha: LoRA 缩放因子,通常设置为 rank 的 2 倍。rank=8 时,alpha=16;rank=16 时,alpha=32。
优化器参数:
- optimizer: 优化器类型,默认”adamw”。AdamW 是最常用的选择,也可以尝试”sgd”或”adafactor”等。
- weight_decay: 权重衰减,防止过拟合。默认 0.01,可以尝试 0.001-0.1。
- warmup_ratio: 学习率预热比例。前 warmup_ratio 的步数学习率线性增加,然后线性衰减。默认 0.1(前 10%步数预热)。
(2)完整训练示例
让我们进行一次完整的 SFT 训练,使用全部数据和最佳实践:
`
from hello_agents.tools import RLTrainingTool
rl_tool = RLTrainingTool()
# 完整SFT训练
result = rl_tool.run({
    "action": "train",
    "algorithm": "sft",
    # 模型配置
    "model_name": "Qwen/Qwen3-0.6B",
    "output_dir": "./models/sft_full",
    # 数据配置
    "max_samples": None,
    # 使用全部数据(7473个样本)
    # 训练参数
    "num_epochs": 3,
    "batch_size": 8,
    "learning_rate": 5e-5,
    "warmup_ratio": 0.1,
    "weight_decay": 0.01,
    # LoRA配置
    "use_lora": True,
    "lora_rank": 16,
        # 使用更大的rank
    "lora_alpha": 32,
    "lora_target_modules": ["q_proj", "k_proj", "v_proj", "o_proj"],
    # 其他配置
    "save_steps": 500,
      # 每500步保存一次
    "logging_steps": 100,   # 每100步记录一次
    "eval_steps": 500,
      # 每500步评估一次
})
print(f"训练完成! 模型保存在: {result['model_path']}")`
这个配置适合在 8GB 显存的 GPU 上训练,预计耗时 30-60 分钟。
(3)训练监控和调试
在训练过程中,我们需要监控三个关键指标。损失(Loss)应该逐渐下降,如果不下降可能是学习率太小或数据有问题,如果下降后又上升则可能是学习率太大或出现过拟合。梯度范数(Gradient Norm)应该在 0.1-10 的合理范围内,过大(>100)说明出现梯度爆炸需要降低学习率,过小(<0.01)说明梯度消失需要检查模型配置。学习率(Learning Rate)应该按照 warmup 策略变化,前 10%步数线性增加,然后线性衰减到 0。
训练中常见的问题及解决方案:显存不足时可以减小 batch_size 或 max_length,使用梯度累积或更小的模型;训练速度慢时可以增大 batch_size,减少 logging 频率,或使用混合精度训练;损失不下降时可以增大学习率,检查数据格式,或增加训练轮数;过拟合时可以增大 weight_decay,减少训练轮数,或使用更多数据。
模型评估
训练完成后,我们需要评估模型的效果。评估指标包括:
- 准确率(Accuracy):答案完全正确的比例,最直接的指标,范围 0-1,越高越好。
- 平均奖励(Average Reward):所有样本的平均奖励,综合考虑准确率、长度、步骤等因素,范围取决于奖励函数设计。
- 推理质量(Reasoning Quality):推理过程的清晰度和逻辑性,需要人工评估或使用专门的评估模型。
GPRO训练
在完成 SFT 训练后,我们已经得到了一个能够生成结构化答案的模型。但是,SFT 模型只是学会了”模仿”训练数据中的推理过程,并没有真正学会”思考”。强化学习可以让模型通过试错来优化推理策略,从而超越训练数据的质量。
从PPO到GPRO
在强化学习领域,PPO(Proximal Policy Optimization)[1]是最经典的算法之一。PPO 通过限制策略更新的幅度,保证训练的稳定性。但是,PPO 在 LLM 训练中存在一些问题:需要训练 Value Model(价值模型),增加了训练复杂度和显存占用;需要同时维护四个模型(Policy Model、Reference Model、Value Model、Reward Model),工程实现复杂;训练不稳定,容易出现奖励崩塌或策略退化。
GRPO(Group Relative Policy Optimization)[2]是一种简化的 PPO 变体,专门为 LLM 设计。GRPO 的核心思想是:不需要 Value Model,使用组内相对奖励代替绝对奖励;简化训练流程,只需要 Policy Model 和 Reference Model;提高训练稳定性,减少奖励崩塌的风险。
让我们通过数学公式来理解 GRPO 的原理。PPO 的目标函数为:
\[J_{\text{PPO}}(\theta) = \mathbb{E}_{s, a \sim \pi_\theta} \left[ \min\!\left( \frac{\pi_\theta(a \mid s)}{\pi_{\text{old}}(a \mid s)} A(s, a),\ \text{clip}\!\left( \frac{\pi_\theta(a \mid s)}{\pi_{\text{old}}(a \mid s)}, 1 - \epsilon, 1 + \epsilon \right) A(s, a) \right) \right]\]其中 $A(s, a)$ 是优势函数(Advantage),需要 Value Model 来估计:
\[A(s, a) = Q(s, a) - V(s) = r(s, a) + \gamma V(s') - V(s)\]GRPO 的目标函数简化为:
\[J_{\text{GRPO}}(\theta) = \mathbb{E}_{s, a \sim \pi_\theta} \left[ \frac{\pi_\theta(a \mid s)}{\pi_{\text{ref}}(a \mid s)} \cdot \bigl( r(s, a) - \bar{r}_{\text{group}} \bigr) \right] - \beta \cdot D_{\text{KL}}\bigl( \pi_\theta \,\|\, \pi_{\text{ref}} \bigr)\]其中 $\bar{r}{\text{group}}$ 是组内平均奖励,$\beta$ 是 KL 散度惩罚系数。关键区别在于:GRPO 使用 $r(s, a) - \bar{r}{\text{group}}$ 代替优势函数 $A(s, a)$,不需要 Value Model;GRPO 使用组内相对奖励,减少奖励方差;GRPO 添加 KL 散度惩罚,防止策略偏离太远。
如图所示,PPO 和 GRPO 的训练流程对比。
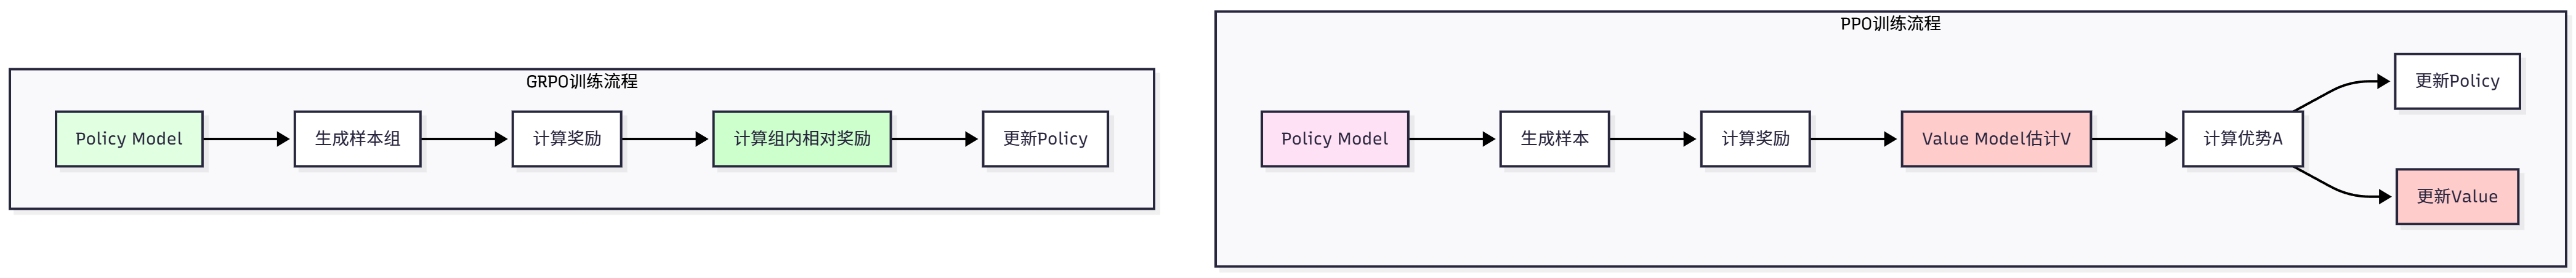
可以看到,GRPO 省去了 Value Model 的训练,大大简化了流程。
如表所示,PPO 和 GRPO 的详细对比。
| 维度 | PPO | GRPO |
|---|---|---|
| 模型数量 | 4 个(Policy, Ref, Value, Reward) | 2 个(Policy, Ref) |
| 优势估计 | Value Model | 组内相对奖励 |
| 显存占用 | 高(需要 Value Model) | 低(无 Value Model) |
| 训练稳定性 | 中等 | 较高 |
| 实现复杂度 | 高 | 低 |
| 适用场景 | 通用 RL | LLM 微调 |
对于 LLM 训练,GRPO 是更好的选择,因为它更简单、更稳定、显存占用更低。
模型评估和分析
训练完成后,我们需要全面评估模型的性能,不仅要看准确率这一个指标,还要深入分析模型的推理质量、错误模式、泛化能力等。本节将介绍如何系统地评估和分析 Agentic RL 模型。
评估指标体系
一个好的评估体系应该是多维度的,从不同角度衡量模型的能力。我们将评估指标分为三类:准确性指标、效率指标、质量指标。
(1)准确性指标
准确性指标衡量模型是否能够得出正确答案。
准确率(Accuracy):最基本的指标,答案完全正确的比例。计算公式为:
\[\text{Accuracy} = \frac{\text{正确答案数}}{\text{总问题数}}\]优点是简单直观,易于理解和比较。缺点是无法区分”接近正确”和”完全错误”,对于复杂任务可能过于粗糙。
Top-K 准确率:生成 K 个答案,只要有一个正确就算对。计算公式为:
\[\text{Accuracy@K} = \frac{\text{至少有一个正确答案的问题数}}{\text{总问题数}}\]这个指标反映了模型的”潜力”,即通过多次采样能否找到正确答案。
数值误差(Numerical Error):对于数学问题,可以计算预测值与真实值的误差。计算公式为:
\[\text{Error} = \frac{1}{N} \sum_{i=1}^{N} \lvert y_i - \hat{y}_i \rvert\]这个指标可以区分”接近正确”(如预测 72.5,真实 72)和”完全错误”(如预测 100,真实 72)。
(2)效率指标
效率指标衡量模型生成答案的成本。
平均长度(Average Length):生成答案的平均 token 数。计算公式为:
\[\text{Avg Length} = \frac{1}{N} \sum_{i=1}^{N} \lvert y_i \rvert\]更短的答案意味着更低的推理成本和更快的响应速度。
推理步骤数(Reasoning Steps):答案中包含的推理步骤数量。计算公式为:
\[\text{Avg Steps} = \frac{1}{N} \sum_{i=1}^{N} s_i\]适当的步骤数(2-5 步)说明模型能够系统地分解问题,过多的步骤可能说明推理冗余。
推理时间(Inference Time):生成一个答案所需的时间。这个指标在实际部署中很重要,影响用户体验。
(3)质量指标
质量指标衡量答案的可读性和可解释性。
格式正确率(Format Correctness):答案是否符合预期格式(如包含 “Step 1”、”Final Answer” 等标记)。计算公式为:
\[\text{Format Correctness} = \frac{\text{格式正确的答案数}}{\text{总答案数}}\]格式正确是基本要求,格式混乱的答案即使结果正确也难以使用。
推理连贯性(Reasoning Coherence):推理步骤之间是否逻辑连贯。这个指标通常需要人工评估或使用专门的评估模型。
可解释性(Explainability):答案是否容易理解和验证。包含清晰步骤的答案比直接给出结果的答案更具可解释性。
如表所示,不同指标的对比。
| 类别 | 指标 | 优点 | 缺点 |
|---|---|---|---|
| 准确性 | Accuracy | 简单直观 | 过于粗糙 |
| 准确性 | Accuracy@K | 反映潜力 | 需要多次采样 |
| 准确性 | Numerical Error | 细粒度 | 仅适用数值任务 |
| 效率 | Avg Length | 反映成本 | 不考虑质量 |
| 效率 | Avg Steps | 反映推理风格 | 难以量化 |
| 质量 | Format Correctness | 易于检测 | 不保证正确性 |
| 质量 | Coherence | 全面评估 | 需要人工 |
本章小结
(1)Agentic RL 的本质
Agentic RL 是将 LLM 作为可学习策略,嵌入到智能体的感知-决策-执行循环中,通过强化学习优化智能体在多步任务中的表现。它与传统的 PBRFT(Preference-Based Reinforcement Fine-Tuning)的核心区别在于:
- 任务性质:从单轮对话优化扩展到多步序贯决策
- 状态空间:从静态提示扩展到动态演化的环境状态
- 行动空间:从纯文本生成扩展到文本+工具+环境操作
- 奖励设计:从单步质量评估扩展到长期累积回报
- 优化目标:从短期响应质量扩展到长期任务成功
(2)六大核心能力
Agentic RL 旨在提升智能体的六大核心能力:
- 推理(Reasoning):多步逻辑推导,学习推理策略
- 工具使用(Tool Use):API/工具调用,学会何时用、如何用
- 记忆(Memory):长期信息保持,学习记忆管理
- 规划(Planning):行动序列规划,学会动态规划
- 自我改进(Self-Improvement):自我反思优化,从错误中学习
- 感知(Perception):多模态理解,视觉推理和工具使用
(3)训练流程
完整的 Agentic RL 训练流程包括:
- 预训练(Pretraining):在大规模文本上学习语言知识(通常使用现成的预训练模型)
- 监督微调(SFT):学习任务格式和基础推理能力
- 强化学习(RL):通过试错优化推理策略,超越训练数据质量
其中,SFT 是基础,RL 是提升。没有 SFT 的基础,RL 很难成功;没有 RL 的优化,模型只能模仿训练数据。
如果你想深入学习 Agentic RL,建议按照以下路径:
基础阶段
- 强化学习基础:学习 MDP、策略梯度、PPO 等基本概念
- LLM 基础:了解 Transformer、预训练、微调等技术
- 实践 HelloAgents:运行本章的示例代码,理解完整流程
进阶阶段
- 深入 TRL:学习 TRL 库的实现,理解 SFT 和 GRPO 等算法的细节
- 自定义数据集:使用自己的数据集训练模型
- 自定义奖励函数:设计适合自己任务的奖励函数
- 参数调优:系统地调优超参数,提升模型性能
高级阶段
- 多步推理:研究长序列推理任务
- 工具学习:让智能体学会使用工具
- 多智能体:研究多智能体协作
- 前沿论文:阅读最新的研究论文,跟进前沿进展
智能体性能评估
智能体评估领域已经涌现出多个具有影响力的基准测试。下面介绍一些主流的评估基准和指标:
(1)工具调用能力评估
工具调用是智能体的核心能力之一。智能体需要理解用户意图,选择合适的工具,并正确构造函数调用。相关的评估基准包括:
- BFCL (Berkeley Function Calling Leaderboard):UC Berkeley 推出,包含 1120+测试样本,涵盖 simple、multiple、parallel、irrelevance 四个类别,使用 AST 匹配算法评估,数据集规模适中,社区活跃。
- ToolBench:清华大学推出,包含 16000+真实 API 调用场景,覆盖真实世界的复杂工具使用场景。
- API-Bank:Microsoft Research 推出,包含 53 个常用 API 工具,专注于评估智能体对 API 文档的理解和调用能力。
(2)通用能力评估
评估智能体在真实世界任务中的综合表现,包括多步推理、知识运用、多模态理解等能力:
- GAIA (General AI Assistants):Meta AI 和 Hugging Face 联合推出,包含 466 个真实世界问题,分为 Level 1/2/3 三个难度级别,评估多步推理、工具使用、文件处理、网页浏览等能力,使用准精确匹配(Quasi Exact Match)算法,任务真实且综合性强。
- AgentBench:清华大学推出,包含 8 个不同领域的任务,全面评估智能体的通用能力。
- WebArena:CMU 推出,评估智能体在真实网页环境中的任务完成能力和网页交互能力。
(3)多智能体协作评估
评估多个智能体协同工作的能力:
- ChatEval:评估多智能体对话系统的质量。
- SOTOPIA:评估智能体在社交场景中的互动能力。
- 自定义协作场景:根据具体应用场景设计的评估任务。
(4)常用评估指标
不同基准使用不同的评估指标,常见的包括:
- 准确性指标:Accuracy(准确率)、Exact Match(精确匹配)、F1 Score(F1 分数),用于衡量答案的正确性。
- 效率指标:Response Time(响应时间)、Token Usage(Token 使用量),用于衡量执行效率。
- 鲁棒性指标:Error Rate(错误率)、Failure Recovery(故障恢复),用于衡量容错能力。
- 协作指标:Communication Efficiency(通信效率)、Task Completion(任务完成度),用于衡量协作效果。
(1)评估体系概览
我们建立了一个三层评估体系,全面覆盖智能体的不同能力维度。首先是工具调用能力评估(BFCL),专注于评估智能体的函数调用准确性,包含 simple、multiple、parallel、irrelevance 四个类别,使用 AST 匹配技术进行精确评估。其次是通用能力评估(GAIA),评估智能体的综合问题解决能力,包含三个难度级别共 466 个真实世界问题,关注多步推理、工具使用、文件处理等能力。第三是数据生成质量评估(AIME),评估 LLM 生成数据的质量,使用 LLM Judge 和 Win Rate 两种方法,支持人工验证和综合报告生成,确保生成数据达到参考数据的质量标准。
(2)核心技术要点
在技术实现上,我们采用了六个核心技术要点。首先是模块化设计,评估系统采用三层架构:数据层(Dataset 负责数据加载和管理)、评估层(Evaluator 负责执行评估流程)和指标层(Metrics 负责计算各种评估指标)。其次是工具化封装,所有评估功能都封装成 Tool,可以被智能体直接调用、集成到工作流中或通过统一接口使用。第三是 AST 匹配技术,使用抽象语法树匹配函数调用,比简单字符串匹配更智能,能够忽略参数顺序、识别等价表达式和忽略格式差异。第四是多模态支持,GAIA 评估支持文本问题、附件文件和图片输入等多模态数据。第五是 LLM Judge 评估,使用 LLM 作为评委评估生成数据质量,提供多维度评分(正确性、清晰度、难度匹配、完整性)、自动化评估流程、详细评估报告,并支持自定义评估维度和标准。第六是 Win Rate 对比评估,通过成对对比评估生成质量(生成数据 vs 参考数据),由 LLM 判断哪个更好并计算胜率统计,接近 50%表示质量相当。
(3)扩展方向
基于本章的评估系统,你可以在四个方向上进行扩展。首先是添加新的评估基准,可以参考 BFCL 和 GAIA 的实现模式,实现 Dataset、Evaluator、Metrics 三个组件,并封装成 Tool 供使用。其次是自定义评估指标,在 Metrics 类中添加新的指标计算方法,根据具体应用场景设计指标。第三是集成到 CI/CD 流程,在代码提交时自动运行评估,设置性能阈值防止性能退化,生成评估报告并归档。第四是扩展数据生成评估,支持更多数据类型(代码、对话、文档等),添加更多评估维度(创新性、多样性等),集成更多参考数据集,支持多模型对比评估。