Harness Engineering
Intro
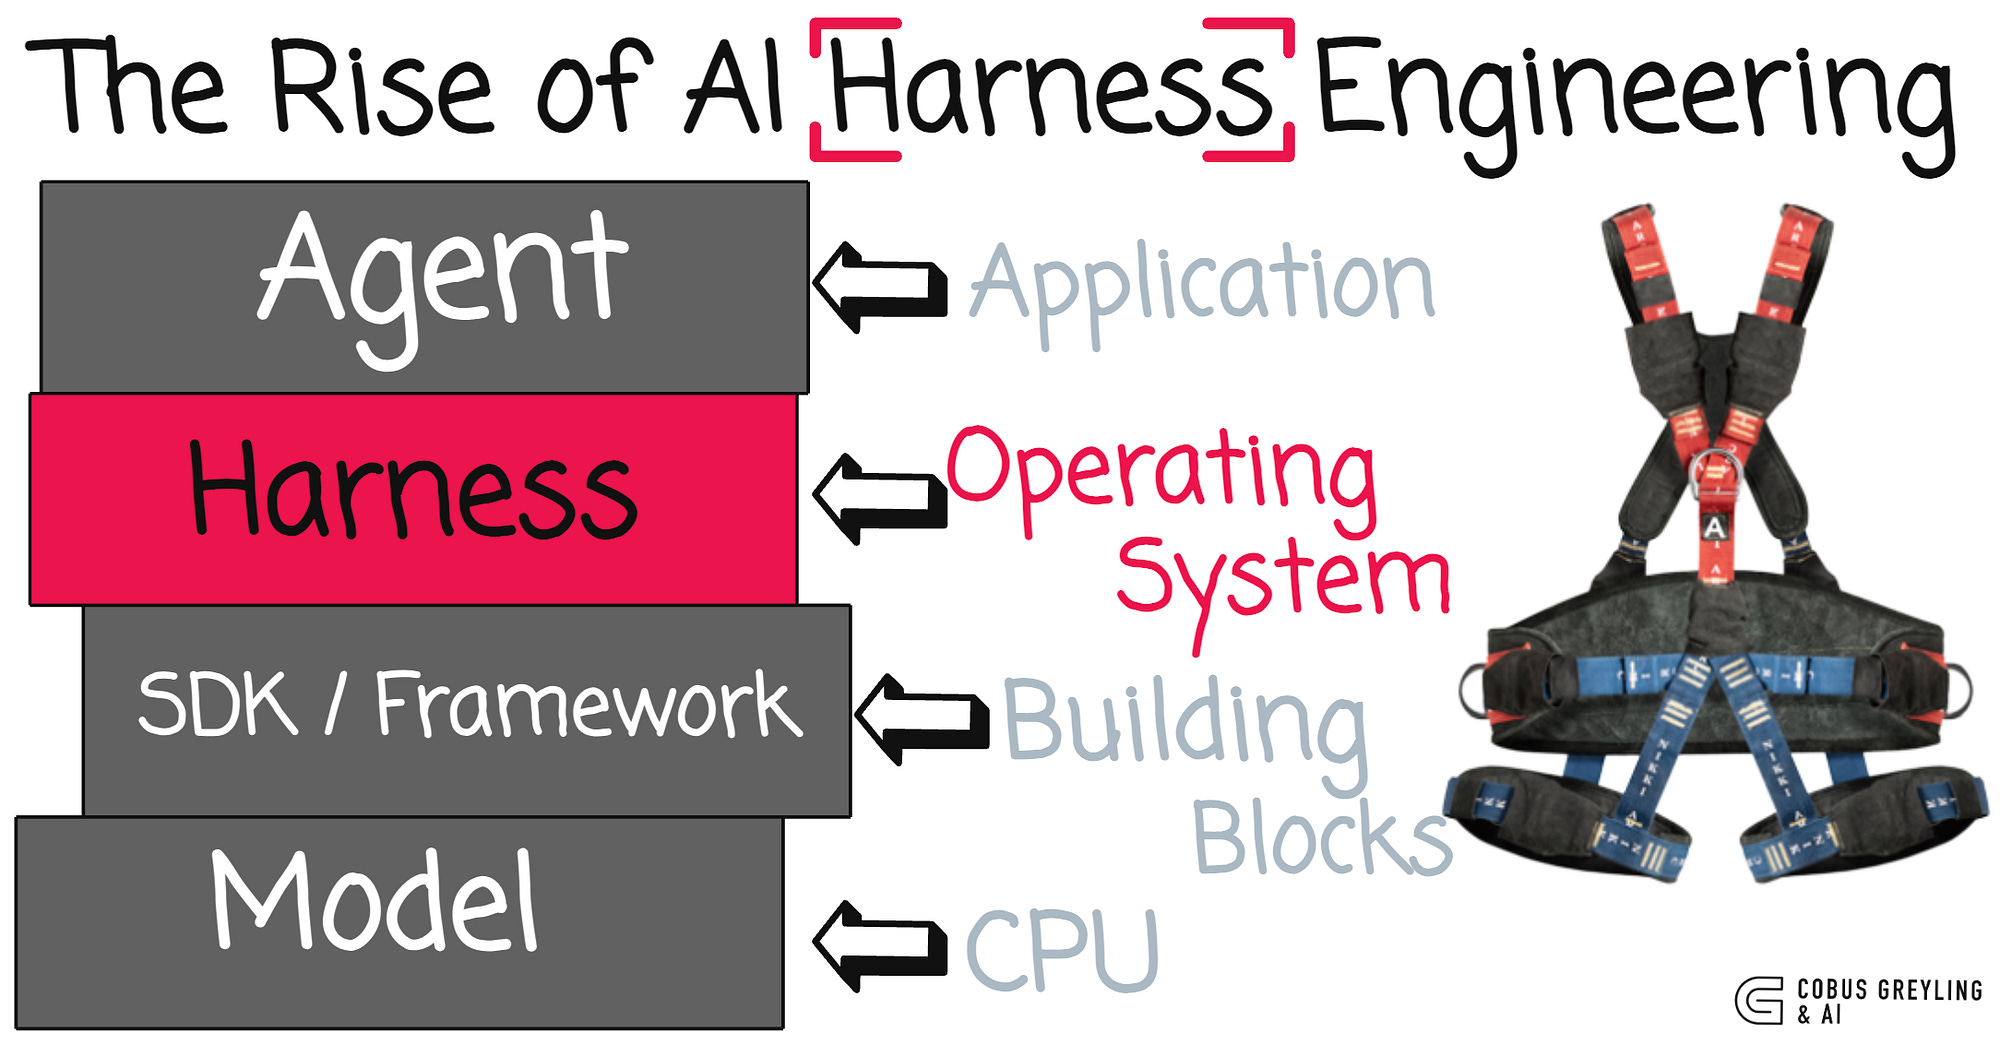
Harness = Tools + Knowledge + Observation + Action Interfaces + Permissions
    Tools:
          文件读写、Shell、网络、数据库、浏览器
    Knowledge:
      产品文档、领域资料、API 规范、风格指南
    Observation:
    git diff、错误日志、浏览器状态、传感器数据
    Action:
         CLI 命令、API 调用、UI 交互
    Permissions:
    沙箱隔离、审批流程、信任边界
模型做决策。Harness 执行。模型做推理。Harness 提供上下文。模型是驾驶者。Harness 是载具。
编程 agent 的 harness 是它的 IDE、终端和文件系统。 农业 agent 的 harness 是传感器阵列、灌溉控制和气象数据。酒店 agent 的 harness 是预订系统、客户沟通渠道和设施管理 API。Agent – 那个智能、那个决策者 – 永远是模型。Harness 因领域而变。Agent 跨领域泛化。
Claude Code = 一个 agent loop
            + 工具 (bash, read, write, edit, glob, grep, browser...)
            + 按需 skill 加载
            + 上下文压缩
            + 子 agent 派生
            + 带依赖图的任务系统
            + 异步邮箱的团队协调
            + worktree 隔离的并行执行
            + 权限治理
Agent = 模型(LLM) + 泛化的操作环境(Harness)。
核心模式
def agent_loop(messages):
    while True:
        response = client.messages.create(
            model=MODEL, system=SYSTEM,
            messages=messages, tools=TOOLS,
        )
        messages.append({"role": "assistant",
                         "content": response.content})
        if response.stop_reason != "tool_use":
            return
        results = []
        for block in response.content:
            if block.type == "tool_use":
                output = TOOL_HANDLERS[block.name](**block.input)
                results.append({
                    "type": "tool_result",
                    "tool_use_id": block.id,
                    "content": output,
                })
        messages.append({"role": "user", "content": results})
Agent Loop
问题
当提出了一个问题给大模型:“帮我读取下我的目录下有哪些文件,并且执行XXX.py”。模型能输出一条 bash 命令,但输出完了就停了,它不会自己跑,也不会看到结果后继续推理。可以手动跑一遍,把输出粘贴回对话框,让它接着干。下一个命令出来,再跑一遍、再贴回去。每一个来回,都在做中间层。所以用agent loop把这一过程自动化。
解决方案
一个 while True 循环,模型调用工具就继续,不调用就停。整个过程只有两个信号:
| 信号 | 含义 | 循环动作 |
|---|---|---|
| stop_reason == “tool_use” | 模型举手说”我要用工具” | 执行 → 结果喂回去 → 继续 |
| stop_reason != “tool_use” | 模型说”我做完了” | 退出循环 |
Tool Use
多加一个工具,只加一行代码。
| 概念 | 一句话 |
|---|---|
| TOOL_HANDLERS | 工具名 → 处理函数的字典。加工具 = 加一行映射 |
| 工具定义 | 告诉模型”我能做什么”的 JSON schema |
| 多工具调用 | 模型可一次返回多个 tool_use |
| 循环不变 | while True 循环一行都没改 |
Permission
执行前做权限判断
Hook
挂在循环上,不写在循环里。
Hook 事件
| 类别 | 事件 |
|---|---|
| 工具相关 | PreToolUse, PostToolUse, PostToolUseFailure |
| 会话相关 | SessionStart, SessionEnd, Stop, StopFailure, Setup |
| 用户交互 | UserPromptSubmit, Notification, PermissionRequest, PermissionDenied |
| 子 Agent | SubagentStart, SubagentStop |
| 压缩相关 | PreCompact, PostCompact |
| 团队相关 | TeammateIdle, TaskCreated, TaskCompleted |
| 其他 | Elicitation, ElicitationResult, ConfigChange, WorktreeCreate, WorktreeRemove, InstructionsLoaded, CwdChanged, FileChanged |
Hook result 常用字段摘录
| 字段 | 类型 | 用途 |
|---|---|---|
| message | Message | 可选 UI 消息 |
| blockingError | HookBlockingError | 阻塞错误 → 注入对话让模型自纠 |
| outcome | success/blocking/non_blocking_error/cancelled | 执行结果 |
| preventContinuation | boolean | 阻止后续执行 |
| stopReason | string | 停止原因描述 |
| permissionBehavior | allow/deny/ask/passthrough | hook 返回权限决策 |
| updatedInput | Record | 修改工具输入 |
| additionalContext | string | 附加上下文 |
| updatedMCPToolOutput | unknown | MCP 工具输出修改 |
Todowrite
问题
给 Agent 一个复杂任务:”把所有 Python 文件改成 snake_case 命名,然后跑测试,修好失败。”Agent 开始干活,改了 3 个文件,跑了个测试,发现 2 个失败,开始修。修着修着,它忘了最初是”改成 snake_case”,测试失败把注意力全吸走了。对话越长越严重:工具结果不断填满上下文,系统提示的影响力被稀释。一个 10 步重构,做完 1-3 步就开始即兴发挥,因为 4-10 步已经被挤出注意力了。
解决方案
todo_write 工具,接收一个带状态的列表,保存在当前进程内存中,同时在终端显示进度:
CURRENT_TODOS: list[dict] = []
def run_todo_write(todos: list) -> str:
    global CURRENT_TODOS
    CURRENT_TODOS = todos
    lines = ["\n## Current Tasks"]
    for t in CURRENT_TODOS:
        icon = {"pending": " ", "in_progress": "▸", "completed": "✓"}[t["status"]]
        lines.append(f"  [{icon}] {t['content']}")
    print("\n".join(lines))
    return f"Updated {len(CURRENT_TODOS)} tasks"
工具定义和其他 5 个工具一起加入 dispatch map:
TOOLS = [
    {"name": "bash",
       ...},
    {"name": "read_file",  ...},
    {"name": "write_file", ...},
    {"name": "edit_file",  ...},
    {"name": "glob",
       ...},
    # s05: 新增一条
    {"name": "todo_write", "description": "Create and manage a task list ...",
     "input_schema": {
         "type": "object",
         "properties": {
             "todos": {
                 "type": "array",
                 "items": {
                     "type": "object",
                     "properties": {
                         "content": {"type": "string"},
                         "status": {"type": "string", "enum": ["pending", "in_progress", "completed"]},
                     },
                 },
             },
         },
     },
    },
]
TOOL_HANDLERS["todo_write"] = run_todo_write
Nag reminder,模型连续 3 轮没调 todo_write 时,自动注入一条提醒:
if rounds_since_todo >= 3 and messages:
    messages.append({
        "role": "user",
        "content": "<reminder>Update your todos.</reminder>",
    })
    rounds_since_todo = 0
Agent 收到任务后的典型流程:先调 todo_write 列出所有步骤(全 pending)→ 做一个步骤,改成 in_progress → 做完改成 completed → 看下一个 pending → 继续。连续 3 轮没有调用 todo_write 时,循环会在下一次 LLM 调用前追加一条 reminder。
关键洞察:todo_write 不给 Agent 增加任何执行能力。它增加的是规划能力。
Subagent
大任务拆小。每次拿到的都是干净的上下文。
问题
Agent 在修一个 bug。它读了 30 个文件来追踪调用链,中间聊了 60 轮。messages 列表涨到 120 条,其中大部分是”追踪调用链”的中间过程,和”修 bug”这个最终目标无关。这些中间过程占着上下文位置,让 Agent 越来越”健忘”,它记不住最初的问题是什么了。
换个角度:修 bug 的时候,会”开一个新终端”来追踪调用链。追踪完了,终端关掉,结果写进笔记,回到原来的终端继续修 bug。Agent 也需要这个能力:开一个独立的子进程,给它一个独立的消息列表,让它专心做一件事。
工作原理
spawn_subagent,给子 Agent 一个全新的 messages 列表,跑自己的循环,只回传结论
def spawn_subagent(description: str) -> str:
    # 子 Agent 的工具:基础工具,但没有 task(禁止递归)
    sub_tools = [
        {"name": "bash", ...}, {"name": "read_file", ...},
        {"name": "write_file", ...}, {"name": "edit_file", ...},
        {"name": "glob", ...},
    ]
    messages = [{"role": "user", "content": description}]  # 全新 messages[]
    for _ in range(30):  # safety limit
        response = client.messages.create(
            model=MODEL, system=SUB_SYSTEM,
            messages=messages, tools=sub_tools, max_tokens=8000,
        )
        messages.append({"role": "assistant", "content": response.content})
        if response.stop_reason != "tool_use":
            break
        results = []
        for block in response.content:
            if block.type == "tool_use":
                blocked = trigger_hooks("PreToolUse", block)
                if blocked:
                    results.append({... "content": str(blocked)})
                    continue
                handler = SUB_HANDLERS.get(block.name)
                output = handler(**block.input) if handler else f"Unknown"
                trigger_hooks("PostToolUse", block, output)
                results.append({... "content": output})
        messages.append({"role": "user", "content": results})
    # 只返回最后的文本结论,中间过程全部丢弃
    return extract_text(messages[-1]["content"])
主 Agent 调用时,跟调其他工具一样:
TOOLS = [
    {"name": "bash", ...},
    {"name": "read_file", ...},
    {"name": "write_file", ...},
    {"name": "edit_file", ...},
    {"name": "glob", ...},
    {"name": "todo_write", ...},
    # s06: 新增 task 工具
    {"name": "task",
     "description": "Launch a subagent to handle a complex subtask. Returns only the final conclusion.",
     "input_schema": {"type": "object", "properties": {"description": {"type": "string"}}, "required": ["description"]}},
]
TOOL_HANDLERS["task"] = spawn_subagent
三个关键设计决策:
| 决策 | 选择 | 原因 |
|---|---|---|
| 上下文隔离 | 全新 messages[] | 子 Agent 的中间过程不污染主 Agent 的上下文 |
| 只回传结论 | extract_text(last_message) | 不是回传整个 messages 列表 |
| 禁止递归 | 子 Agent 无 task 工具 | 防止子 Agent 再 spawn 新的子 Agent |
| 安全策略不跳过 | 子 Agent 工具调用也走 PreToolUse hook | 上下文隔离不代表权限隔离 |
dispatch 机制不变,task 工具通过 TOOL_HANDLERS[block.name] 分发。子 Agent 有独立的 SUB_SYSTEM 提示,明确要求”直接完成任务,不要再委派”。
Skill
问题
你的项目有一套 React 组件规范、一份 SQL 风格指南、一份 API 设计文档。你希望 Agent 自动遵守这些规范。最直接的想法,全塞进 system prompt:
SYSTEM = (
    f"You are a coding agent. "
    + open("docs/react-style.md").read()
       # 2000 行
    + open("docs/sql-style.md").read()
         # 1500 行
    + open("docs/api-design.md").read()
        # 3000 行
)
6500 行 system prompt。Agent 每次调用 LLM 都带着这些文档——不管是在改 CSS 颜色还是修 SQL 查询。99% 的内容和当前任务无关,白白消耗 token。
解决方案
两层设计:
| 层 | 位置 | 时机 | 代价 |
|---|---|---|---|
| 1. 目录 | system prompt | 启动时注入(harness 扫描 skills/) | ~100 tokens/skill,每轮都带 |
| 2. 内容 | tool_result | Agent 调用 load_skill 时;SKILL.md 可指引后续的 read_file/bash 调用,用于按需访问额外资源 | ~2000 tokens/skill,按需 |
dispatch 机制不变,load_skill 通过 TOOL_HANDLERS[block.name] 分发。
实现原理
skills/ 目录,每个技能一个子目录,包含 SKILL.md 文件:
skills/
  agent-builder/SKILL.md
  code-review/SKILL.md
  mcp-builder/SKILL.md
  pdf/SKILL.md
第一级:启动时注入目录:harness 启动时调用 _scan_skills() 扫描 skills/ 目录,解析每个 SKILL.md 的 YAML frontmatter(name、description),存入 SKILL_REGISTRY 字典。list_skills() 从注册表生成目录,注入 SYSTEM prompt。Agent 每轮都能看到”我有哪些技能可用”,不花额外 API 调用:
SKILL_REGISTRY: dict[str, dict] = {}
def _scan_skills():
    if not SKILLS_DIR.exists():
        return
    for d in sorted(SKILLS_DIR.iterdir()):
        if not d.is_dir():
            continue
        manifest = d / "SKILL.md"
        if manifest.exists():
            raw = manifest.read_text()
            meta, body = _parse_frontmatter(raw)
            name = meta.get("name", d.name)
            desc = meta.get("description", raw.split("\n")[0].lstrip("#").strip())
            SKILL_REGISTRY[name] = {"name": name, "description": desc, "content": raw}
_scan_skills()  # runs once at startup
def list_skills() -> str:
    return "\n".join(f"- **{s['name']}**: {s['description']}" for s in SKILL_REGISTRY.values())
def build_system() -> str:
    catalog = list_skills()
    return (
        f"You are a coding agent at {WORKDIR}. "
        f"Skills available:\n{catalog}\n"
        "Use load_skill to get full details when needed."
    )
SYSTEM = build_system()
第二级:load_skill:Agent 决定”我需要 SQL 风格指南”,调用 load_skill(“sql-style”)。通过注册表查找,不走文件路径,没有路径遍历风险。SKILL.md 内容通过 tool_result 注入,并可通过现有的 file 和 bash 工具进一步访问引用的 references/、scripts/ 或 assets/。
def load_skill(name: str) -> str:
skill = SKILL_REGISTRY.get(name)
if not skill:
return f"Skill not found: {name}"
return skill["content"]
关键区别:技能内容不是 system prompt 的一部分,它作为一次工具结果进入当前 messages。后续调用会随历史一起携带,直到上下文压缩、截断或会话结束。这和 s08 的 compact 自然衔接:按需加载解决了”不该提前带的不要带”,compact 解决”该丢的怎么丢”。
SKILL.md frontmatter 常见字段
CC 的 SKILL.md YAML frontmatter 由 parseSkillFrontmatterFields() 解析(loadSkillsDir.ts),常见字段包括:
| 字段 | 用途 |
|---|---|
| name / description | 显示名称和描述 |
| when_to_use | 指导模型何时调用 |
| allowed-tools | 技能可用工具的自动允许列表 |
| context | inline(默认)或 fork(作为子 Agent 运行) |
| model | 模型覆盖(haiku/sonnet/opus/inherit) |
| hooks | 技能级别的 hook 配置 |
| paths | 条件激活的 glob 模式 |
| user-invocable | 用户可以通过 /name 调用 |
Compact
问题
Agent 跑着跑着,不动了。手里有 bash、有 read、有 write,能力是够的。但它读了一个 1000 行的文件(~4000 token),又读了 30 个文件,跑了 20 条命令。每条命令的输出、每个文件的内容,全都堆在 messages 列表里。上下文窗口是有限的。满了之后,API 直接拒绝:prompt_too_long。不压缩,Agent 根本没法在大项目里干活。
L1: snip_compact — 裁掉无关的旧对话
Agent 跑了 80 轮对话,messages 攒了 160 条。最前面的”帮我创建 hello.py”和当前工作几乎无关了,但全占着位置。
消息数超过 50 条 → 保留头部 3 条(初始上下文)和尾部 47 条(当前工作),中间裁掉;唯一额外边界条件是,不能把 assistant(tool_use) 和后面的 user(tool_result) 拆开
def snip_compact(messages, max_messages=50):
    if len(messages) <= max_messages:
        return messages
    head_end, tail_start = 3, len(messages) - (max_messages - 3)
    if _message_has_tool_use(messages[head_end - 1]):
        while head_end < len(messages) and _is_tool_result_message(messages[head_end]):
            head_end += 1
    if _is_tool_result_message(messages[tail_start]) and _message_has_tool_use(messages[tail_start - 1]):
        tail_start -= 1
    snipped = tail_start - head_end
    placeholder = {"role": "user", "content": f"[snipped {snipped} messages from conversation middle]"}
    return messages[:head_end] + [placeholder] + messages[tail_start:]
裁掉的是消息本身,只是在切口处多做一步保护;剩下的消息里 tool_result 内容仍在累积——第 34 条消息里可能躺着 30KB 的旧文件内容。→ L2。
L2: micro_compact — 旧工具结果占位
Agent 连续读了 10 个文件。第 1-7 次的完整内容还躺在上下文里,早就不需要了,但占着大量空间。只保留最近 3 条 tool_result 的完整内容,更旧的替换为一行占位符:
KEEP_RECENT_TOOL_RESULTS = 3
def micro_compact(messages):
    tool_results = collect_tool_result_blocks(messages)
    if len(tool_results) <= KEEP_RECENT_TOOL_RESULTS:
        return messages
    for _, _, block in tool_results[:-KEEP_RECENT_TOOL_RESULTS]:
        if len(block.get("content", "")) > 120:
            block["content"] = "[Earlier tool result compacted. Re-run if needed.]"
    return messages
旧结果清掉了,但单条新结果可能就有 500KB——一个 cat 大文件的输出就能打满上下文。→ L3。
L3: tool_result_budget — 大结果落盘
模型一次读了 5 个大文件,单条 user 消息里所有 tool_result 加起来 500KB。
统计最后一条 user 消息里所有 tool_result 的总大小。超过 200KB → 按大小排序,从最大的开始落盘到 .task_outputs/tool-results/,上下文里只留
def tool_result_budget(messages, max_bytes=200_000):
    last = messages[-1]
    blocks = [(i, b) for i, b in enumerate(last["content"])
              if b.get("type") == "tool_result"]
    total = sum(len(str(b.get("content", ""))) for _, b in blocks)
    if total <= max_bytes:
        return messages
    ranked = sorted(blocks, key=lambda p: len(str(p[1].get("content", ""))), reverse=True)
    for idx, block in ranked:
        if total <= max_bytes:
            break
        block["content"] = persist_large_output(block["tool_use_id"], str(block["content"]))
        total = recalculate_total(blocks)
    return messages
前三层都是纯文本/结构操作,0 API 调用,但也无法”理解”对话内容。上下文可能仍然太大。→ L4。
L4: compact_history — LLM 全量摘要
前三层全跑完了,但在超大项目中连续工作 30 分钟后,token 仍然超过阈值。
三步流程:
- 保存 transcript:完整对话写入 .transcripts/,JSONL 格式。transcript 保留了可恢复记录,但模型的活跃上下文里只剩摘要。对模型当下推理来说,细节已经不在上下文中了。教学代码没有提供 transcript 检索工具。
- LLM 生成摘要:把对话历史发给 LLM,要求保留当前目标、重要发现、已改文件、剩余工作、用户约束等关键信息。
- 替换消息列表:所有旧消息被替换为一条摘要。教学版只保留摘要;真实 Claude Code 会在 compact 后重新附加部分最近文件、计划、agent/skill/tool 等上下文。
def compact_history(messages):
    transcript_path = write_transcript(messages)  # 先保存完整对话
    summary = summarize_history(messages)
          # LLM 生成摘要
    return [{"role": "user",
             "content": f"[Compacted]\n\n{summary}"}]
熔断器:连续失败 3 次后停止重试,防止死循环浪费 API 调用。
应急: reactive_compact
有时候 API 还是返回 prompt_too_long(413),上下文增长速度快于压缩触发速度时。
这时触发 reactive_compact:比 compact_history 更激进,从尾部回退,但仍要避免留下孤立 tool_result。
def reactive_compact(messages):
    transcript = write_transcript(messages)
    summary = summarize_history(messages)
    tail_start = max(0, len(messages) - 5)
    if _is_tool_result_message(messages[tail_start]) and _message_has_tool_use(messages[tail_start - 1]):
        tail_start -= 1
    return [{"role": "user",
             "content": f"[Reactive compact]\n\n{summary}"}, *messages[tail_start:]]
reactive compact 有重试上限(默认 1 次)。再失败就抛出异常,不无限循环。
合起来跑
def agent_loop(messages):
    reactive_retries = 0
    while True:
        # 三个预处理器(0 API 调用)
        # 顺序:budget 先跑,确保大内容落盘后再做占位和裁剪
        messages[:] = tool_result_budget(messages)
    # L3: 大结果落盘
        messages[:] = snip_compact(messages)
          # L1: 裁中间
        messages[:] = micro_compact(messages)
         # L2: 旧结果占位
        # 还不够?LLM 摘要(1 API 调用)
        if estimate_token_count(messages) > THRESHOLD:
            messages[:] = compact_history(messages)
        try:
            response = client.messages.create(...)
        except PromptTooLongError:
            if reactive_retries < MAX_REACTIVE_RETRIES:
                messages[:] = reactive_compact(messages)  # 应急
                reactive_retries += 1
                continue
            raise  # 超过重试上限,抛出异常
        # ... 工具执行 ...
        # compact 工具:模型主动调用时触发 compact_history
        if block.name == "compact":
            messages[:] = compact_history(messages)
            results.append({..., "content": "[Compacted. History summarized.]"})
            messages.append({"role": "user", "content": results})
            break  # 结束当前 turn,用压缩后的上下文开始新一轮
顺序不能换。 L3(budget)在 L2(micro)前面,因为 micro 会把旧的大 tool_result 替换成一行占位符,budget 必须在那之前把完整内容落盘。这也是为什么 CC 源码把 applyToolResultBudget 放在最前面。
完整常量参考
| 常量 | 值 | 源文件 |
|---|---|---|
| AUTOCOMPACT_BUFFER_TOKENS | 13,000 | autoCompact.ts:62 |
| MAX_CONSECUTIVE_AUTOCOMPACT_FAILURES | 3 | autoCompact.ts:70 |
| MAX_OUTPUT_TOKENS_FOR_SUMMARY | 20,000 | autoCompact.ts:30 |
| POST_COMPACT_TOKEN_BUDGET | 50,000 | compact.ts:123 |
| POST_COMPACT_MAX_FILES_TO_RESTORE | 5 | compact.ts:122 |
| POST_COMPACT_MAX_TOKENS_PER_FILE | 5,000 | compact.ts:124 |
| 时间 micro_compact 间隔 | 60 分钟 | timeBasedMCConfig.ts |
| MAX_COMPACT_STREAMING_RETRIES | 2 | compact.ts:131 |
Memory
压缩会丢细节,要有一层不丢的。
Memory适合保存什么:
Memory 保存跨会话仍然有用的信息:用户偏好、反复出现的反馈、项目背景、常用入口和排查线索。它关注“以后还会用到什么”,并通过索引 + 按需加载把这些信息带回当前对话。session memory 关注同一会话内的连续性:compact 之后,当前会话还需要保留哪些上下文。两者配合使用:Memory 管长期知识,session memory 管当前会话的压缩续接。
System Prompt
Harness 层: 运行时组装, 不硬编码。
System prompt 应该是运行时根据当前状态组装的配置:哪些工具启用、哪些上下文可见、哪些记忆相关、哪些内容必须保持稳定以命中 prompt cache。
四个 section,两种加载策略:
| Section | 加载策略 | 内容 | 判断依据 |
|---|---|---|---|
| identity | 始终 | 你是谁、怎么做事 | 始终存在 |
| tools | 始终 | 可用工具列表 | enabled_tools |
| workspace | 始终 | 工作目录 | 始终存在 |
| memory | 按需 | 相关记忆内容 | .memory/MEMORY.md 是否存在 |
关键设计:section 是否加载取决于真实状态(工具是否存在、文件是否存在),不是消息里的关键词。
CC的system prompt 有多少section
数量不固定,受 feature flag、output style、KAIROS/Proactive 模式、用户类型、token 预算等影响。大致分两类:
静态 section(始终加载):identity、system、doing_tasks、actions、using_tools、tone_style、output_efficiency 等。
动态 section(按状态加载):session_guidance、memory、ant_model_override、env_info_simple、language、output_style、mcp_instructions、scratchpad、frc、summarize_tool_results、numeric_length_anchors、token_budget、brief 等。
mcp_instructions 是唯一的易失性 section(通过 DANGEROUS_uncachedSystemPromptSection() 创建),因为 MCP server 可以在轮次间连接和断开。
cache scope
启用 global cache boundary 时,静态 section 合并成一个 global cache block,动态 section 不使用 global cache(cacheScope: null)。没有 boundary 或跳过 global cache 的路径才会走 org scope。
CC 的三层缓存:
- lodash memoize:getSystemContext 和 getUserContext 在会话中缓存(context.ts)
- section 注册缓存:STATE.systemPromptSectionCache 缓存动态 section 结果,/clear 或 /compact 时清除
- API 级缓存:splitSysPromptPrefix()(api.ts)把 prompt 按 boundary 分成不同 cache scope 的块
getUserContext vs getSystemContext
| getSystemContext | getUserContext | |
|---|---|---|
| 内容 | gitStatus、cacheBreaker | CLAUDE.md 内容、currentDate |
| 注入方式 | 追加到 system prompt 数组 | 前置为 |
| 何时跳过 | 自定义 system prompt 时 | 始终运行 |
模式如何改变 prompt
- CLAUDE_CODE_SIMPLE:整个 prompt 只有 2 行
- Proactive/KAIROS:用紧凑版 prompt 替换所有标准 section
- Coordinator:用协调器专用 prompt 完全替换
- Agent 模式:Agent 定义的 prompt 替换或追加到默认 prompt
总大小
标准交互模式下 system prompt 核心约 20-30KB 文本。CLAUDE_CODE_SIMPLE 约 150 字符。用户上下文(CLAUDE.md)和系统上下文(git status)在此基础上累加。
Error Recovery
Harness 层: 韧性 — 主循环遇到错误时分类并恢复。
Agent 跑着跑着报错了:
Error: 529 overloaded
Agent 崩溃了。它没有重试,没有换模型,没有减少上下文——直接崩溃。
生产环境中 API 错误是常态。三种最常见的故障模式:输出被截断(模型话说一半 token 用完了)、上下文超限(压缩后还是太长)、临时故障(429 限流 / 529 过载)。一个不处理错误的 Agent 就像一个一碰就熄火的车。
CC的reason/transition
CC 实际有十几种 reason/transition,每轮 LLM 调用后都会判断:
| reason/transition | CC 行为 |
|---|---|
| completed | 返回结果 |
| next_turn | 继续下一轮工具执行 |
| max_output_tokens_escalate | 8K→64K 升级 |
| max_output_tokens_recovery | 续写提示(最多 3 次) |
| reactive_compact_retry | reactive compact → 重试 |
| prompt_too_long | 同上 |
| collapse_drain_retry | context collapse 先提交暂存 |
| model_error | 重试 |
| image_error | ImageSizeError / ImageResizeError 专门处理 |
| aborted_streaming | 流式中止恢复 |
| aborted_tools | 工具中止 |
| stop_hook_blocking | 注入 blocking error → 模型自纠 |
| stop_hook_prevented | hooks 阻止 |
| hook_stopped | hook 停止执行 |
| token_budget_continuation | token 用量 < 90% 时继续 |
| blocking_limit | 阻塞限制 |
| max_turns | 达到最大轮次 |
ONTINUATION 提示原文
CC 的续写提示(query.ts:1225-1227):
Output token limit hit. Resume directly — no apology, no recap of what
you were doing. Pick up mid-thought if that is where the cut happened.
Break remaining work into smaller pieces.
Token budget 的 nudge 提示(tokenBudget.ts:72):
Stopped at {pct}% of token target. Keep working — do not summarize.
Task System
目标太大,拆成子任务,持久化的目标,可恢复的进度。
TodoWrite vs Task System:
| TodoWrite | Task System | |
|---|---|---|
| 定位 | 当前任务的执行清单 | 可恢复的任务系统 |
| 存储 | 进程内 / 会话状态 | .tasks/{id}.json |
| 依赖 | 无 | blockedBy / blocks 依赖图 |
| 生命周期 | 当前会话 / 当前任务 | 跨会话保留 |
| 分工 | 不负责任务认领 | owner / claim |
| 状态 | pending / in_progress / completed | pending / in_progress / completed |
| 粒度 | Agent 自己的步骤 | 可被认领、追踪、解锁的任务 |
TaskRecord字段
| 字段 | 类型 | 用途 |
|---|---|---|
| id | string | 递增整数 ID |
| subject | string | 简短标题 |
| description | string | 自由格式描述 |
| activeForm | string? | 进行时态,in_progress 时在 spinner 显示 |
| owner | string? | 分配的 agent ID |
| status | pending/in_progress/completed | 生命周期 |
| blocks | string[] | 此任务阻塞的任务 ID(下游) |
| blockedBy | string[] | 阻塞此任务的任务 ID(上游) |
| metadata | Record? | 任意扩展键值对 |
存储位置:~/.claude/tasks/{taskListId}/{id}.json。每个任务一个文件。
Background Task
Harness 层: 后台 — 异步执行, 不阻塞主循环。
同步 vs 后台:
| 同步 | 后台 | |
|---|---|---|
| 慢操作 | Agent 干等 | 后台线程执行 |
| Agent 空闲 | 是 | 否,继续处理 |
| 结果 | 立即返回 | 下轮注入通知 |
| 判断标准 | — | run_in_background 参数(模型显式请求),启发式兜底 |
Cron Scheduler
Harness 层: 调度 — 独立线程判断时间, 队列传递触发。
手动 vs 定时:
| 手动触发 | 定时触发 | |
|---|---|---|
| 触发者 | 用户输入 | 调度线程 |
| 触发时机 | 随时 | cron 表达式指定 |
| 需要人参与 | 是 | 否(调度器自动入队,空闲时自动交付) |
| 持久性 | — | durable 跨重启 |
工作原理
四层模型
Cron 调度分四层:
- Scheduler:daemon 线程,每秒轮询,判断时间到了没有
- Queue:cron_queue,调度线程写入已触发任务
- Queue Processor:发现队列非空且 Agent 空闲,启动一轮 agent_loop
- Consumer:agent_loop 从队列消费,注入到 messages
Agent Team
Harness 层: 团队 — 多 Agent 协作, 消息总线。
子 Agent vs 队友:
| 子 Agent | 队友 | |
|---|---|---|
| 生命周期 | 一次性,用完销毁 | 多轮(真实 CC 用 idle loop) |
| 通信 | 只回传结论 | 异步收件箱,随时通信 |
| 上下文 | 完全隔离 | 通过消息共享信息 |
| 数量 | 一个主 Agent + 偶尔子 Agent | 一个 Lead + 多个队友 |
CC 的团队通信有 15 种结构化消息(teammateMailbox.ts):
| 类型 | 方向 | 用途 |
|---|---|---|
| plain text | 双向 | 普通队友间通信 |
| idle_notification | 队友→Lead | 队友完成一轮工作,进入空闲 |
| permission_request | 队友→Lead | 队友需要操作审批 |
| permission_response | Lead→队友 | Lead 审批结果 |
| plan_approval_request | 队友→Lead | 队友提交计划待审 |
| plan_approval_response | Lead→队友 | Lead 审批计划 |
| shutdown_request | Lead→队友 | 请求体面关机 |
| shutdown_approved | 队友→Lead | 确认关机 |
| shutdown_rejected | 队友→Lead | 拒绝关机(附原因) |
| task_assignment | Lead→队友 | 分配任务 |
| team_permission_update | Lead→队友 | 广播权限变更 |
| mode_set_request | Lead→队友 | 修改队友的权限模式 |
| sandbox_permission_* | 双向 | 网络权限请求/回复 |
| teammate_terminated | 系统 | 队友被移除通知 |
文本消息被包装在
权限冒泡:双向轮询
- 队友遇到需要审批的操作 → 发 permission_request 到 Lead 的收件箱
- Lead 的 useInboxPoller(每 1 秒轮询)检测到请求 → 路由到 ToolUseConfirmQueue
- Lead 的 UI 显示审批对话框,带队友名字和颜色
- 用户审批后 → Lead 发 permission_response 回队友的收件箱
- 队友的 useSwarmPermissionPoller(每 500ms 轮询)收到回复 → 继续或拒绝执行
队友生命周期
CC 的队友由 spawnTeammate()(spawnMultiAgent.ts)创建:
- Spawn:创建 tmux 窗格(或进程内),分配颜色,写入 team config
- Work:useInboxPoller 每 1 秒检查收件箱 → 有消息就提交为新的 turn
- Idle:Stop hook 触发 → 发 idle_notification 给 Lead
- Shutdown:Lead 发 shutdown_request → 队友回复 shutdown_approved → Lead 清理
Team Protocols
关机协议:CC 的 shutdown 是三向通信(teammateMailbox.ts:720-763、SendMessageTool.ts:268-430)。Lead 发 shutdown_request,队友回复 shutdown_approved(或 shutdown_rejected 附原因),系统发送 teammate_terminated 通知所有相关方。关机确认后系统自动清理 pane(tmux/iTerm2)、unassign 任务、从 team config 移除成员(useInboxPoller.ts:677-800)。教学版用 shutdown_response 统一命名,真实源码拆成 approved/rejected 两种独立消息。
计划审批:真实源码里 plan approval request 由 ExitPlanModeV2Tool.ts:263-312 在 plan-mode-required 队友退出 plan mode 时产生。useInboxPoller.ts:599-661 当前会自动回写 approval,并把请求交给 Lead 作为上下文(regular message)。SendMessageTool.ts:434-518 仍保留显式 approve/reject response 能力,审批时可同时设置 permissionMode(如”批准但以 plan mode 运行”),响应中可包含 feedback 字符串供队友修正后重新提交。不是简单的”Lead 手动 review_plan 工具”流程。
消息格式:CC 的协议消息是结构化的 JSON(有 Zod schema 验证),教学版用简单的 type + metadata 字典。字段名也不统一:permission 用 request_id(teammateMailbox.ts:453-462),shutdown 和 plan approval 用 requestId(teammateMailbox.ts:684-763)。
执行门控:CC 的队友有完整的 permission gating。未获批准的高风险操作会被拦截,不是可选的。教学版只演示了消息流程,没有实现执行拦截。
| 通用性:教学版的一个 FSM(pending → approved | rejected)对应两种协议,这个简化完全正确。CC 的所有协议消息共用同一个 request id 关联机制。 |
Autonomous Agent
Harness 层: 自治 — 队友自组织,不依赖 Lead 分配。
CC的空闲机制
idle_notification:队友完成一轮工作后,sendIdleNotification()(inProcessRunner.ts:569-589)向 Lead 发送空闲通知。Lead 知道队友可用了,可以分配新任务或请求关机。
mailbox 轮询:waitForNextPromptOrShutdown()(inProcessRunner.ts:689-868)是一个 500ms 轮询循环,持续检查三类来源:pending user messages、mailbox 文件消息、task list。shutdown_request 被优先处理(inProcessRunner.ts:768-804),不会被普通消息饿死。
task watcher:useTaskListWatcher(hooks/useTaskListWatcher.ts:34-189)用 fs.watch() 监听 .claude/tasks/ 目录变化,1 秒 debounce,当新任务创建或依赖解锁时触发检查。依赖判断(L197-207)是”blockedBy 中没有未完成的任务”,不是”blockedBy 为空”。
主动 claim:轮询循环内部也会调用 tryClaimNextTask()(inProcessRunner.ts:853-860)——在等待期间主动从 task list 领取任务。所以”队友不主动轮询任务”不准确,CC 同时有被动通知和主动认领。
任务认领:文件锁+原子操作
claimTask()(utils/tasks.ts:541-612)用 proper-lockfile 的任务文件锁,在锁内完成读-检查-改-写。检查项:owner 是否已存在(L575-576)、是否已完成(L580-581)、blockedBy 中是否有未完成任务(L585-594)。claimTaskWithBusyCheck()(utils/tasks.ts:614-692)用 task-list 级别锁,把 busy check 和 claim 做成原子操作,避免 TOCTOU。
findAvailableTask()(inProcessRunner.ts:595-604)的依赖判断也是”所有 blockedBy 已完成”,用 task.blockedBy.every(id => !unresolvedTaskIds.has(id)) 实现。tryClaimNextTask()(inProcessRunner.ts:624-657)在认领后把状态更新为 in_progress,让 UI 立即反映变化。
Worktree Isolation
Harness 层: 隔离 — 并行执行的目录隔离。
CC 的 worktree 系统有两条路径:EnterWorktree(当前会话切入)和 AgentTool isolation(子 agent 隔离)。
EnterWorktree:当前会话切换
EnterWorktreeTool.ts:92-97 创建 worktree 后立即 process.chdir(worktreePath)、setCwd()、setOriginalCwd()、saveWorktreeState()。当前会话的工作目录直接切换到 worktree——不是 prompt 提醒,而是进程级目录变更。
ExitWorktreeTool.ts:261-320 的 keep/remove 都会 restoreSessionToOriginalCwd() 恢复原目录。Remove 时检查未提交改动(ExitWorktreeTool.ts:190-220),没有 discard_changes: true 就拒绝删除。
AgentTool isolation:子 agent 隔离
AgentTool.tsx:590-641 在 isolation: “worktree” 时调用 createAgentWorktree() 创建 worktree,用 cwdOverridePath 包住子 agent 执行。子 agent 的所有操作自动在 worktree 目录下进行。AgentTool/prompt.ts:272 告诉模型:这是临时 worktree,无改动自动清理,有改动返回路径和分支。
worktree.ts:902-951 的 createAgentWorktree() 不修改全局 session cwd,只给子 agent 用。worktree.ts:961-1020 的 removeAgentWorktree() 从主 repo root 删除。
name 校验
worktree.ts:76-84 校验 slug:拒绝 ./..,允许 [a-zA-Z0-9._-]。worktree.ts:48 定义 VALID_WORKTREE_SLUG_SEGMENT。教学版的 validate_worktree_name 用同样的规则。
路径和分支命名
真实路径是 .claude/worktrees/,分支名 worktree-{slug}(worktree.ts:204-227,斜杠用 + 替代)。教学版用 .worktrees/ 和 wt/{name} 简化。
创建时用 git worktree add -B(worktree.ts:326-328),优先基于 origin/
状态管理
CC 没有 task-worktree 绑定。Worktree 状态通过 PersistedWorktreeSession(worktree.ts:756-768)管理,字段包括 originalCwd、worktreePath、worktreeName、worktreeBranch、originalBranch、originalHeadCommit、sessionId 等——没有 taskId。saveWorktreeState()(sessionStorage.ts:2883-2920)以 type: ‘worktree-state’ 写入 session transcript。
教学版用 task 的 worktree 字段做绑定,是教学简化。CC 把 worktree 和 task 作为两个独立系统,通过 Agent 理解上下文来关联。
MCP Plugin
CC 支持 6 种传输(types.ts:23-25):
| Transport | 通信方式 |
|---|---|
| stdio | 子进程 stdin/stdout(跨平台默认) |
| sse | HTTP Server-Sent Events |
| http | Streamable HTTP(POST/SSE 双向) |
| ws | WebSocket |
| sse-ide | IDE 内嵌 SSE 传输 |
| sdk | 进程内 SDK 传输 |
连接时本地(stdio)和远程(http/sse/ws)服务器分批并发:本地批量 3 个,远程批量 20 个。
Comprehensive Agent
机制很多,但是循环只有一个。
一个完整的harness:
用户输入
  → UserPromptSubmit hooks
  → cron/background 通知注入
  → context compact
  → memory + skills + MCP 状态组装 system prompt
  → LLM
  → has tool_use block?
      否 → Stop hooks → 返回
      是 → PreToolUse hooks + permission
          → TOOL_HANDLERS / MCP handlers / background dispatch
          → PostToolUse hooks
          → tool_result / task_notification 回 messages
          → 下一轮